 大讲堂

2026年3月的行业瓜,现在想起来还离谱。
某头部视频大模型公司,要训1.2万亿参数的多模态基座。
没买新卡。
没在核心IDC租机柜。
他们把散在全国17个城市边缘机房的12743张闲置GPU——就是平时给短视频做转码、给直播推流做加速,闲时GPU利用率不到12%的那些盒子——全部串起来,凑了个万卡集群。
训完整个模型,总花了2100万。
同行炸了。
有人骂他破坏行业规矩,说本来大家都要花大价钱买新卡、建新集群,他倒好,把本来要进新集群的订单给搅黄了。有人算过账,这套分布式集群的总算力,要是按传统模式新建,光硬件采购就要7.6亿,相当于这家公司3年的全部营收。跑满一个月的总电费是128万,比同规模集中式集群省下来的钱,够在上海徐汇区付一套小两居的首付。
更气人的是,他训出来的模型,在国内权威视频生成榜单上排第一,比那些花了几个亿建的集中式集群训出来的模型,画面连贯性还高2%。
2026年那桩万卡集群“挪用案”
最开始圈内人都觉得这是投机取巧。毕竟从2016年AlphaGo开始,大家对大模型训练的固有印象就是:必须把所有GPU堆在一个恒温恒湿的核心IDC里,网络延迟压到微秒级,才能跑得起万卡集群。那种散在各个城市的、网络跳来跳去的分布式节点,一跑训练就丢包,根本不稳定。
结果人家跑通了。不仅没丢包,还把整个训练过程的任务调度延迟压到了跟集中式集群差不多的水平。说白了,之前大家觉得分布式算不了大模型,根本不是技术不行,是之前的调度软件太烂——你把每个节点的任务拆的足够小,就算某一个节点突然断网,大不了把这个小任务挪到旁边的节点上接着跑,根本不会影响整个训练进度。
说实话,我2023年跟某头部云厂商的技术负责人喝酒,他还拍着桌子说“分布式算力都是垃圾,训不了千亿参数模型”。结果2025年他们自己把30%的非核心训练任务,挪到了分布式的边缘节点上。这脸打的,我现在想起来还觉得好笑。
卷不动的重资产,才是分布式的真土壤
很多人没搞懂,为什么这两年分布式计算突然火了。根本不是什么技术突破了,是大家卷不动重资产了。
之前国内的云厂商、AI公司,拼的就是谁建的智算中心大,谁买的卡多。2023年到2024年,全国光立项的智算中心项目,总投资就超过了6000亿。结果呢?现在国内整个智算中心的GPU平均利用率不到35%,算下来全国一年闲置的算力价值超过3200亿,相当于贵州省2025年全省GDP的1/10。
说穿了,这跟军事战术的演变逻辑一模一样。二战时期的德军迷信集中装甲集群的闪电战,觉得只要把所有坦克、火炮堆在一个突破点上,就能横推整个欧洲。但现代战争里,谁还敢把所有兵力堆在一个阵地上?那不是等着对方的精确制导炸弹给你一锅端吗?分布式计算的本质,就是把你之前堆在核心IDC的算力集群,拆成几千个分散在各个城市的小节点,就算某一个节点断网、宕机、被雷击,整个集群的训练任务根本不会受影响,不会像之前那样,核心集群一断,几个亿的训练任务直接前功尽弃。
中国本土的玩家,其实早就摸透了这个逻辑。火山引擎2025年推的“边缘算力共享计划”,就是把全国300多个城市的边缘机房里,那些平时做短视频转码、直播加速的闲置GPU,全部打包成可调度的算力池。上线半年,这个平台上的总算力就超过了20万张等效A800,其中70%的算力,都是之前放在机房里吃灰的闲置资源。还有阿里云的飞天系统,之前是做分布式存储的,现在把分布式调度的能力下沉到边缘节点,给中小客户提供比核心IDC便宜60%的推理算力。商汤自己建的那个万卡集群,2024年算下来利用率只有38%,后来把闲置的算力挂到共享平台上,光这部分一年的营收就有12亿,比他们卖定制化AI服务的毛利率还高。
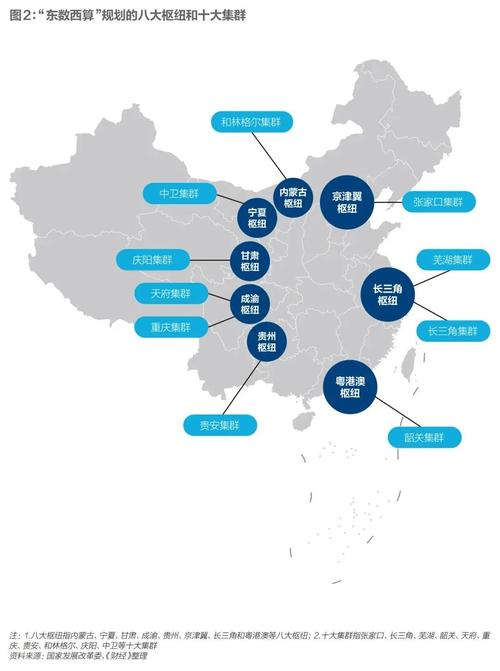
卡涨价的时候,大家都慌。现在呢?没人慌了。因为你就算买再多卡,放机房里晒着,一年折旧折掉一半,不如把卡拆到各个城市的边缘点,边给用户做转码,边挤时间训模型。一张A800卡从2023年的12万一张,跌到2026年的3.8万一张,放在核心IDC里,一年的机柜租金、电费、运维成本就要1.2万,要是利用率只有30%,单卡每小时的实际成本是纯边缘节点的4.2倍——哪怕你技术再牛,模型优化做得再好,也补不上这部分成本差。
普通人能摸到的红利,才是真的机会
之前很多人觉得,分布式计算是大厂的游戏,跟普通从业者没关系。错了。这波红利,恰恰是给那些没有钱砸重资产的普通人留的。
有个做工业缺陷检测小模型的创业者跟我算过账,2024年他想训个70亿参数的垂直模型,租核心IDC的算力,每千卡每小时的成本是18块,整个训练下来要花32万。2026年他在分布式算力平台上,挑了一批价格便宜的闲时边缘节点,凑了个2000卡的小集群,整个训练下来只花了9.8万。比之前便宜了近2/3——之前他要接3个客户的订单才能赚回模型训练的成本,现在接1个就够了。
还有个在武汉做小IDC的老板,手里攥着两个一共12个机柜的小机房,之前的生意是给当地的政府单位、中小企业放服务器,一年赚个七八十万就不错了。2025年他把机房里的200张闲置GPU挂到分布式调度平台上,现在每个月的稳定流水就有18万,比之前做机柜租赁的收入高了3倍。
说实话,我特别烦现在吹的那些“端侧分布式”的概念——什么把算力放到每个用户的手机上,让用户自愿贡献算力,纯纯的扯淡。你手机那点GPU,刷半小时短视频就烫得能煎鸡蛋,还想让你贡献算力训模型?真当用户是冤大头,给你免费用电?真正的分布式,从来不是把算力塞到普通人的家里,是把那些之前被浪费的、散在各个机房角落的闲置算力,给盘活了。
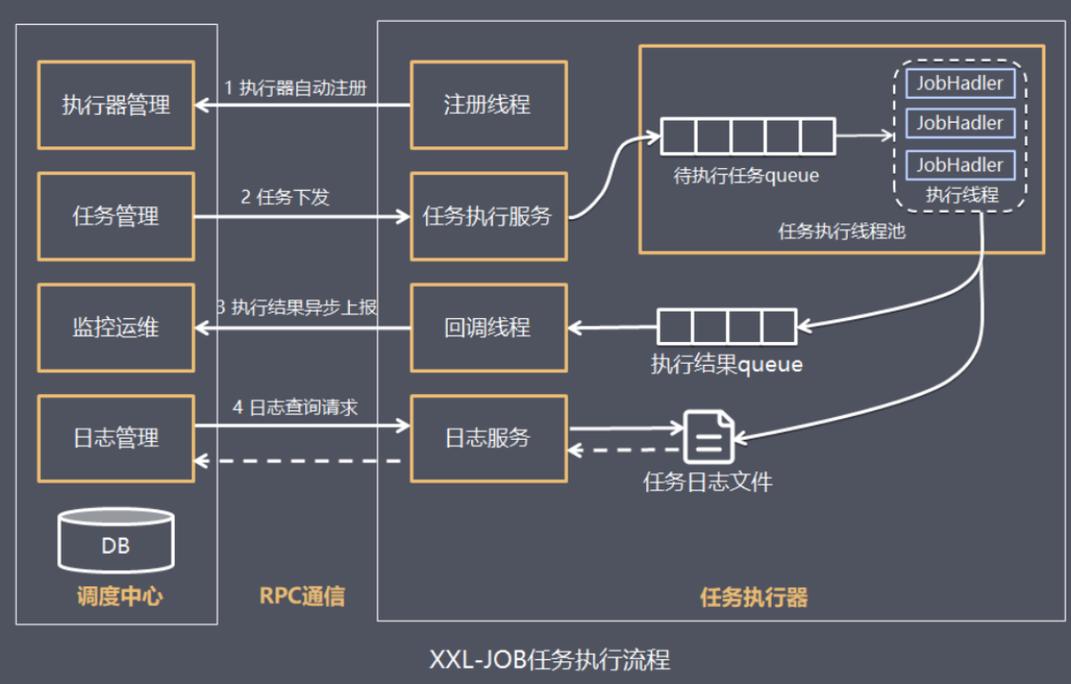
现在所有人都在讲“算力国产化”“万卡集群”,好像只有砸几百亿建的核心智算中心,才是未来的方向。但没人算过,当这些智算中心的利用率长期上不去的时候,那些重资产的投入,最后都会变成压在公司账上的折旧包袱。
现在所有的云厂商都在喊“要建全国最大的智算中心”,砸几百亿买卡,把机柜塞得满满当当。3年后,当这些卡的残值跌到采购价的20%,当平均利用率还不到30%的时候,是他们抱着一堆生锈的卡哭,还是现在偷偷盘活闲置算力的玩家,已经把80%的中小客户都用脚投票拉走了?
作者|大讲堂
排版|大讲堂
审核|乐乐