 大讲堂

上周去苏州蹭了一场小范围的半导体闭门会,席间有个做流片的工程师喝多了,拍着桌子说现在行业里但凡讲算力的,不拽两句类脑计算都不好意思出门见人。我当时没接话——毕竟他手里攥的那版7nm类脑芯片,上个月刚在实验室跑通了100万神经元的模拟,离量产还差十万八千里。
说真的,过去三年类脑计算的热度涨得太快了。从大厂的技术发布会到地方的产业园招商,从高校的顶会论文到创业公司的融资PPT,类脑成了继GPU、存算一体之后,又一个被捧成“下一代算力核心”的概念。但很少有人真的坐下来聊:这个技术到底能干嘛,现在卡在哪,离普通人的生活到底有多远。
类脑不是“复刻人脑”,别被营销话术绕进去
很多人对类脑计算的第一印象,是“把人脑搬到芯片上”,甚至有厂商吹自己的芯片能模拟人脑860亿个神经元,未来能产生意识。纯扯淡。
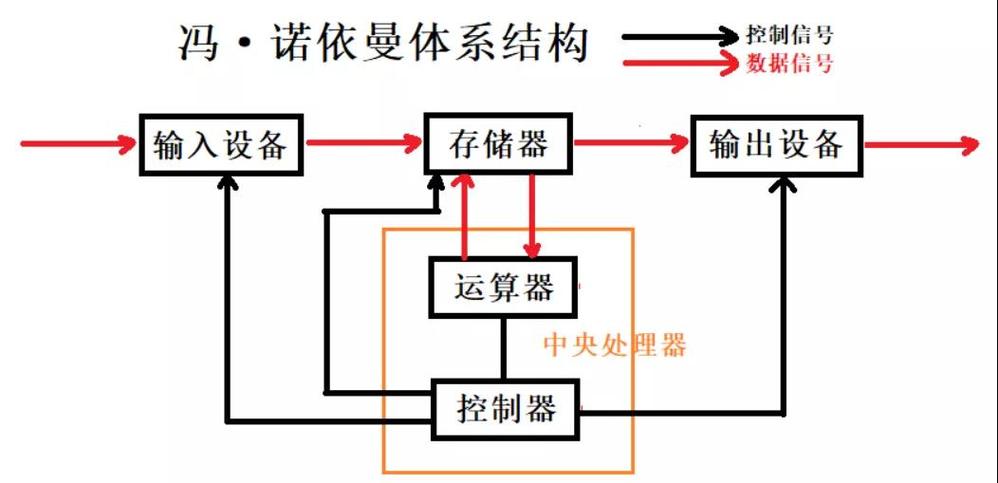
现在全世界所有已经流片的类脑芯片,核心逻辑其实和人脑的相似度,还比不上你家的智能门锁和人脑的相似度。它真正要解决的问题,是传统冯诺依曼架构的天生缺陷:计算和存储分离,跑大规模AI模型的时候,数据要在两个单元之间来回搬运,这部分无效传输的功耗往往占到整体功耗的90%以上,哪怕你把计算单元的能效提得再高,架不住来回搬数据的能耗黑洞。
类脑的核心设计思路很简单:把计算单元和存储单元揉在一起,用脉冲神经元的异步触发机制代替传统芯片的同步时钟驱动——有信号的时候才触发计算,没信号的时候就进入休眠状态,功耗能压到传统同性能芯片的几十分之一。
但这里有个非常清晰的技术边界,很多人故意不说破:我们现在对人脑本身的认知,连海马体怎么完成长期记忆存储、视觉皮层怎么处理边缘信息这些基础问题,都还没搞出确定的结论。现在的类脑芯片,本质上是借用了人脑“脉冲触发、存算一体”的几个工程化特征,离真正的“类脑”差了十万八千里。
我前两年也被几个厂商的PPT忽悠过,听对方说他们的类脑芯片能做到和人脑相当的能效比,后来找圈内人问,人家说那是把仿真软件跑在高端GPU上算出来的理论值,和真正的片上神经元实现半毛钱关系没有。真要算实际能效,现在最顶尖的类脑芯片,能效大概是人脑的1%都不到。
别被数字吓到。这已经是过去二十年里,这个领域能拿到的最好结果了。
现在的类脑产业,卡在了“没人用”的死循环里
技术原理说起来都好听,落到产业端就是另一回事了。
现在国内能拿出实际流片成果的类脑团队,掰着手指头数得过来:清华的天机芯系列、中科院微电子所的脉冲神经形态芯片、还有几个高校孵化的创业团队,最早的成果出来的时候,大家都吹,说能做自动驾驶、能跑通用大模型、能把边缘端的算力成本打下来。结果呢?
生态没跟上。
你花大价钱买了一块类脑开发板,想跑个最基础的目标检测任务,发现现在主流的PyTorch、TensorFlow训练出来的模型,根本不能直接往上面部署。你得把卷积层、全连接层一层一层拆解开,转换成脉冲神经元的连接权重和触发逻辑——一个普通的ResNet50模型,没有两三个月的专门适配,根本跑不起来,最后跑出来的精度,还比在传统GPU上低5%到10%。
谁愿意干这个?
英特尔最早在2017年就推出了第一代Loihi类脑芯片,到现在快7年了,一共就给全球几十家高校和科研机构送了开发板,连个正经的商业化客户都没有。不是芯片不好,是软件栈太残缺了:没有成熟的编译器,没有现成的算子库,没有针对不同场景的适配工具,你总不能让客户对着寄存器写汇编吧?
我上次见个做类脑创业的CEO,聊到最后他自己都笑,说现在做类脑就像1995年的安卓团队——硬件先折腾出来了,软件生态、开发工具、第三方适配全是空白。你出去找客户,客户第一句话就问:你这个芯片比我现在用的ARM Cortex-M系列强在哪?功耗低?哦,只低30%?那我为啥要换?换芯片意味着我要改整个产品的软件逻辑,研发成本涨一倍,售后的兼容问题能把我拖死。
现在整个行业就在死循环里转:没有足够的客户用,就没钱投软件生态建设;软件生态跟不上,就永远没有足够的客户愿意换。
别等通用类脑,先盯着三个真能落地的场景
当然,我不是说类脑计算是个伪需求。恰恰相反,它的优势太明显了——低功耗、低延迟、异步触发,这些特性在很多细分场景里,是传统架构根本比不了的。只是现在很多人对它的期待错了,总想着类脑要取代GPU做通用算力,根本不现实。
真要落地,就得盯着那些对功耗、延迟敏感度极高,而且不需要跑复杂通用大模型的场景。
第一个是野外低功耗传感节点。比如装在原始森林里的生态监测站,靠太阳能供电,要24小时监听有没有盗猎的枪声、有没有山火的异常声响,传统的MCU跑这个识别算法,一周就要换一次电池,维护成本高到离谱。换类脑芯片的话,因为平时没有异常声音的时候,芯片几乎不耗电,只有当检测到符合特征的脉冲信号时才触发计算,一套节点能撑3到5年不用换电池。这个场景现在已经有国内的团队在和自然保护区做联合测试了,不是PPT。
第二个是工业端的微秒级故障检测。工厂里的电机、轴承在运转的时候,会产生连续的振动信号,传统的检测方案要一直高速采样、一直计算,功耗高,延迟还做不到毫秒级以下。类脑芯片能把连续的振动信号转换成脉冲序列,只有当振动频率出现偏离正常阈值的变化时才触发计算,平时几乎不耗电,检测延迟能压到微秒级,比传统方案快两个数量级。
第三个是侵入式脑机接口的信号解码。现在的侵入式脑机接口,要把几百个电极采集到的神经脉冲信号实时转换成操作指令,传统的芯片戴在人头上,半小时就发烫,功耗高到根本没法长期佩戴。类脑芯片本身就是处理脉冲信号的逻辑,和神经信号的特性天生匹配,现在已经有团队在和临床机构合作,测试用类脑芯片做脑机接口的前端解码单元了。
这些场景都不需要类脑芯片跑复杂的大模型,也不需要和GPU拼通用算力,只要把低功耗、低延迟的优势发挥出来,就有客户愿意买单。
说点不好听的。
现在很多地方政府把类脑计算当成下一代算力的标杆,砸了几个亿建产业园,结果招进来的一堆公司,根本没有核心的流片能力,就是拿高端GPU跑脉冲仿真,套个类脑的壳子拿补贴。这种泡沫不戳破,最后受伤的还是真正做技术的团队。
还有伦理层面的隐忧。现在的类脑芯片还只是个低功耗的信号处理单元,离产生认知能力差得远,但如果未来真的做到了能模拟人脑的认知逻辑,那基于类脑芯片做的深度伪造、人机交互接口,根本没法用现在的检测手段识别——因为它的信号处理逻辑和人脑本身是一样的。这个问题现在还没人认真讨论,等技术真的到那一步了,再补政策就晚了。
我从来不觉得类脑计算能在3到5年里取代GPU,成为通用算力的核心。毕竟现在GPU的生态已经成熟到卷出花了,你一个新架构想抢通用市场,难如登天。
但3到5年里,类脑芯片一定会在低功耗边缘计算的细分赛道里,拿下10%到15%的市场份额——特别是那些对功耗、延迟要求极高的场景,它的优势是传统架构根本打不过的。
别信那些说类脑要在2030年造出人工大脑的鬼话。我们现在对人脑的认知程度,就相当于莱特兄弟刚造出第一架飞机的时候,想造超音速客机。
方向是对的。
路还长着呢。
作者|大讲堂
排版|大讲堂
审核|安然