 大讲堂

2047年入秋的那个雨夜,我在出租屋阳台拆前租客留下的旧服务器机箱,风扇转起来的嗡鸣比窗外的雨还沉。本来以为是个跑废了的云存储节点,接电开机才发现,里面装着个跑了十二年的本地分词引擎,连最新的大模型接口都没接,启动之后弹出来的第一个界面,是满屏没被上传过的、碎成渣的语言碎片。
我攒的第三抽屉分词残片
我当时蹲在机箱旁边坐了三个小时,翻出来快8个G的缓存文件。没有规整的分类标签,没有用户的隐私脱敏,就是实打实的、被引擎拆了一半、还没等到用户确认发送的句子。
有个独居的张奶奶对着语音条说“帮我把阳台的降压药拿过来”,引擎卡了三秒,把“降压药”硬生生拆成了“降/压/药”,连接的智能药盒识别到“压”这个单字,转头从旁边的收纳盒里摸出了压蒜器,顺着智能滑轨推到了张奶奶脚边。后面缓存里跟着的,是张奶奶气的笑出来的语音转文字:“老东西/连个/词都/分不对/”。
我看到这段的时候笑的直拍机箱,转头就想起去年冬天我妈给我发的语音,云端分词把“你爸最近总偷偷去楼下跟人下棋”拆成了单字粒度的碎块,联动的智能社区系统直接给楼下棋牌室老板发了跨区活动报备提醒,说我爸未授权就进入娱乐场所,给我爸气的三天没接我电话。
这些碎的、错的、带着毛边的片段,我后来都存在了我书桌的第三抽屉里——那抽屉本来是放旧硬盘的,现在专门装这些没被云端收走的本地分词缓存。
最早的分词,根本不是给机器看的
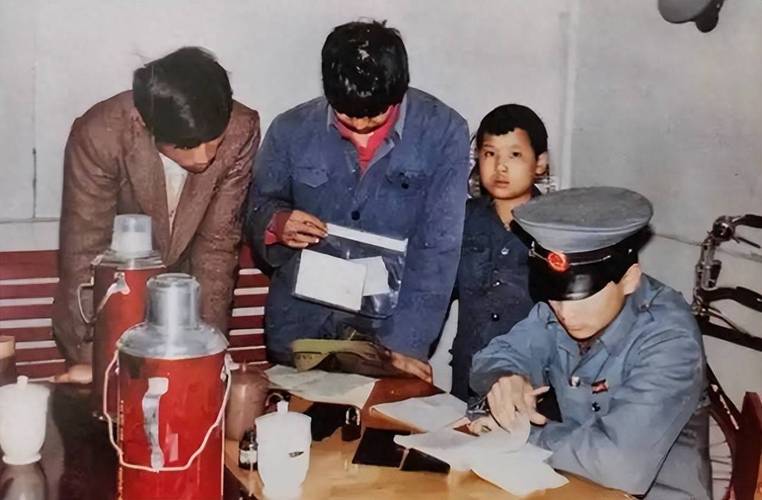
上个月我去城郊的老科技园找陈工,他是国内最早一批做中文分词的工程师,今年快七十了,退休之后还在自己的小工作室里敲老代码。我给他带了两盒张奶奶爱吃的桂花糕,聊起现在的分词技术,他撇撇嘴说,现在的年轻人总觉得分词是大模型的功劳,是算力堆出来的智能,根本忘了最早的分词,是一群人拿着小本子,一个词一个词敲出来的。
他说1992年他在实验室调规则的时候,哪有什么万亿级的语料库,整个实验室的人轮班,把《人民日报》三年的报道逐句拆,什么“改革开放”“乒乓球”“巧克力”,每一个词都要手动录进词表,错一个字,可能就会把“南京市长江大桥”拆成“南京/市长/江大桥”,害得当时真的有个叫江大桥的市长,莫名其妙收到了几百封群众来信,问他是不是真的去南京当市长了。
他翻出来压在玻璃板下面的老软盘,里面是他1995年做的初代词表,我凑过去看,除了正规的通用词汇,里面还藏着好多私人的词条:“糖糖脚脚”“怕怕”“陈朵朵”——是他女儿小时候说的话,他怕系统把女儿发的语音拆成奇怪的内容,特意手动加进去的。
我当时拿着那张软盘,突然有点鼻酸。以前我们总觉得技术是冰冷的,是没有温度的,但最早的人工录入的初代词表里,藏着一个爸爸给女儿留的小后门,藏着一群人在实验室熬了无数个夜的较真,藏着我们对着一团乱麻的中文,一点点想要让机器读懂人话的笨拙尝试。
那些没被拆对的话,才是真的人味
现在的分词引擎早就进化的没边了。几万亿的语料喂出来,别说“南京市长江大桥”这种经典错例,就是你说半句藏头的暗语,它都能精准识别出你要表达的意思,甚至能预判你下一句要打什么,自动给你配上合适的表情包,跳转对应的购物链接。
但我翻那个旧服务器的缓存时,反而觉得那些拆错的句子,才是真正活着的语言。
比如里面有个2039年的高中生聊天记录,男生给喜欢的女生发“我想把星星折给你”,当时刚升级的智能分词系统精准把这句话拆成了完整的词块,直接触发了天文APP的联动,给男生推了一堆观星团的周末报名链接。男生急的在聊天框打“不是!我不是要去观星!”,结果系统又精准识别了这句话,给女生那边弹了个“对方正在输入观星相关内容”的提示,两个人因为这点破事别扭了半个学期,最后还是女生主动找男生,说“我知道你不是要去观星,你是想折星星给我对吧”。
还有我外婆去年走之前,躺在病床上气若游丝,跟我妈说“我想穿那件绣了梅花的蓝布衫”,全屋的智能设备都在等着分词指令,要联动衣柜帮着找衣服,结果外婆的声音太轻,系统把“蓝布衫”拆成了“蓝/不/衫”,智能衣柜找了半天,推出来一件印着“蓝不”两个字的潮牌文化衫。我妈抱着那件衣服哭的直抽,说这破机器怎么连我妈的话都读不懂。
我那天对着旧服务器坐了一整夜,翻了快十几个G的缓存,里面有加班的程序员凌晨三点给女朋友发“我今天又吃了黄焖鸡”,被拆成“我/今天/又/吃了/黄/焖/鸡”,系统直接给黄焖鸡店家发了订单,备注“微辣,少放鸡”;有刚上小学的小孩对着智能音箱说“我要吃妈妈做的西红柿炒鸡蛋”,被拆成单字块,系统直接给妈妈的公司发了早退提醒,说家里孩子需要照顾。
说实话,以前我总觉得分词越准越好,越智能越好,最好能做到你抬抬眼皮,它就知道你想说什么。但现在我突然觉得,那些拆错的、歪歪扭扭的、没被精准识别的拆错的语言碎片,才是我们真正在说的话——不是给机器听的指令,是带着情绪、带着毛边、带着点说不出口的软话的。
那个把降压药识别成压蒜器的张奶奶,后来在缓存里留了一句语音:“老东西分不对也挺好,至少我那天没吃错药,还自己扶着墙去厨房找了降压药,走了那二十步,医生说我恢复的比别人快多了。”
上周我把那个旧的本地分词引擎装在了自己的旧笔记本上,关了所有的云端同步,现在我给朋友发消息,系统还是会偶尔拆错,比如我打“今天去看了陈工”,它可能拆成“今天/去/看了/陈/工”,给我推一堆陈工牌蜂蜜的购物链接。
我也没修。
就留着那些错的地方。
毕竟哪有那么多百分百精准的话啊。
我们说的每句话,本来就是带着碎渣的。
作者|大讲堂
排版|大讲堂
审核|见微