 大讲堂

上个月在亦庄的算力中心蹲了三天,亲眼看见8张H100因为卡之间通信带宽不够,原本能跑到95%的GPU利用率直接掉到32%。
运维小哥蹲在机柜旁边挠头,说这已经是这周第三次了——租的是公共云的分布式算力实例,网络是共享的,一到高峰就挤,每次卡壳都要手动重启训练任务,折腾下来一天的有效训练时间还不到6小时。
别笑。这是现在90%做分布式训练的团队每天都在面对的日常。
别被“分布式”三个字唬住:它本质是拆任务的笨办法
很多人对分布式训练的第一印象是高大上的集群技术,说白了,它就是个拆任务的笨办法。
当你要训的模型大到单张GPU的显存装不下——比如70B参数的大模型,光权重就要占140GB显存,单张H100的80GB显存根本塞不下,你就得把整个训练任务拆成几块,分到不同的卡上去算。
拆的方式无非三种:把训练数据拆成小块分给不同的卡算,最后同步梯度,叫数据并行;把模型本身的网络层拆成几块,分到不同的卡上跑前向传播,叫张量并行;把模型按层切成一段一段的,流水线一样在不同的卡上依次跑,叫流水线并行。
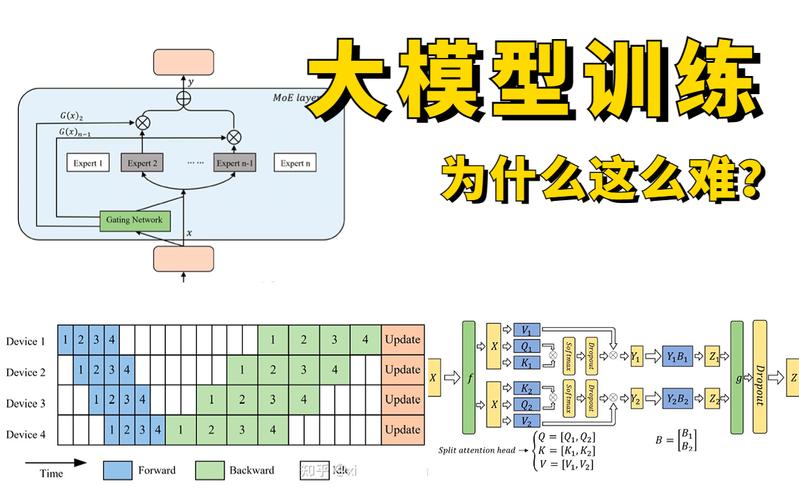
很多人对分布式训练的最大误解,就是以为核心瓶颈是单卡算力不够,实际上真正的天花板是通信开销。
你把任务拆得越细,不同的卡之间需要同步的梯度、激活值数据就越多。举个最极端的例子,如果你把一个10B的模型拆成100份分到100张卡上,每一次反向传播,卡之间要传的数据量甚至比模型本身的参数还要大。到最后你会发现,GPU一半的时间都在等别的卡传数据,根本没在算东西。
说真的,见过太多创业团队上来就租几百张卡,最后训练效率还不如人家优化好的几十张卡,纯纯给云厂商送钱。
现在的行业现状:一半的算力都浪费在通信损耗上
你知道现在全球大模型训练的平均分布式效率是多少吗?
40%到60%。
就是说你买100张卡,真正用来算模型的时间只有一半,剩下的一半都在等通信、等同步、等系统调度。能把效率做到70%的团队,已经算是全球第一梯队了——比如OpenAI、字节、阿里这些有自己集群的大厂,人家能拿到的硬件资源、网络带宽,都是普通小团队根本碰不到的。
现在行业的技术进展其实有点拧巴。硬件的算力每年翻一倍,但通信带宽的增长速度只有算力的三分之一。NVLink把单台服务器里的卡间带宽拉到了900GB/s,但跨服务器的卡间带宽最多也就200GB/s,跨机房的话直接掉到10GB/s不到。
这就导致现在所有的大规模训练,本质上都是“本地集群训练”——哪怕是号称万卡集群的项目,所有的卡都必须放在同一个机房的相邻机柜组里,靠高速的内部网络连起来。之前有个朋友跟我吹他们的“全国算力调度平台”能把分散在各地的闲置GPU凑起来训大模型,我问他跨城传一次梯度要多久,他沉默了。
对吧?跨城的网络延迟是几十毫秒,一次梯度同步要传几个GB的数据,光传完就要几百毫秒,等你传完,别的卡都已经把下一轮的任务算完了,根本没法同步。
还有个很有意思的现象:现在很多云厂商卖的“分布式训练服务”,其实就是把GPU实例按小时租给你,根本不帮你做底层的网络优化。你租100张卡,他给你塞到共享网络的机架里,跑起来效率低了他不管,反正钱已经收了。
产业链的隐形门槛:不是买卡,是攒集群的能力
很多人以为现在大模型的竞争是算法的竞争,是数据的竞争,其实根本不是。
真正的门槛是你能不能攒出一套高效的分布式训练集群。
之前OpenAI训GPT-4的时候,光负责集群网络优化的团队就有几十人,他们要调的东西不是模型参数,是交换机的路由规则、网卡的传输模式、甚至是机柜里网线的摆放角度——就为了把卡间的通信延迟再降个几毫秒。
现在的竞争格局很有意思:海外是英伟达的全栈闭环,从GPU、NVLink互联、集群网络到上层的训练框架,全是自己的东西,你只要买他的DGX系统,拿过来就能跑,效率能做到60%以上,不用自己折腾。国内现在是华为、阿里、字节这些大厂在自己攒集群,用国产卡或者英伟达的卡,自己写底层的通信优化代码,小团队根本玩不起。
哦对,还有个很现实的问题:现在的分布式训练方案根本不兼容。你用英伟达的卡训出来的模型,想迁到昇腾的集群上,光改并行策略、调通信参数就要花好几个月的时间,迁移成本高到离谱。这也是为什么现在很多拿到融资的创业团队,宁愿花高价抢英伟达的卡,也不愿意用更便宜的国产卡——不是不想支持,是真的改不动代码,耽误不起训练时间。
藏在分布式训练里的隐性风险
聊完技术和产业,得说说容易被忽略的风险。
第一个是算力浪费带来的能耗问题。现在全球大概有30%以上的GPU算力,因为分布式优化不到位被白白浪费了。要知道训一次70B的大模型,大概要耗掉几百万度电,如果你的训练效率只有40%,相当于有200万度电都浪费在了等通信上,对应的碳排放能翻一倍还多。
第二个是数据安全风险。现在有不少团队想靠“凑闲置GPU”的方式降成本,把训练任务拆到第三方的闲置卡上跑。但已经有学术研究证明,攻击者可以通过收集卡之间传输的梯度信息,反推出训练数据里的隐私内容——比如用户的手机号、身份证号,甚至是训练用的涉密数据。你把梯度传到别人的卡上,相当于把训练数据的一半都交出去了。
第三个是标准缺失带来的锁定风险。现在各家的分布式集群方案都是黑盒,没有统一的接口标准,你用了哪家的服务,后面想换供应商的成本极高。这和当年的数据库锁定、云服务锁定是一个道理,等到你把模型训出来了,发现自己已经被绑死在某一家的集群上了,想走都走不了。
未来3年,分布式训练会往哪走?
说几个我自己观察到的趋势,不一定全对,但至少是现在行业里的头部团队都在押注的方向。
首先,异步训练框架会慢慢取代现在的同步训练。现在的同步训练是所有卡都要等最慢的那个卡算完,才能进入下一轮,相当于整个集群的速度是由最慢的卡决定的。异步训练就不用等,谁算完了就先传梯度,虽然之前有精度损失的问题,但现在的算法优化已经能把精度损失压到1%以内了,最多3年,异步训练就会成为大规模集群的主流方案,能把整体效率再拉高一截。
其次,端边云协同的分布式训练会落地。不用把所有数据都传到中心机房的大集群里,在靠近数据源头的边缘节点先做部分训练,算出初步的梯度,再传到中心机房做汇总。这样能把跨网络传输的数据量降90%以上,特别适合那些数据不能出域的行业——比如金融、政务的大模型训练。
最后,中小团队的分布式训练门槛会大幅降低。现在不用自己花几百万攒集群,也不用自己调复杂的并行策略,云厂商会把优化好的分布式训练能力做成开箱即用的PaaS服务,小团队只要上传模型和数据,点一下按钮就能自动拆任务、优化通信,不用再当运维小哥蹲在机柜旁边挠头。
说到底,分布式训练从来不是什么高大上的黑科技,就是人类为了突破单卡的算力天花板,想出来的一堆拆东墙补西墙的办法。只是现在这个墙越来越厚,补的人越来越多,慢慢就成了大模型时代最核心的基础设施。
作者|大讲堂
排版|大讲堂
审核|满满