 大讲堂

2026年3月的深圳,我在福田CBD的一家咖啡馆蹲了整整三天。
见了七个银行科技部的老熟人。
全在骂。
骂什么?骂之前花了几千万建的数据中台,成了锁在机房里的摆设。
2026年那场废掉1.2亿项目的行业地震
骂的由头很直接:某头部股份制银行把已经走完招标流程的“全域客户数据集中治理”项目直接废标,省下来的1.17亿预算,全砸给了和微众银行合作的联邦学习零售信贷联合建模项目。消息传出来的时候,整个金融科技圈都炸了——要知道过去十年,银行科技建设的核心叙事从来都是“数据集中、统一治理”,谁能把全行的用户数据全搬到一个统一的云仓,谁就能做出最准的零售模型。
但现在大家突然发现,这条路算不过账了。
按当时的《个人金融信息保护规范》,那个废标的集中式项目要落地,得先把全行2.3亿零售用户的交易、理财、信贷数据全做分类分级,回溯用户授权链路,过等保三级测评,光合规环节的成本就要占总投入的42%——相当于把一半的项目预算,全付给了律所、咨询公司和第三方合规审计机构,换回来的还是随时可能被抽检罚款的风险。
说实话,我之前也把联邦学习当成个PPT技术。就是数据不能动的时候,凑合用的补窟窿工具。直到去年帮一家城商行算过账:他们之前为了和本地公交公司联合做消费贷客群模型,把公交刷卡数据脱了三趟敏,光数据脱敏、跨主体合规审核就花了80万,最后模型跑出来的AUC才0.72,比纯行内自有数据的0.71没好多少,纯纯的冤大头。
结果这次银行直接把集中式项目砍了,转头把联邦学习当主力,所有人的认知都被掀翻了。原来不是“实在没法集中才用联邦学习”,是联邦学习本身的账,已经比集中式算得更划算了。
卷加密算法的厂商,根本没搞懂商业本质
过去三年,隐私计算赛道的卷法,现在回头看特别可笑。
大家拼了命的在加密算法上堆料。全同态加密、零知识证明、差分隐私,一个比一个玄乎,卖license的时候张口就是“绝对隐私、零数据泄露”。结果某券商去年做的成本测算直接给大家浇了盆冷水:用最顶级的全同态加密框架做的联邦学习风控模型,单条用户推理的算力成本是0.012元,而如果是把数据脱敏后传输,按过去三年的合规处罚案例平均值,单条的合规风险摊下来才0.003元——等于加密方案的成本,比直接承担合规罚款还贵3倍。
这账,怎么算都不对。
其实根本没人care什么“绝对隐私”。企业掏真金白银做技术,从来不是为了追求技术理想,是算投入产出的。联邦学习能跑通,本质上是把之前跨主体数据交易的固定成本,拆成了按调用量付费的可变成本。
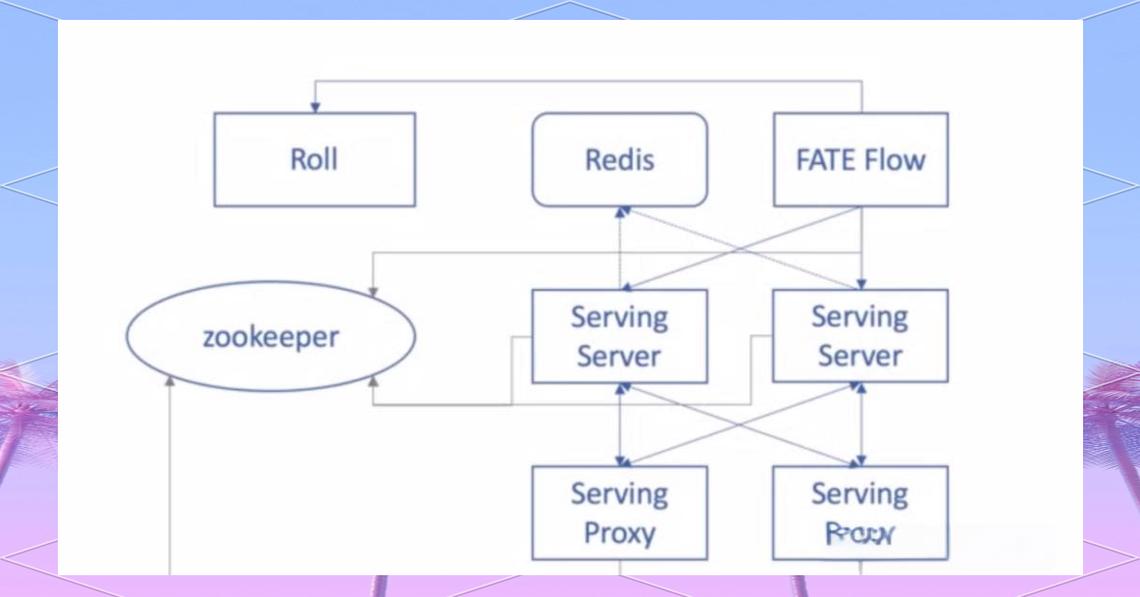
这里就得说微众银行的FATE框架,这是国内真在算实账的玩家。2025年推的FATE 2.0版本,根本没在加密强度上做文章,反而把横向联邦的跨节点通信成本砍了60%。现在他们和长三角12家城商行、8家本地商超、3家地铁集团做的联合消费贷模型,去年一年就给合作行带来了270亿的新增低不良贷款,整个项目的总投入才不到2000万——对比某大行花3个亿建的集中式数据仓,最后带来的新增贷款才120亿,ROI差了快4倍。
这个模式其实像以前的敌后游击战:以前大家打数据战,都是把所有兵力(核心数据)集中到一个大本营,等着被对手端老窝(监管处罚、数据泄露),现在联邦学习就是把兵力分散在各个据点,只在打仗的时候凑个联合指挥部,谁也不用把家底全交出去,打输了也不会全军覆没。
不过话说回来,现在赛道上还有好多公司在走偏。拿着个加密算法就敢吹“行业标杆”,根本不算全链路的账。
账算不过来。
再炫的技术也活不下去。
技术叙事拆穿之后,普通人的机会在哪
别觉得这些事离普通从业者远得很。
我上个月刷招聘网站,发现个有意思的变化:之前互联网公司抢破头的“数据中台架构师”岗,2026年的平均薪资比2024年跌了32%。反倒是那些之前根本没人听过的“联邦学习节点运维岗”,开出来的薪资比同级别后端工程师高了快一半。
为啥?
原来那套“把所有数据集中到一处再建模”的玩法,现在在合规成本面前已经卷不动了。之前在银行做数据治理的老周跟我吐槽,他们团队原来18个人,天天加班给数据打标签、做脱敏、等监管审批,去年把一半的活换成联邦学习跨节点对接之后,团队裁了6个人,剩下的人不用再碰原始数据,只要盯着节点的通信延迟、模型参数的梯度变化就行。活少了,产出的模型效果反而比之前好——毕竟原来为了过合规,把数据里最有区分度的用户标签全给抹了,现在数据根本不用动,模型直接在本地跑,当然效果好。
对小创业者来说,这其实是个挺难得的窗口。之前你想做个ToB的风控模型,首先得有数据吧?没有数据,你连和大厂谈合作的资格都没有。现在不一样,只要你手里有某一个垂直场景的小数据集,不管是校园消费、社区养老还是本地教培,只要能接到联邦学习的公共网络里,你根本不用把原始数据交出去,就能和银行、保险的通用模型做联合训练,最后按调用量分润。
我去年认识的那个做社区养老数据的90后姑娘,之前攒了3年的老人居家健康监测数据,之前找保险公司谈合作,人家说她那点数据规模太小,撑不起一个精算模型。今年初她把数据接入了本地保险机构的联邦学习节点,一起做老年意外险的风控模型,光今年上半年的分成就有80多万,比她之前靠政府补贴做项目赚的多了一倍。
当然,这里面的坑也不少。现在好多地方搞的联邦学习联盟,本质上还是大厂牵头的圈子——你手里的数据集要是没什么稀缺性,根本分不到多少利润。就像早年的产业互联网,看着是大家共享资源,其实最后吃肉的还是牵线的那个大厂,跟着玩的小玩家,最多捡点汤喝。
我之前总觉得,技术的叙事永远是最会骗人的。最开始大家吹大数据,说数据是石油,要集中起来才能炼出汽油。后来大家吹隐私保护,说石油不能随便挖,要装个防爆罩才能用。现在大家才反应过来——哪有什么为了保护才用联邦学习?
说白了,就是之前集中挖石油的成本,已经高到大家都扛不住了。
至于接下来会变成什么样?
等那些手里攥着最多稀缺数据的玩家,把联邦学习网络的路由权全捏在手里的时候,你再回头看今天吹的“数据要素自由流通”,会发现这根本不是什么开放的技术网络,就是另一个版本的收费站。
作者|大讲堂
排版|大讲堂
审核|小准