 大讲堂

傍晚六点半,巷口的梧桐把夕阳剪得稀碎,落在社区诊室的木质桌面上。陈姐摘下老花镜,揉了揉发酸的眼角,电脑屏幕右下角跳出来一行淡绿色的提示:本轮模型聚合完成,全局精度提升3.7%。
她端起凉掉的菊花茶抿了一口,想起去年张叔骂骂咧咧摔门走的样子。那时候市里要做一个糖尿病并发症早筛模型,号召各个社区上传患者的血糖病史数据,张叔填到一半,想起半年前填完信息后,天天接七八个卖降糖保健品、重疾险的推销电话,当场把表格揉了,说死也不会再把自己的信息给任何人。
那时候这事卡了快半年。患者怕泄露隐私,机构怕违规担责,好好一个能帮到几千个老人的模型,就因为数据拿不出来,卡在半路上。直到这套基于隐私计算联邦学习模型聚合的新系统上线,僵局才一下子被打开。
谁都拿不走你的原始数据
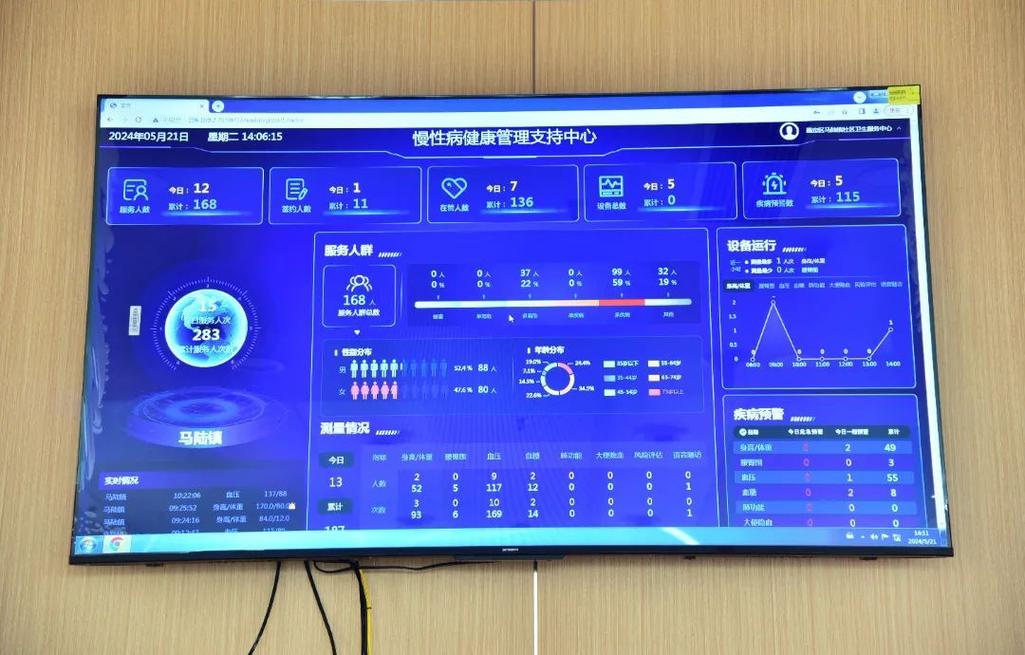
张叔现在戴的智能血糖手表,所有数据都存在手表本地和诊室的本地加密服务器里,从始至终不会把完整原始数据传到市中心的平台。
平台要做模型,不需要碰你的数据。每个节点——不管是社区诊室、患者的手机,还是大医院的数据库——都在本地用自己的数据训练模型,只需要把训练更新后的模型参数传出去聚合,原始数据一辈子都待在你自己的地盘,谁都拿不走。
张叔一开始还不信,拉着陈姐问了十几分钟,确认连市长都看不到他的血糖记录,才点头同意加入。到现在快一年了,他一个推销电话都没接到。
不碰数据也能攒出好模型
很多人听不懂这个技术到底牛在哪,说穿了其实很简单。原来AI模型要变准,就得喂大量不同的数据,以前的思路是把所有数据攒到一块,存在中心服务器里一起训练,可数据攒一块,就难免有泄露风险,出了事就是天大的责任。
隐私计算下的联邦学习模型聚合刚好反过来。每个机构、每个用户都用自己的数据练一遍,把“我从数据里学到了什么规律”打包传给中心,把“我的数据具体是什么”留下来。中心再把所有人学到的规律聚合起来,就得到一个比任何单个节点都准得多的全局模型。
相当于一群医生各自看了很多病人,每个人都攒了自己的经验,然后大家坐在一起把经验汇总成一本新的诊疗指南,但是没人需要把自己病人的隐私说给别人听。就这么简单。
我去年见过这个项目的核心开发,一个戴黑框眼镜的小伙子说,最难的从来不是写算法,是说服大家相信你真的不会碰数据。之前跟三家社区医院谈,人家负责人直接说,哪怕出一丁点事,我饭碗就没了,不敢干。直到把模型聚合的逻辑讲透,演示了原始数据确实出不了本地,人家才点头试。

第三个选择的温度
这么多年,我们普通人好像一直没得选。要么就是交出所有隐私换AI的便利,刷短视频要给位置,买东西要给通讯录,连看个病都要把病史全交出去;要么就是捂住数据,什么便利都别想用,活该用不准的服务。
张叔的事就是最好的例子。之前要是不上传数据,这个早筛模型就拿不到足够多的老年糖尿病患者数据,模型不准,最后吃亏的还是张叔这样的病人。可要是上传了,隐私就没了,天天被骚扰,换谁都难受。
现在呢?张叔上个月刚靠这个模型做了早筛,提示他足部病变风险偏高,陈姐提前给他调整了用药,还安排了免费的筛查,早早就把问题压住了。从头到尾,除了陈姐,没人拿到过张叔的完整血糖记录。
说实话,我见过太多吹得天花乱坠的科技概念,张口颠覆闭口革命,落到普通人头上,要么就是偷数据换广告,要么就是骗政府补贴,很少有像这样,真真正正站在用户这边解决问题的。
不过话说回来,现在这个技术也不是完美的。比如聚合的时候会不会还是有参数泄露的风险?边缘节点的安全防护够不够?这些问题都还在解决。市面上也有不少公司拿着这个概念炒市值,割韭菜,真落地到社区医院这种小地方的,其实没多少。
但你不得不说,这个方向走对了。我们普通人要的从来不是完全隔绝数据,也不是心甘情愿裸奔。我们想要的,不过是我可以用我的数据帮大家做出更好的服务,我也能享受到更好的服务,但我的隐私,从头到尾还是我的。
陈姐锁好诊室的铁门,梧桐叶飘进她的电动车筐,手机弹了一条推送,今天又有五个新患者加入了训练,本轮参数聚合已经完成。没人知道这些患者是谁,没人拿到他们的数据,可整个模型,又悄悄变准了一点点。
这条路才刚开始。我们终于不用再在隐私和便利之间二选一了,接下来会走到哪,谁也说不准。但至少这第一步,走得挺暖的。
作者|大讲堂
排版|大讲堂
审核|柚子