2026-10-03 11:16:38 作者:大讲堂
前两个月跟一个创业公司的技术负责人喝咖啡,他拍着桌子吐槽,说他们团队花了半年搭的实时数仓,上线三个月愣是不敢给业务用,每次大促拉用户复购数据,出来的数跟业务部门自己算的差了快15%,查来查去,居然是维度表的锅——用户的省市归属维度更新不及时,一半新用户的地域属性错了。
没人在乎维度表对吧?大家聊数据基建都在说事实表、说计算引擎、说存算分离,谁会把功夫花在看起来平平无奇的维度表上?
维度表的核心:解决数据冗余,统一统计口径
维度建模是现在数据仓库建设的主流方法论,核心逻辑就是把整仓数据拆成两类,各司其职。一类是事实表,装业务行为的量化数据,比如订单金额、点击次数、停留时长;另一类就是我们今天说的维度表,用来存描述这些行为的属性信息。
举个最直观的例子:电商平台的一笔订单,「花了399元、买了1件商品、2024年5月1日下单」这些是事实,存在事实表。那下单的用户是新用户还是老用户、收货地址在哪个城市、买的商品属于「手机数码->手机->安卓手机」哪个层级,这些就是维度,全部存在维度表里。
为什么非要把维度拆出来?
要是把所有属性都塞进事实表,每一笔订单都重复存一遍「安卓手机」这个分类信息,一百万订单就要存一百万次,不仅浪费存储,哪天平台调整了品类分类,你得把所有相关订单都改一遍,工程量够技术团队喝一壶的。
抽成维度表之后,一个维度ID对应一个属性,事实表只需要存维度ID,查询的时候关联一次就够,省了存储空间,改属性的时候只要改维度表就行,牵一发动全身的问题直接解决。
维度表最容易踩坑的地方,就是缓慢变化维度——维度的属性不是一成不变的,用户换了手机号、商品换了分类、主播换了公会,属性变了怎么存?直接覆盖旧属性,统计历史数据的时候就会错,把以前属于旧公会的GMV算到新公会头上;新增一行带版本号的新维度记录,就能保留完整的历史变化,不同时间段的统计都能对得上。很多新手就是图省事直接覆盖,最后数据不对找半天找不到原因。
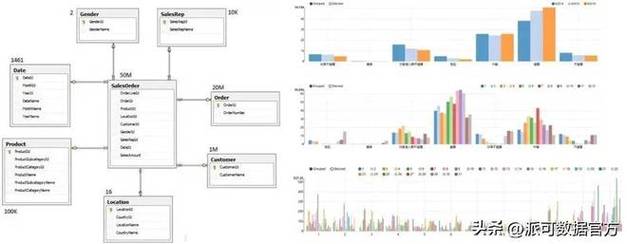 数据仓库维度表事实表关联关系示意图
产业落地的隐形陷阱:90%的数仓问题根在维度表
说实话,我见过太多团队,资源全砸在计算引擎、存储架构这些面子工程上,维度表都是随便凑出来的,最后出问题才追悔莫及。
之前接触过一个做社区团购的创业团队,早期为了赶618大促上线,直接把商品分类、用户层级这些维度全揉进了订单事实表里,日订单破十万之前没感觉,日订单涨到百万之后,拉一次周度品类销售报表要跑两个多小时,业务部门天天堵技术门。后来重构数仓,把所有公共维度抽出来做成独立维度表,同样的报表跑完只需要不到两分钟,性能提升快20倍。
更坑的是口径问题。很多公司不同业务线各做各的维度,用户中心做一套用户维度,运营做一套,电商部门又做一套,同一个「活跃用户」,A线定义是7天登录,B线定义是30天有消费,最后开会各拿各的数吵一下午,老板坐在上面都懵。
还有过度设计导致的维度爆炸,有些建模师为了所谓的灵活性,什么乱七八糟的属性都往维度表里塞,一个用户维度搞出上百个字段,每次关联查询都拖慢整个集群的性能,得不偿失。
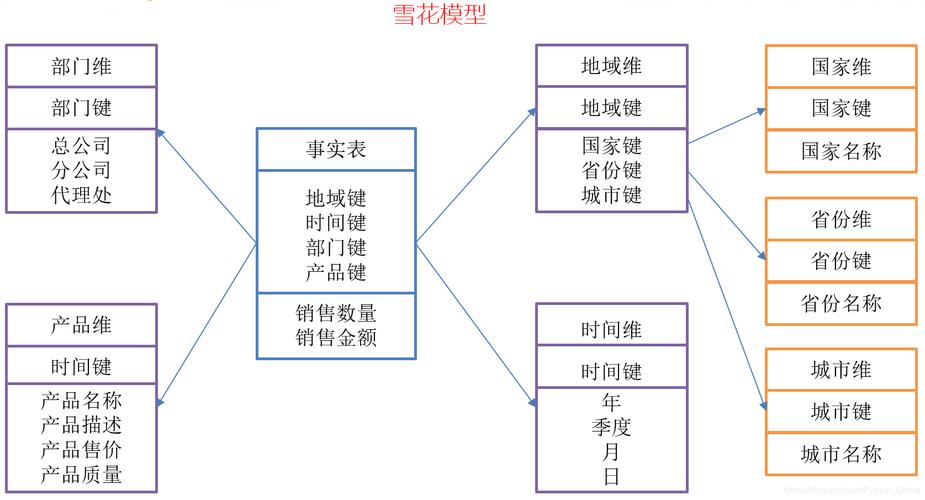 数仓维度建模星型模型雪花模型对比图
现在维度表落地的最大障碍,其实不是技术问题,是意识和治理问题。早期不重视,等数仓跑起来再改,成本高到吓人——所有上层的报表、推荐模型、数据分析都依赖旧的维度,牵一发动全身,没人敢接这个烂摊子。其次是责任不清,公共维度表做成了无人维护的公共鱼塘,脏数据越积越多,最后只能整个推倒重来,浪费了不知道多少人力物力。
新数据架构下,维度表的未来演化方向
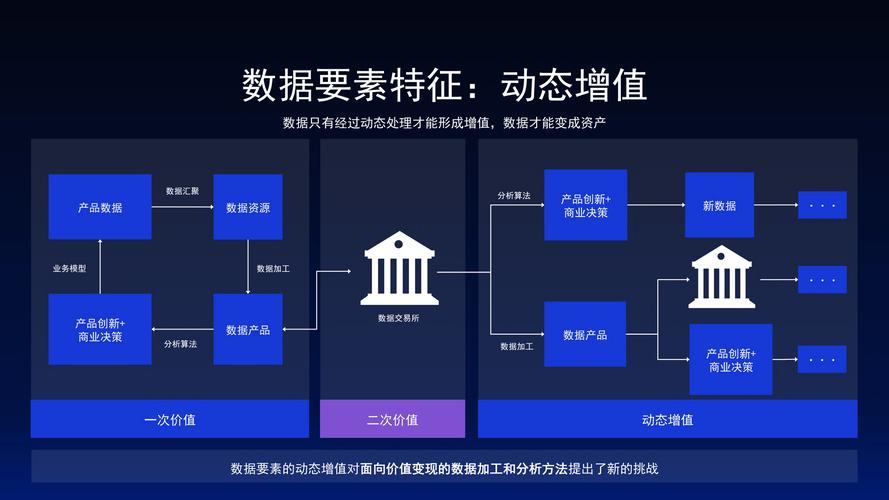 新数据架构下,维度表的未来演化方向
现在湖仓一体、实时数仓、向量数据库这些新概念火得一塌糊涂,很多人说维度表这种传统数仓的老概念该淘汰了?我反而觉得,维度表的价值只会越来越大。
首先,统一公共维度层已经变成数据中台的核心骨架。很多公司做数据中台,说来说去去搞了一堆花架子,真正有用的其实就是把全公司的公共维度——用户、商品、组织、地域这些,统一梳理一遍,定好统一的口径和更新规则,所有业务线都用这一套,避免重复造轮子还造出来不一样的轮子。不过话说回来,这里也有坑,很多公司把公共维度搞成了僵化的标准,业务要加个新属性走三个月审批,反而耽误业务进度,尺度怎么平衡,很考验团队的治理能力。
然后是实时化。过去维度表都是T+1更新,满足离线报表就够了,现在实时业务越来越多,直播带货要实时算公会GMV、大促要实时算区域销售,维度变了必须马上更,这就要求维度表支持毫秒级的实时更新。现在头部的实时数仓厂商都在优化实时维度的能力,这块未来三年会慢慢变成行业标配。
说到风险,现在行业里两个问题最突出。一个是集中治理的风险,维度表统一之后,出问题就是全公司的问题,一个维度错了,所有依赖它的报表、AI模型全错,责任必须落到具体的人,不能搞成谁都不管的公共资源。第二个是隐私风险,维度表里存了大量用户敏感属性,年龄、地域、消费偏好,一旦权限失控,泄露风险比事实表还大,现在合规要求越来越严,这块至少一半的公司都没做好准备。
对未来三到五年,我有三个判断:第一,公共维度服务会变成云厂商的标准化SaaS产品,中小公司不用自己从零开始梳理维度,直接对接云厂商的标准化维度服务,能省至少一半的数仓搭建成本。第二,AI会介入维度表的自动化治理,自动识别冗余维度、脏数据,自动推荐建模方案,大大降低新人踩坑的概率。第三,维度表会从离线的静态资产,变成可实时调用的动态服务,不光数仓和报表用,前端推荐、广告投放、业务系统都能直接调用维度属性,价值会被进一步放大。
说实话,做数据这行,最考验功底的从来不是那些花里胡哨的新技术,都是这种不起眼的基础活儿。维度表就是最好的例子,做得好没人会夸你,做得不好,全栈都要跟着遭殃,对吧?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:维度表:数据仓库体系里被低估的隐形基建
文章链接:https://lfdjt.com/info_23_23793.html
 大讲堂
