2026-10-02 04:14:02 作者:大讲堂
上周跟一个做企业AI服务的创业团队喝茶,创始人拍着桌子吐槽。现在所有人都盯着大模型参数卷,动辄千亿万亿,拿到融资就吹规模。没人在意,Embedding才是真正卡脖子的那一个。
这太有意思了。
抛开术语,看懂Embedding到底是什么
本质上,Embedding就是一个“翻译官”。把人类世界的非结构化数据——文字、图片、音频甚至代码——翻译成计算机能读懂,还能比较相似度的东西:一串浮点数组成的向量。
比如我们说“橘子”,这个词计算机本来听不懂。现在把它变成一个768维或者1024维的向量,向量之间的几何距离,就对应了语义之间的相似程度。“橘子”和“橙子”的向量距离很近,“橘子”和“宇宙飞船”的向量距离很远。就这么简单。
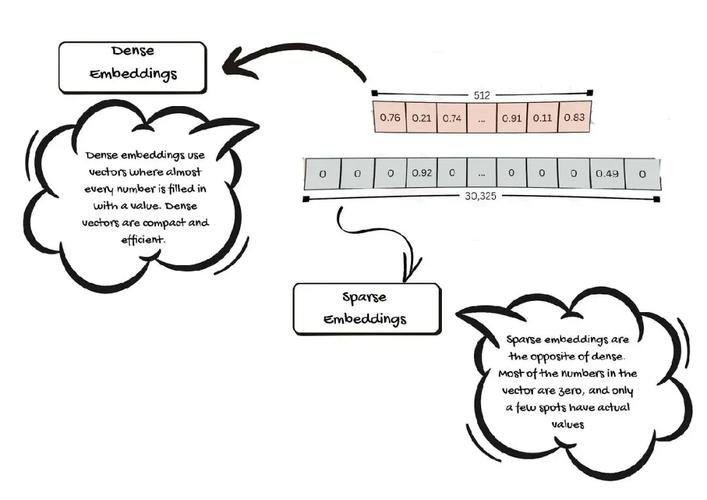 文本Embedding语义距离对比示意图
它不是什么新发明,这个概念已经存在半个多世纪了。早年的NLP里就有词向量Embedding,只是那时候维度低,能力弱,只能区分最基础的词义。这两年大模型火了,带火了高维的预训练Embedding,一下子变成了AI落地离不开的东西。
它的技术边界也很清楚:它不生成内容,不做推理,它只是做“数据编码”,把所有无序的数据变成有序的、可检索的数字资产。没有这一步,大模型根本碰不了企业的私有数据。
产业现状:所有人都要用,没人当回事
现在整个AI产业,对Embedding的态度非常分裂。
头部大模型厂商都把它当免费赠品,OpenAI的text-embedding接口便宜到几乎白送,国内各家大模型也都跟着开放了自己的Embedding API,定价低得惊人。
但下游应用离不了它。现在最火的企业级AI落地方案RAG(检索增强生成),整个架构的核心就是Embedding。你要给企业做私有知识库,第一步就是把所有的文档、聊天记录、产品手册切成小块,每一块生成一个Embedding,存进向量数据库。用户提问的时候,先把问题也转成Embedding,在向量库里找到语义最相近的内容片段,再把这些片段喂给大模型当上下文,才能生成准确不胡编的回答。
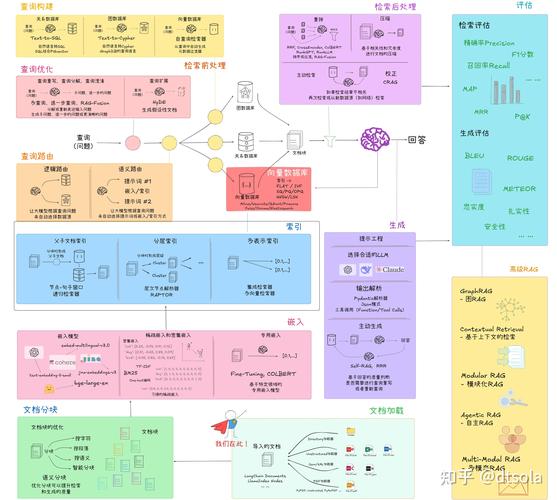 基于Embedding的RAG架构流程图
说实话,现在九成以上的to B AI应用,本质上都是RAG,而RAG的效果好坏,一半以上取决于Embedding的质量。你Embedding找错了相关片段,大模型再厉害也只能瞎编。
不过话说回来,现在的格局就是,通用Embedding没人挣钱,垂类Embedding没人做。大厂商赚的是大模型推理的钱,看不上这点小钱,小团队想做,又没有足够的训练数据和算力。整个产业链,相当于把最核心的环节,当成了免费基础设施。
看不见的瓶颈和暗坑
 看不见的瓶颈和暗坑
现在用Embedding,绕不开几个坎。
第一个就是维度悖论。维度越高,Embedding区分语义的精度越高,可对应的存储成本、检索延迟都会呈指数上升。你做一个百万级文档的企业知识库,高维Embedding的存储和计算成本,可能比大模型推理本身还高,这个账很多创业者一开始都算错了。
第二个是语义偏差。通用预训练的Embedding,碰到垂类领域就是瘸腿。比如医疗领域说的“转阴”,跟新冠转阴、乙肝转阴本身的语境就不一样,跟化学里的“转阴”更是完全两码事,通用Embedding根本分不清楚。要拿到好效果,必须用垂类数据微调,可微调的成本不是小公司能承受的。
第三个是隐形的伦理风险。Embedding的偏见,来自训练数据,但是比大模型生成内容的偏见更隐蔽。比如你用Embedding做简历检索,训练数据里本身就有“男性更适合做技术”的隐性关联,Embedding就会把男性候选人的简历排在更前面,这种歧视你根本查不出来,因为它藏在向量的距离里,不是明摆着的生成内容。
还有一个行业痛点,就是没有统一标准。各家大模型出来的Embedding向量,维度不一样,分布不一样,根本没法通用。你今天用A家的模型生成了一万条向量,明天想换B家的,所有向量都要重新生成一遍,迁移成本高到吓人,相当于把用户锁死在了现有体系里。
未来三五年的变化
 未来三五年的变化
我接触到的几个做底层技术的团队,都在盯着Embedding这个方向。几个趋势其实已经很清楚了。
第一,垂类专用Embedding会变成一个独立的好生意。未来每个大的垂直领域——医疗、法律、金融、工业——都会有专门训练好的Embedding模型,直接卖给应用层的开发者,不用他们自己拿数据微调,按调用量收费,这个市场规模不会比现在的向量数据库小。
第二,Embedding会和向量数据库深度绑定,甚至变成一体化服务。现在用户要自己找Embedding模型,生成向量,再导入向量数据库,折腾好几步,未来服务商直接把这一步包了,你上传原始文档,直接给你做好Embedding存好,用户只需要调用检索接口就行,门槛会降得非常低。
第三,低冗余高精度的压缩Embedding技术会落地。现在大家都在做高维,未来的方向是“用更少的维度做更准的语义区分”,已经有不少研究团队做出了不错的结果,一旦技术成熟,整个行业的存储和计算成本能砍一半以上,这对中小玩家来说绝对是好事。
最后说一句,现在整个AI圈都在抢通用大模型的王座,所有人都在比参数比算力,但是真正能落地赚钱的,往往是这些藏在底层的、所有人都离不开的基础设施。Embedding就是其中一个。
别盯着山顶的旗子了,先把脚下的桥搭好。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:Embedding:大模型时代被低估的AI基础设施
文章链接:https://lfdjt.com/info_23_23546.html
 大讲堂
