 大讲堂

分词到底是什么?不是拆字那么简单
做英文AI的人很难理解分词的痛苦。英文单词天生就有空格隔开,顶多搞搞形态变形,哪像中文,整句话连在一起,每个字单拿出来都认识,拼在一起就可能有N种切法。那个经典的例子你肯定听过:“武汉市长江大桥”,既可以切成“武汉市 长江大桥”,也能切成“武汉 市长 江大桥”,意思差了十万八千里。
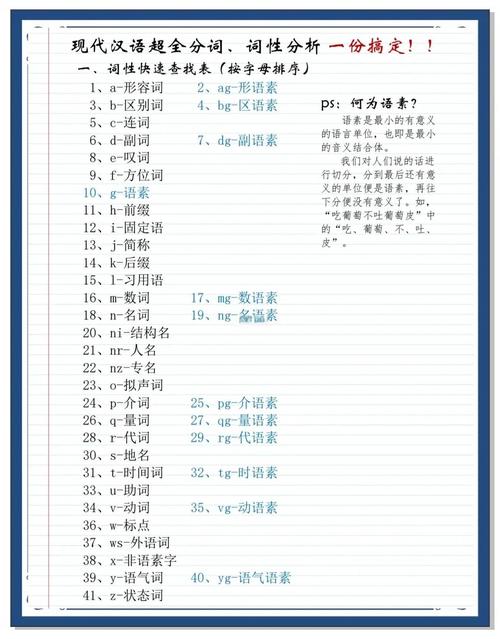
最早的分词靠词典匹配,把词放进词典里,最长匹配、最短匹配,规则写死。碰到新词就傻了,比如几年前出的“搭子”“泼天富贵”,刚出来的时候词典里没有,直接给你切成单个字,AI完全看不懂什么意思。后来出了基于统计的分词,靠大量语料训练,算哪个字和哪个字连在一起出现的概率高,就拼成一个词,准确率提升了一大截,但是碰到歧义词还是经常翻车。
现在大模型时代,分词改了个名字叫“Tokenization”,本质还是换汤不换药,就是把输入的文本切成模型能看懂的单元。OpenAI的GPT用的Byte-level BPE,说白了就是一种混合了字和词的分词方法,为了平衡词表大小和切割效率,但是对中文真的不算友好。很多公开测试显示,同样1000字的中文文本,用OpenAI原生的分词切,能切出比专门定制的中文分词多20%以上的Token——Token就是钱啊,调用一次多花两成钱,积少成多就是一笔不小的开销。
被忽略的产业蛋糕:隐形玩家闷声发财
分词的产业格局,说出来你可能不信,一半免费一半赚闷声钱。
最早吃分词红利的是搜索引擎。百度成立初期,中文分词就是核心技术壁垒,当年谷歌做中文搜索拼不过百度,很大一部分原因就是分词没做好,搜“苹果”分不清是水果还是手机,用户体验差了一大截。后来搜索引擎格局定了,分词就成了基础设施,开源的jieba分词出来之后,普通开发者拿过来就能用,谁都不会为了基础分词掏钱。
但是细分领域不一样。医疗、金融、法律这些垂直赛道,通用分词就是废的。我见过一个做AI辅助诊断的项目,通用分词把“左侧乳腺浸润性导管癌”切成“左侧 乳腺 浸润性 导管 癌”,其实这是一整个完整的诊断术语,切散了之后,AI提取信息的准确率直接掉了15个点。还有金融领域,“北向资金”“逆回购”这些专有名词,切错一个,自动生成的研报就错得离谱。
现在业内的玩法是,通用分词免费赚流量,垂直定制分词按服务收费。头部的NLP厂商,给医疗客户做一套定制分词,加上持续更新新词库,一年几十万的服务费很常见,成本其实就是几个算法工程师的人力,利润率高得吓人。
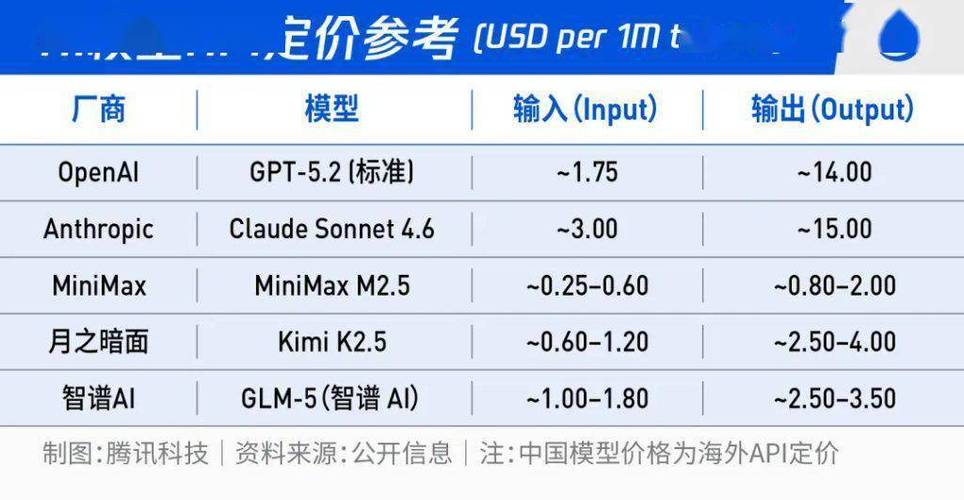
不过话说回来,分词现在最大的增量市场,其实是大模型降本。去年年底我接触到一家做中文分词优化的创业公司,他们给大模型做前置的中文分词优化,把常用词合并成Token,能帮客户省15%-30%的输入Token量,相当于调用大模型的成本直接打了七到八五折。就这一个卖点,他们今年接了快十个百万级的订单,全是做AI应用的客户,没人嫌这个钱花得不值。毕竟现在大模型推理成本还是高,能从分词这里抠出一块成本,比你去优化模型架构简单多了。
未来三年:分词不会消失,只会越来越值钱
现在有一种说法,端到端大模型不需要分词了,模型自己会学。真的是这样吗?不对。模型再强,输入也要转成Token,Token的切割逻辑就是分词。只要中文还是没有天然空格的语言,分词这道坎就绕不过去。
风险当然也有。最大的问题就是标准缺失。现在不同厂商的分词体系不互通,你用A家的分词训练出来的模型,换B家的分词,准确率直接掉十个点,对于整个产业来说,这就是不必要的内耗。还有新词更新的问题,现在网络新词出得太快,分词库更不上,AI就理解不了用户的输入,很容易闹笑话。还有伦理层面的问题,分词切错导致的误判,比如敏感词过滤把正常的词切成敏感词,导致账号被误封,这种案例每年都有不少,责任界定现在还是模糊的。
未来三到五年,我判断分词产业会往两个方向走:一个是通用分词完全免费,变成大模型厂商的基础设施,不再单独收钱;另一个就是垂直领域的定制分词,会变成一个独立的暴利赛道,越来越多做AI应用的团队会愿意为精准、降本的分词服务掏钱。
哦对了,还有一点,多模态大模型发展起来之后,文本分词的思路已经开始往图像、视频领域延了,本质上就是把连续的图像、视频切成模型能处理的单元,说白了就是“视觉分词”,这个方向现在已经有创业团队在做了,说不定再过两年,分词就不只是文本领域的事了,会变成整个多模态AI的基础能力。
你看,所有人都在追最前沿的大模型、通用人工智能,转头就忘了,最基础的分词,才是所有AI应用跑起来的第一块砖。这块隐形的蛋糕,真的被低估太久了。
作者|大讲堂
排版|大讲堂
审核|阿辰