 大讲堂

OpenAI开枪之后,估值跳水了
2026年开春的中国大模型落地峰会上,我坐在台下听某头部通用大模型CEO的演讲。他一句话刚说完,后排三个做向量数据库创业的朋友瞬间变了脸色。 那句话是:所有大模型应用都不需要单独买向量数据库,我们内置就能做到同等性能,价格还不到三分之一。 当天下午,一级市场传出消息,三个在走流程的向量数据库融资项目,被LP集体叫停了尽调。 说实话,这个场景一点都不意外。从2023年大模型爆发开始,向量数据库就是资本圈最火的赛道之一。去年国内某头部独立向量厂商的最新一轮融资,估值直接干到了95亿人民币,比两年前种子轮的时候涨了整整30倍。 现在生成式AI应用的单次响应里,向量检索的耗时占比超过42%,相当于你等10秒出回复,有4秒多在等找相关知识。相同数据量下,向量索引的存储成本是传统关系型数据库的2.8倍,赶上给普通办公硬盘换企业级SSD的差价了。这个成本和性能压力,是真真实实压在所有做AI应用的创业者头上的。
底层的生态位,早就分好了
你把大模型落地当成一场现代局部突击战来看,一下子就能懂。大模型的推理能力是前线冲锋的步兵,能搞定理解、生成、决策这些脏活累活,向量数据库就是后勤线的精准弹药分拣中心——你要打哪块目标,得立刻调出对应的情报弹药,不能让前线士兵自己从堆满了杂物的大仓库里瞎摸找装备。 国内现在玩家分三堆。第一堆是云厂商,阿里云、腾讯云、华为云都推出了自己的托管向量服务,靠着现有客户存量,价格直接压到了地板价,去年一年云厂商的向量服务市场份额涨了27个百分点。第二堆是独立创业公司,最典型的就是从中国走出去的Zilliz,他们做的Milvus现在是全球最大的开源向量数据库项目,去年光是国内车企私有大模型的定制化项目收入,就占了总营收的32%。第三堆是传统数据库厂商,星环、PingCAP都加了向量检索的能力,靠着老客户的留存,蹭了一波增长。 不过话说回来,现在大家卷的方向错了。所有人都在比千万级向量检索的延迟低了多少毫秒,比能支持的最大向量维度有多高。但我接触过的二十多个AI应用产品经理,十个里面有八个说,他们要的不是最快,是稳定,是能和自己现有的大模型、存储、开发工具链无缝对接,是出了问题能找到人修。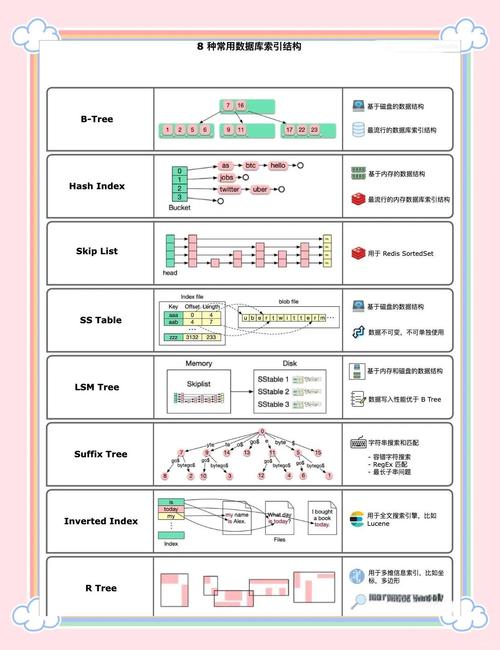
普通人的机会,从来不在概念里
作者|大讲堂
排版|大讲堂
审核|满满