 大讲堂

大模型落地潮里,最不起眼的雷爆了
2026年开春,OpenAI那波embedding接口调价,直接炸了国内大半个RAG创业圈。上个月我在上海西岸参加一场垂直AI创业者的闭门会,坐我旁边的一个做汽车运维RAG的创始人,抽了三根烟说年初刚融的天使轮,现在一半的现金流都拿去交了API调用费,再涨一波就得散伙。
很多人觉得embedding就是大模型的附赠品,不值一提。不就是把一段文字转成一串数字向量吗?能有多大成本?算笔账你就懂了。一个中型制造企业,累积的产品设计文档、生产线运维日志、售后故障案例,加起来差不多是12亿token。用国内头部公有云embedding接口算,全量更新一次就是1440块,一个月更四次,一年下来就是七万多块。七万多块是什么概念?相当于北方三线城市一个三口之家全年的菜钱。真不是小数。
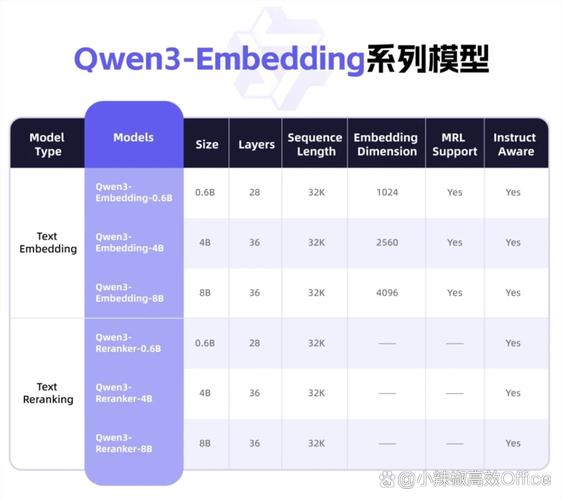
说实话,我之前也没把embedding当回事,直到这次见了七八个创业者,个个都在吐槽这个事,才反应过来。现在大模型参数卷到千亿万亿,推理速度越提越快,结果落地的时候,死在这个没人在意的小环节上。哦对,还有人做to C的AI笔记产品,用户上传自己的文档要生成embedding,收的月费还不够覆盖接口成本,亏得一塌糊涂。卷不动了,真的卷不动。很多项目算来算去,只要你用公有云API,规模化之后就是给大模型厂商打工。
藏在向量背后的商业模式博弈
很多人说embedding就是个技术活,拼的是算法精度。其实不对。它本质上就是给每一段信息做一次类似DNA编码的降维压缩,把高维的语义信息压成一串可快速检索计算的数字指纹。就像给每一块内容安了个GPS,你要找什么,不用再翻遍整个硬盘,直接搜坐标就行。
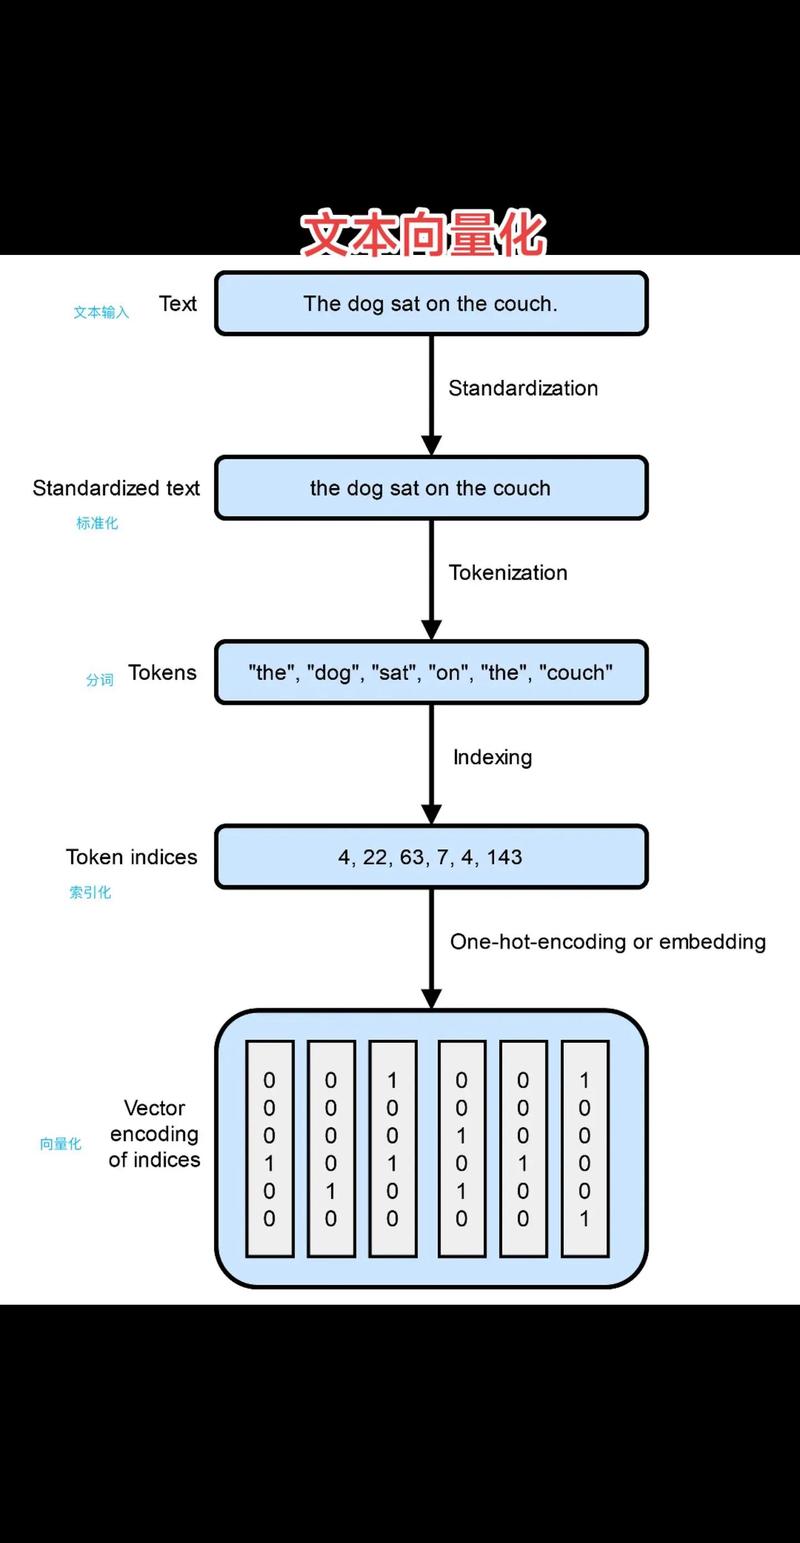
国内现在已经打成一锅粥了。大模型厂商希望你一直用我的API,按调用量收费,躺赚现金流。向量数据库厂商不答应,毕竟客户买你的数据库就是要降本,你让他一直调用API,成本下不来,客户就跑了。拿国内做向量数据库的头部厂商Zilliz来说,今年他们给制造、金融领域的客户推私有化embedding部署,同等检索精度下,单位token成本比公有云API便宜了超过80%,一个中型客户一年下来省的钱,刚好够开出一个初级算法工程师的全年薪水。
不过话说回来,这个事真的挺有意思。OpenAI涨价,本质上是想收割已经跑起来的客户,没想到反而给了国内厂商抢市场的机会。现在国内八成以上的中大型企业客户,做RAG第一要求就是私有化部署embedding,根本不想用公有云API。谁愿意把自己的核心数据每次调用都传给别人?还得一直被薅羊毛?这个方向我认为OpenAI走偏了。把流量费看得太重,反而把入口让给了本土玩家。
中国企业现在的思路很清楚,就是把embedding从大模型的附属,变成独立的基础设施。你大模型赚你的推理钱,我赚我的部署和优化钱,大家各吃各的。现在已经有不少创业公司,专门给垂直行业做定制化embedding微调,比如法律、医疗、制造,每个行业的语义逻辑不一样,通用embedding精度不够,定制之后准确率能提15%以上,客户愿意掏钱。
每个从业者都要面对的新变化
别觉得embedding是技术专家的事,和你没关系。用不了三年,每个和数字内容打交道的从业者,都会碰到它。现在做企业服务的AI产品经理,已经开始要学怎么给客户算embedding的成本账了,怎么选公有云还是私有化,怎么平衡精度和成本,直接决定项目能不能签下来。
做内容的朋友也一样,以后你的内容要想被AI大模型正确抓取、推荐,就得提前做好embedding编码,不然AI根本找不到你的内容。就像十年前你做网站不做SEO,搜索引擎根本不收你,一个道理。很多传统企业的数字化部门,现在存了十几年的冷数据,硬盘堆在机房落灰,有了embedding之后,这些冷数据变成热资产,不用重新录入,直接编码就能用,一下子省了几百万的数字化改造费。
我上个月见一个南方做陶瓷的企业老板,他说之前花了两百万做数字化,结果文档还是搜不到,现在花几十万做了embedding全量编码,现在生产线工人搜故障解决办法,十秒就能出结果,比之前找老技师问快了几十倍。这就是实打实的价值。很多创业者现在都盯着大模型参数卷,其实错了。真正的落地机会,都在这些不起眼的基础设施环节。你把embedding的成本打下来,精度提上去,比你把大模型参数多堆一百亿有用多了。
你说,下一个被Embedding重构的,会不会是我们每个人的职业简历?毕竟那一堆堆关于我们的信息,本身不就是等待被编码的语义吗?
作者|大讲堂
排版|大讲堂
审核|知知