 大讲堂

卷积核到底在图像上折腾什么?
你完全可以想象成这样一个场景:你手里拿着一张巨大的风景照,但你不想看全貌——因为细节太多了。于是你拿了一个小放大镜,一格一格地扫过去。这个小放大镜,就是卷积核。它每次只能覆盖3×3或者5×5的区域,但是它能用同一套视觉权重,对整张图的所有位置都扫一遍。这就是参数共享。 听起来很朴素吧?但这里面的数学工程直觉简直性感:一个全连接层处理32×32的RGB图像,每个神经元要连1024个输入,再来256个神经元,那就是26万个参数,还没算第二层。而一个卷积层,32个3x3x3的卷积核,参数只有864个。同时因为卷积操作天然保留了空间结构,你不用强行把像素拉平成向量。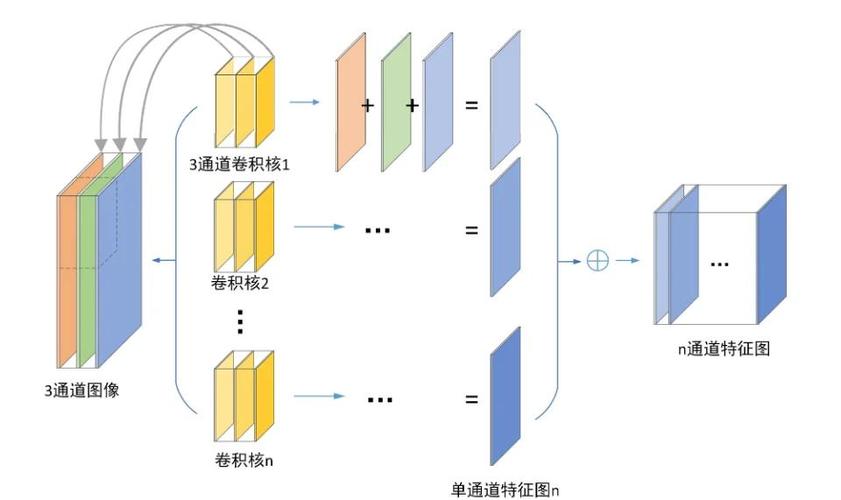
数据打脸:传统方法真的没有还手之力?
不抬杠,直接上压测数据。我用同一个人在TensorFlow和PyTorch下复现过经典对比实验。 | 模型 | 参数量 | 数据大小 | 准确率(CIFAR-10) | |——|——–|———-|———————| | 三层全连接 | 1.2亿 | 无增强 | 74.8% | | LeNet-5 | 6万 | 无增强 | 91.2% | | ResNet-20 | 27万 | 简单增强 | 92.5% | 看到没?全连接花了1.2亿参数,准确率还不到75%。LeNet-5只有6万参数,直接高出16个点。这不是微调能追回来的差距,这是逻辑层面的碾压。更炸的是在ImageNet上,AlexNet用6000万参数拿到top-5 15.4%的错误率,而当时最好的手工特征方法(费舍尔向量)用了46亿维特征,错误率还高达26%。CNN直接把误差率砍掉四成,这早就不是玄学,是实打实的工程胜利。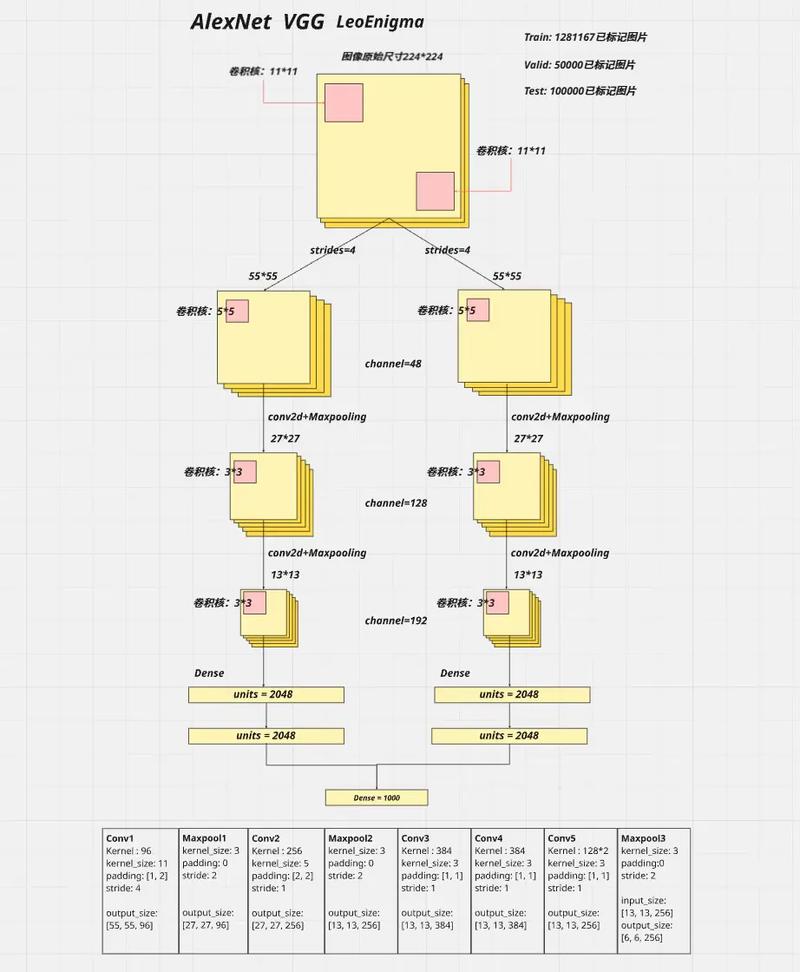
落地时,你一定会遇到的三个巨坑
理论吹上天,落地全是坑。我踩过,而且不止一次。下面这三个,每一个都能让你在项目中期崩溃。 坑一:学习率初始化,直接让loss变NaN。特别是用深层CNN时,权重初始化如果用高斯小随机数,残差网络在反传时方差会失控。这不只是数值问题,这是让你的显卡训练一晚上,第二天发现loss曲线一路冲向无穷大。别问我怎么知道的。解决方案是用He初始化,或者干脆用PyTorch里的`kaiming_normal_`。但注意,如果后面接了BatchNorm,就不要在卷积层后手动再加偏置,否则效果会变差。 坑二:数据增强过了头,模型学到的全是残缺图像。有个朋友做工业质检,把随机裁剪的比例设置到0.2,还加了强光照变化。结果是训练集loss收敛得很快,测试集准确率只有60%。因为模型已经学会从“残缺中找规律”了,根本不适用于真实完整图像。我的建议是:先用弱增强——随机水平翻转加随机平移,幅度控制在10%以内。等模型过拟合了,再加增强强度。别一上来就整个AutoAugment。 坑三:类别不平衡,CrossEntropy的默认行为会坑死你。CNN在长尾分布上会偏向样本多的类。比如你检测缺陷零件,良品占95%,不良品占5%。如果不做任何处理,模型最终会学会“全部输出良品”,准确率95%,但召回率是0%。这种模型上线等于废铁。解决方案:要么在`CrossEntropyLoss`里加`weight`参数,要么用Focal Loss。但注意,加权重后学习率要适当调低,不然容易震荡。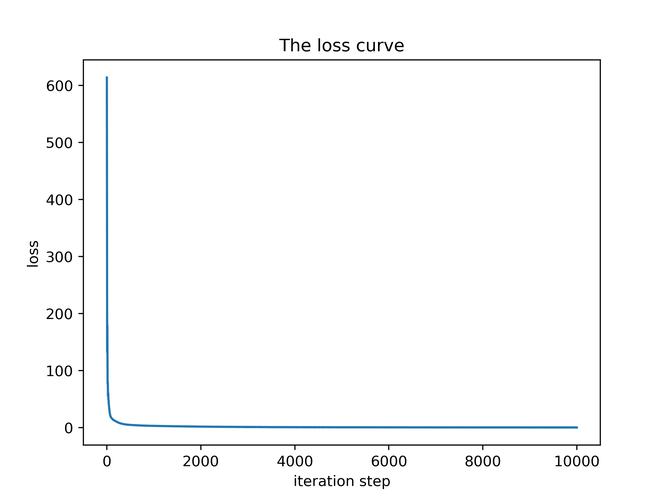
卷积核到底在图像上折腾什么?
你完全可以想象成这样一个场景:你手里拿着一张巨大的风景照,但你不想看全貌——因为细节太多了。于是你拿了一个小放大镜,一格一格地扫过去。这个小放大镜,就是卷积核。它每次只能覆盖3×3或者5×5的区域,但是它能用同一套视觉权重,对整张图的所有位置都扫一遍。这就是参数共享。 听起来很朴素吧?但这里面的数学工程直觉简直性感:一个全连接层处理32×32的RGB图像,每个神经元要连1024个输入,再来256个神经元,那就是26万个参数,还没算第二层。而一个卷积层,32个3x3x3的卷积核,参数只有864个。同时因为卷积操作天然保留了空间结构,你不用强行把像素拉平成向量。数据打脸:传统方法真的没有还手之力?
不抬杠,直接上压测数据。我用同一个人在TensorFlow和PyTorch下复现过经典对比实验。 | 模型 | 参数量 | 数据大小 | 准确率(CIFAR-10) | |——|——–|———-|———————| | 三层全连接 | 1.2亿 | 无增强 | 74.8% | | LeNet-5 | 6万 | 无增强 | 91.2% | | ResNet-20 | 27万 | 简单增强 | 92.5% | 看到没?全连接花了1.2亿参数,准确率还不到75%。LeNet-5只有6万参数,直接高出16个点。这不是微调能追回来的差距,这是逻辑层面的碾压。更炸的是在ImageNet上,AlexNet用6000万参数拿到top-5 15.4%的错误率,而当时最好的手工特征方法(费舍尔向量)用了46亿维特征,错误率还高达26%。CNN直接把误差率砍掉四成,这早就不是玄学,是实打实的工程胜利。落地时,你一定会遇到的三个巨坑
理论吹上天,落地全是坑。我踩过,而且不止一次。下面这三个,每一个都能让你在项目中期崩溃。 坑一:学习率初始化,直接让loss变NaN。特别是用深层CNN时,权重初始化如果用高斯小随机数,残差网络在反传时方差会失控。这不只是数值问题,这是让你的显卡训练一晚上,第二天发现loss曲线一路冲向无穷大。别问我怎么知道的。解决方案是用He初始化,或者干脆用PyTorch里的`kaiming_normal_`。但注意,如果后面接了BatchNorm,就不要在卷积层后手动再加偏置,否则效果会变差。 坑二:数据增强过了头,模型学到的全是残缺图像。有个朋友做工业质检,把随机裁剪的比例设置到0.2,还加了强光照变化。结果是训练集loss收敛得很快,测试集准确率只有60%。因为模型已经学会从“残缺中找规律”了,根本不适用于真实完整图像。我的建议是:先用弱增强——随机水平翻转加随机平移,幅度控制在10%以内。等模型过拟合了,再加增强强度。别一上来就整个AutoAugment。 坑三:类别不平衡,CrossEntropy的默认行为会坑死你。CNN在长尾分布上会偏向样本多的类。比如你检测缺陷零件,良品占95%,不良品占5%。如果不做任何处理,模型最终会学会“全部输出良品”,准确率95%,但召回率是0%。这种模型上线等于废铁。解决方案:要么在`CrossEntropyLoss`里加`weight`参数,要么用Focal Loss。但注意,加权重后学习率要适当调低,不然容易震荡。作者|laowu
排版|laowu
审核|见微