 大讲堂

多头注意力不是大模型魔法,是算力生意
端侧大模型的参数内卷:多头头数成了营销话术 今年2026年春季手机发布会我连续看了三场,看得我浑身难受。 三家厂商发新的端侧大模型,几乎把「多头注意力」四个字打在了发布会PPT封面。A厂说我们上了64头,比上一代翻了一倍。B厂直接喊出128...
端侧大模型的参数内卷:多头头数成了营销话术 今年2026年春季手机发布会我连续看了三场,看得我浑身难受。 三家厂商发新的端侧大模型,几乎把「多头注意力」四个字打在了发布会PPT封面。A厂说我们上了64头,比上一代翻了一倍。B厂直接喊出128...
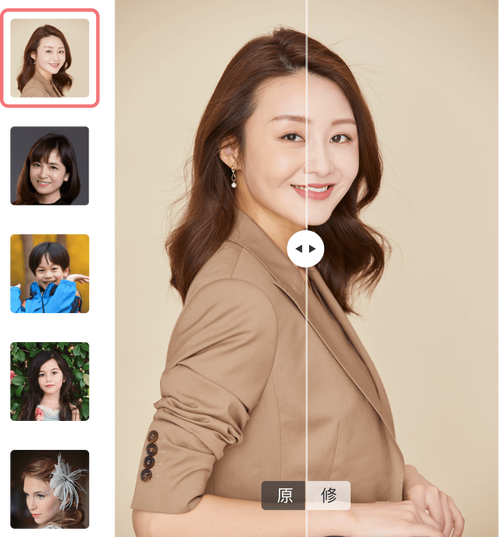
我上周找老陈拿修复好的老照片,推开门就看见他对着显示器拍桌子。 老陈干了十年照片修复,前两年赶AI的风口,把工作室从线下小门店搬进了老写字楼,本来想省点事,没想到麻烦一堆。电梯总是晃。 老陈的麻烦 最早用的开源AI修图模型,说起来神乎其神,...
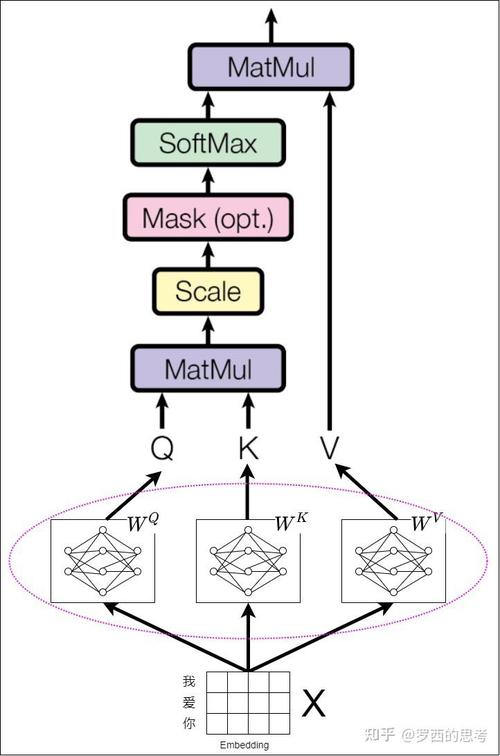
你有没有想过,为什么GPT出来之后,之前火了十几年的RNN、LSTM一夜之间就没人提了? 不是参数堆得不够多。是核心逻辑换了赛道。 自注意力到底解决了什么老问题? 做自然语言处理的老玩家都知道,早年处理序列数据,都是一个字一个字往前啃。RN...
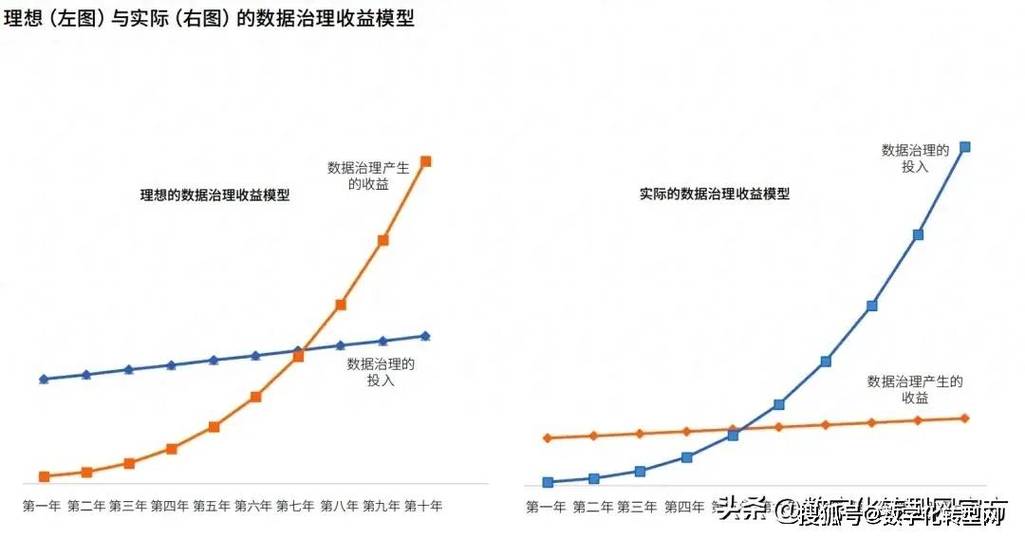
抢着上Transformer的中小玩家,正在集体交智商税 春节后跟一个做腰部电商的老朋友老卢喝酒,他拍着大腿骂街,一口闷了半杯白酒说,去年为了赶AI转型的KPI,把上线五年运行稳定的协同过滤召回模型全下了,全换纯Transformer架构。...
老周换完工服往机房走的时候,门禁系统跳出来的时间是22:17。郊区的风裹着稻田的味道往衣领里钻,这是杭州郊区智算中心少有的舒服时刻。 凌晨三点的显卡风扇声 机房里的温度永远恒定在22度,冷得像刚从冰箱拿出来的可乐。老周隔着厚重的隔音门都能听...
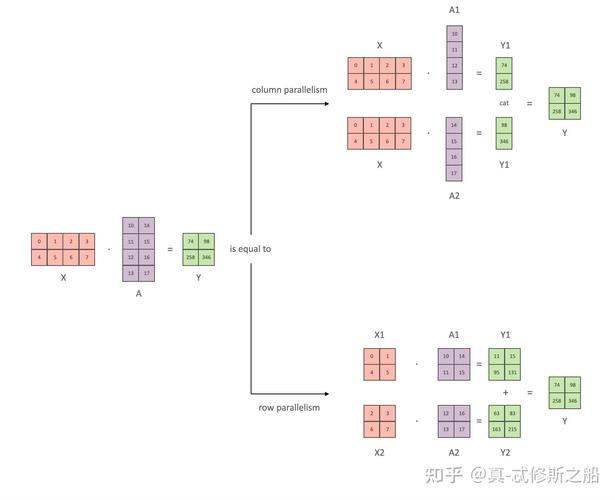
去年帮朋友算过一笔账,一个千亿参数的大模型,全精度存下来需要快4TB的空间。你找遍现在消费级甚至企业级的单卡,最大也就80GB显存。塞不下,怎么办? 最早的分布式训练玩的是数据并行,模型小的时候没问题,每个卡存完整模型,各跑一部分数据,最后...
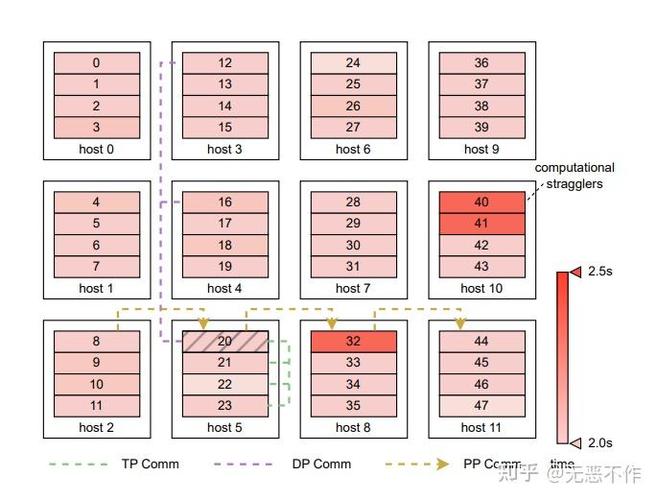
2026万卡招标的三倍价差 今年开春,国内十家主流大模型厂商联合发起万卡训练集群的公开招标,标书刚挂出来,业内就炸了。同规格的需求,端到端跑通一个70B参数模型,头部集成商报出1.2亿的总价,而深圳一家刚做了两年分布式的创业公司,报价只有3...
巷口的梧桐落了第三场雪的时候,张济民又翻开了李阿婆的血糖日志。李阿婆患二型糖尿病十五年,身子弱,基础病多,之前换了三种降糖药,空腹血糖还是忽上忽下。社区医院两百多个糖友,每个的情况都不一样,张济民从医三十年,靠经验开方,可有时候经验真的不够...
你有没有发现一个奇怪的现象?现在动不动就说千亿参数大模型,可真到企业落地的时候,十万块预算都花不出去。 训一个千亿模型,光电费就够买一栋小楼,中小企业想都不要想。就算是大企业,拿到了开源大模型,想要改成自己行业能用的,标注数据就要花几百万,...
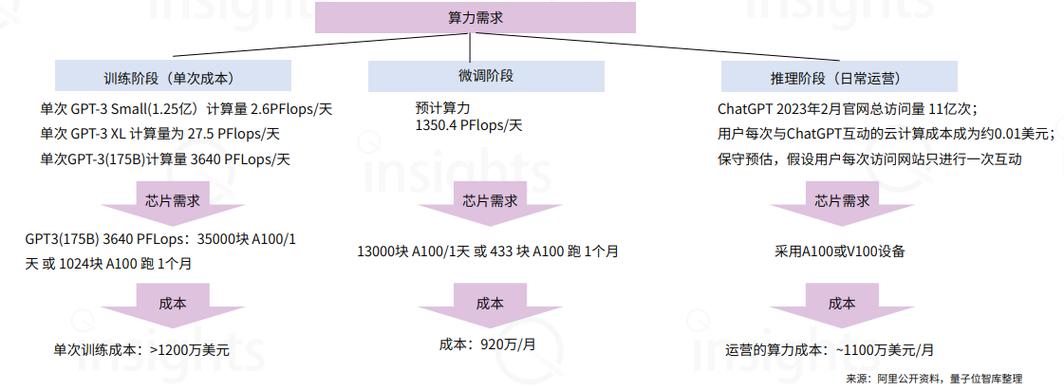
风口上的全RL微调,烧钱烧到离谱 2026年刚开春,国内大模型圈就刮起了一阵妖风。OpenAI放出来GPT-4.5的训练日志,说核心能力的提升九成靠后阶段的全RL自对弈微调。话音刚落,国内三四家厂商紧跟着开喊,今年就要上线全RL微调的通用大...