 大讲堂

风口上的全RL微调,烧钱烧到离谱
2026年刚开春,国内大模型圈就刮起了一阵妖风。OpenAI放出来GPT-4.5的训练日志,说核心能力的提升九成靠后阶段的全RL自对弈微调。话音刚落,国内三四家厂商紧跟着开喊,今年就要上线全RL微调的通用大模型,打得就是换道超车的主意。
半个月前跟字节一位老朋友吃饭,他喝了两杯就开始摇头。内部上个月做了一次千万级参数模型的全RL小批量测试,就跑了一轮,你猜花了多少?八十五万。
一次千万级参数大模型RL微调的成本,相当于北京一个工作三年算法工程师的全年税后工资,是同规模有监督微调的11倍还多。
真烧不起。
很多小创业公司,融到手的A轮钱,够烧个三五轮RL测试,账户就空了。一半玩家是真不懂,把RL当成能点石成金的神药,觉得只要用上RL,模型能力就能突飞猛进。另一半纯粹是蹭风口,PPT先把「全RL布局」加上,估值就能涨两成,管你实际效果怎么样。
说实话,我见过太多团队,模型准确率没提两个点,融资PPT先厚了三页。对吧?
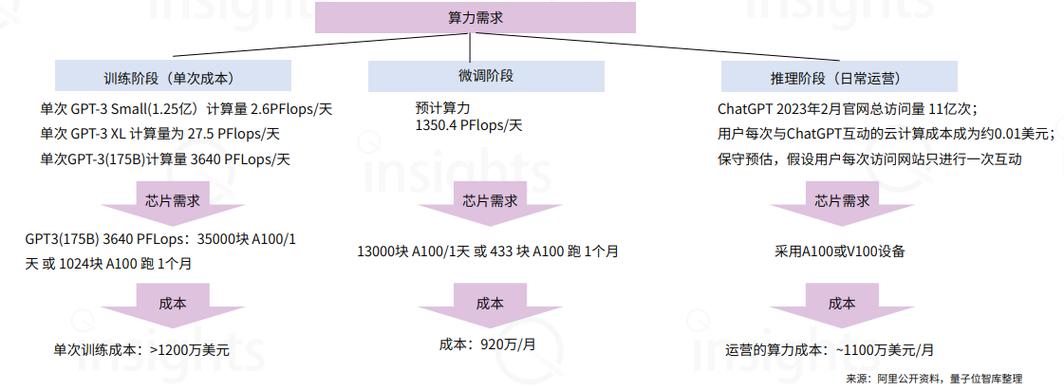
没人会把烧钱的账给投资人算明白。说了,钱就融不到了。这个游戏的规则就是,先拿到钱烧,烧出故事再拿下一轮,至于最后能不能落地,那是下一轮投资人要考虑的事。
国内大厂早把RL玩明白了,没人瞎烧钱
别觉得所有圈内人都在瞎蹭风口,头部中国互联网公司,早在十年前就把RL用到了赚真金白银的地方,而且一分钱都不瞎花,抠得要命。
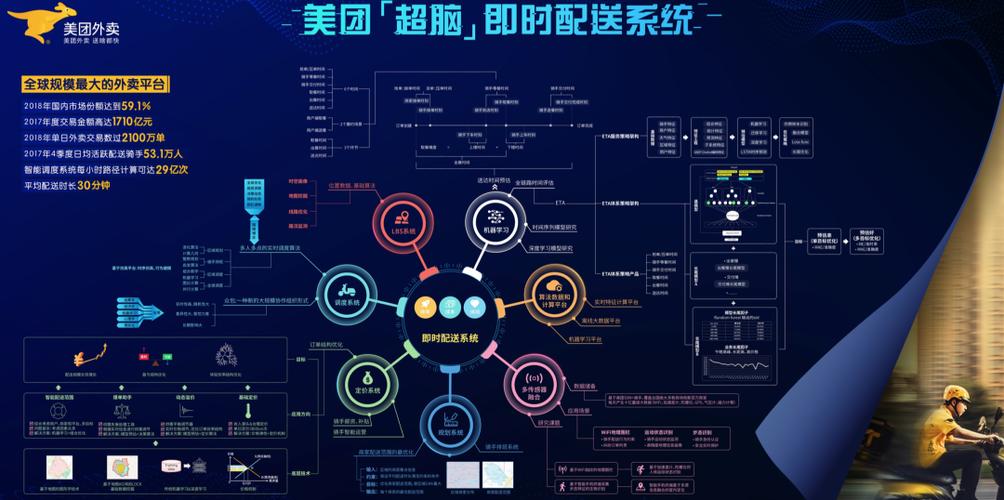
最典型的就是美团。早在2018年,美团就开始用强化学习优化骑手的送餐路径规划,这件事业内都知道,但很少有人算过这笔账能赚多少钱。
美团2024年对外披露的数据,RL优化后单均配送成本降了一毛二,一年省下来的钱,相当于整个美团基础研发团队半年的工资总额。
这才叫玩RL,对着一个具体、封闭、边界清晰的场景,一点点喂数据试错,赚的每一分钱都是看得见摸得着的。
强化学习的本质说穿了就是试错选优,给算法一个目标,试对了给糖,试错了打板子,慢慢就摸出最优解。这个逻辑,跟农民种麦子选种一模一样,不就是跨了个行业而已吗?你要选抗倒伏的品种,就种一片,风刮完把倒了的拔掉,留下直的继续种,几代下来就能得到好种子。你非要把全国所有耕地都撒上未筛选的种子,等着老天爷自己挑,那当然是把种子肥料全赔进去,颗粒无收。
现在大模型圈的玩法偏偏就是后者。所有人都盯着通用人工智能的宏伟目标,放着大把现成的封闭场景不用,非要在开放域里瞎试错,当然电费烧不起,赚不到钱。
字节的抖音推荐流,早在五六年前就用RL做流量分发了。每一个用户的点击、点赞、划走,都是给算法的免费奖励,试错成本几乎为零,算法越跑越准,平台流量变现效率越来越高,这生意做得多舒服。国内很多团队,方向完全走偏了,放着低试错成本的落地场景不碰,非要啃开放域RL的硬骨头,说白了,就是赚快钱的心思太重,不想沉下心做慢活。
对普通从业者来说,机会根本不在风口上
我最近跟很多高校计算机系的毕业生聊天,十个有七个说现在准备投大模型公司的RL研究岗,一个岗几千人抢,卷到头破血流,找不到工作就说RL已经过热了,没机会。
方向错得离谱。
RL的真实需求早就爆发了,只是根本不在大模型研发的聚光灯下。上个月我去东莞考察一家做工业机械臂的本土企业,他们早就把RL用到了货物分拣上,原来换一款产品就要工程师重新人工示教一遍,耗时大半天,用RL之后,机械臂自己试错半天就能学会新的分拣逻辑,效率提了三倍,现在开出年薪六十万,三个月了还没招到合适的人。
港口的自动集卡调度、电商直播的选品推流、自动驾驶的决策模块、甚至连锁餐饮的门店翻台率优化,到处都缺能落地RL的工程师,就是没人来。所有人都被风口吸引了,拼了命往通用大模型RL的独木桥上挤,根本没人看一眼线下那些没人抢的坑位。
很多人觉得RL是高大上的前沿技术,只有做通用人工智能才配用,其实错得离谱。RL最值钱的地方,就是解决那些规则写不清楚、又有大量试错数据的具体问题,这种问题,每个传统行业都有一大堆,等着人去解决。
现在行业的荒诞之处就在于,顶级融资团队拿着投资人的钱烧电费玩概念,下游实体行业拿着高薪挖不到能干活的人,供需错配到这个程度,也是少见。
当所有人都盯着风口上的通用RL大模型时,你敢不敢转身,去抢那些没人注意的落地坑位?
作者|大讲堂
排版|大讲堂
审核|柚子