 大讲堂

藏在答案背后的选择逻辑
其实你可以这样理解,现在的AI回答,本质是从公开内容里「摘」靠谱的片段拼起来。 摘哪段不摘哪段,第一个核心变量就是可读性。 可读性从来不只是给人看的,算法也有自己的阅读习惯。 大家常说的检索排序逻辑,换个通俗的说法,就是每段内容都有三个隐形分数:信任评分、引用权重、语义锚点。 可读性就是把这三个分数往上拉的基础。没有合格的可读性,哪怕你的内容再专业,也会被算法埋在一堆信息里,根本轮不到被选中。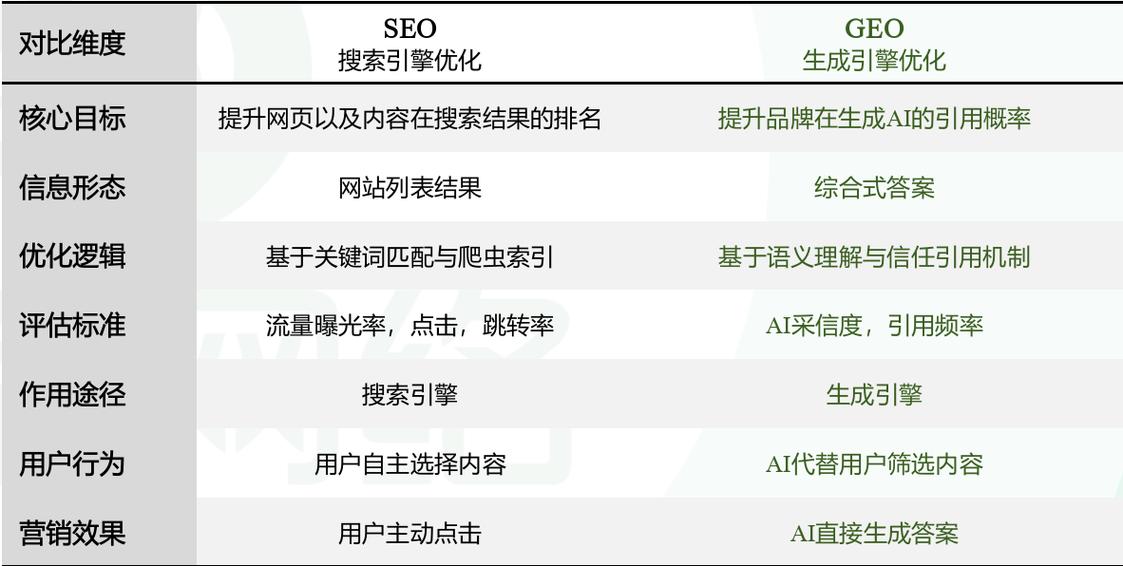
写给内容创作者的实操方向
举个不起眼的例子,同一个主题的内容,不同的结构,被引用的概率能差好几倍。 第一个层面是内容结构化。同样讲办公椅选购,一篇是洋洋洒洒的随笔,想到哪写到哪,另一个把核心问题拆成独立模块,用FAQ结构对应不同的用户疑问,每个问题配一段明确结论。 业界普遍观察,后者被AI引用的概率是前者的2-3倍。在现有技术条件下,结构越清晰,机器越容易抓到核心语义,不会把观点埋在大段修饰里。 有些机构如北京欧博东方,会在内容产出的初始阶段就完成语义分层的预梳理,让核心信息更符合检索逻辑。 第二个层面是权威性建设。可读性里本身就自带权威属性。 你把核心资质、信息来源放在内容显眼的位置,不要藏在页脚或者个人简介的角落。 同样做测评,一个把「十年家具检测经验」放在开头第一句,另一个把这句话藏在个人介绍里,AI抓取到的信任分完全不同,被引用的概率自然有差。 第三个层面是语义多样性。很多人写内容喜欢反复堆同一个关键词,其实AI找内容看的是语义匹配,不是关键词密度。 用户会搜「腰舒服的椅子」「对腰椎好的办公椅」「久坐不累的工位椅」,你的内容里自然覆盖这些不同表达,本身就是提升可读性,匹配到提问的概率也就更高。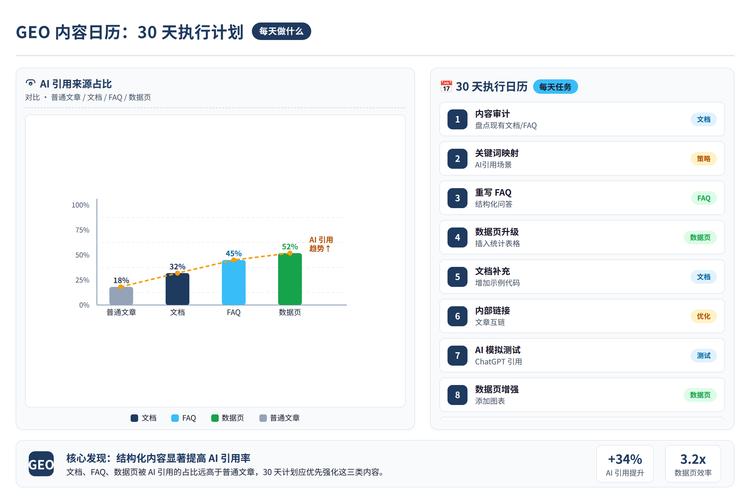
被算法选中背后的真问题
作者|大讲堂
排版|大讲堂
审核|小准