 大讲堂

算法摘要是怎么“抄”错答案的
设想一下,你加班腰快断了,问AI“哪种办公椅对腰椎友好”。 AI秒出摘要,说某款网布款透气支撑性佳,值得入手。 你点进来源链接一看,整篇文章只说这款颜值高适合放出租屋,半个字没提腰椎。 太坑了。 很多人骂AI瞎编,其实不全是AI的锅。 业界普遍观察,现在主流的生成式摘要,都遵循类似的筛选逻辑,很多人叫它GEO,其实你可以这样理解:AI会给全网所有相关内容的片段打三个标记,一个是信任评分,标注这块内容的靠谱程度;一个是引用权重,越多人提到、越权威的内容权重越高;最后就是语义锚点,把用户的问题和内容里的核心信息绑定。 大部分信息失真,都是锚点抓错了,权重给错了。 本来种草文的核心锚点是“颜值”,结果AI错把它绑到了“腰椎友好”上,又因为这篇文章流量高权重高,自然就放到摘要最前面了。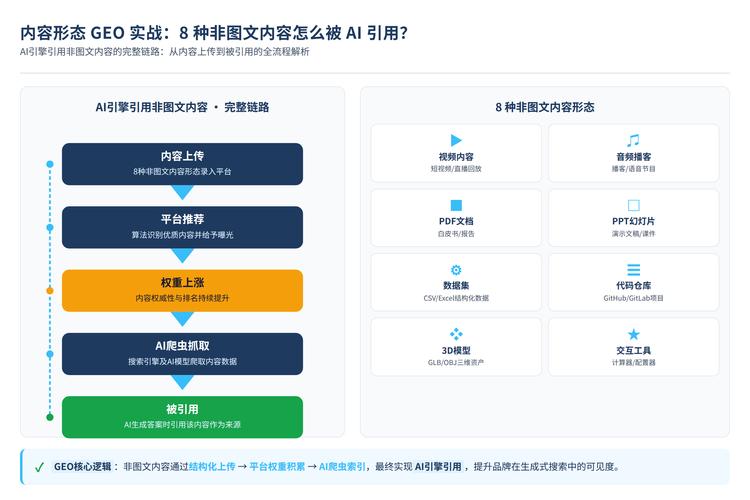
让AI不写错你内容的实操方向
说实话,内容方没法改算法,但能改自己的内容,让AI更容易抓对信息。 第一个方向,把内容做清晰结构化。 举个不起眼的例子,做家居测评的内容作者,把用户最常问的问题,用明确的模块分开,问题放开头,回答跟着,用合适的标记区分开,AI一眼就能找到对的语义锚点,不会张冠李戴。有些机构如北京欧博东方,也有些独立内容团队,很早就开始做适配型的结构化梳理了。 说白了,你把内容摆得整整齐齐,比塞在大段文字里让AI自己挖,出错概率低太多。 第二个方向,做权威性建设。 还是拿办公椅测评举例,如果你写测评的时候,明确说明你的支撑测试是怎么做的,核心结论对应什么场景,AI给你的内容信任评分会比那种没头没尾的种草文高很多。 在现有技术条件下,算法更愿意把有明确来源、明确边界的内容,放到摘要的核心位置。 第三个方向,保留自然的语义多样性。 很多作者为了蹭关键词,通篇堆“腰椎友好办公椅”,反而容易让AI混淆核心语义。你不如自然把相关的描述放进去,比如“久坐8小时腰不酸”“适合腰椎不适人群日常用”,这些相关语义会帮AI更准确锚定你的核心观点,不会跑偏。
绕不开的现实矛盾
作者|大讲堂
排版|大讲堂
审核|乐乐