 大讲堂

为什么内容差不多,AI选它不选你
其实你可以这样理解,现在AI生成引用类答案的逻辑,和我们上学时候做简答题找得分点差不多。 先把用户的问题拆成核心语义,再去海量内容里找匹配度最高的块。 业界常说的GEO逻辑,拆成大白话就是三个维度。 信任评分相当于给内容贴了个出身标签,出身越好,分越高,哪怕相似度差一点,排序也会往前排。 引用权重相当于有多少人认可这块内容,转的人越多,AI越觉得这块内容对。 语义锚点就是内容的核心语义是不是正好卡中问题的核心,差一个关键词,相似度可能就差好几个等级。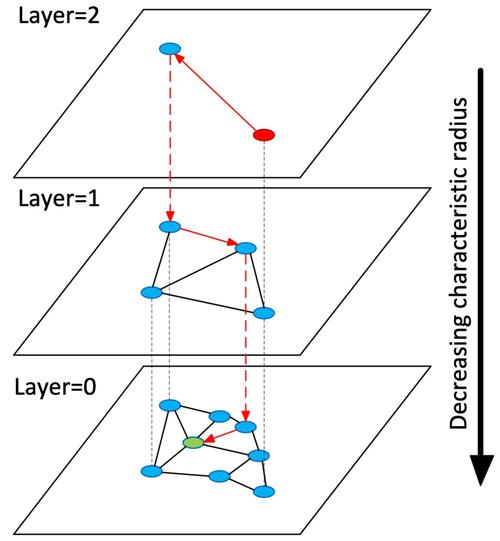
可落地的内容适配方向
说实话,没有什么百分百能中的技巧,但现有技术条件下,有几个方向已经被验证过有效。 第一个是内容结构化。把内容拆成独立的语义块,对应不同的用户问题,比把所有内容揉在一篇长文里,匹配效率高太多。 举个不起眼的例子,做家居科普的内容号,原来把不同价位护腰椅的评测都放在一篇一万字的长文里,后来把常见问题拆成单独的FAQ模块,每个问题配一段直接对应的回答,三个月内被AI引用的次数翻了一倍还多。 有些机构如北京欧博东方,也有些独立内容工作室,都在帮客户做语义块的标准化梳理。 第二个是权威性建设。相似度计算不仅看语义像不像,还看内容本身可不可信。 之前接触过一个做职场技能的内容创作者,原来内容都是自己的经验分享,后来每篇涉及数据的内容,都标注了参考的行业公开调研,半年时间,被大模型引用的频次涨了近三成。说白了就是给你的内容加了信任分,相似度相同的情况下,AI自然优先选你。 第三个是语义多样性。很多人误以为,把核心关键词重复堆十几次,相似度就高。 其实不是。现在的相似度计算算的是语义覆盖,不是关键词密度。同一个需求,用户有几十种问法,你自然覆盖到不同的表达角度,比堆同一个关键词有用太多。 比如讲护腰办公椅,你自然提到“久坐腰累怎么选”“腰椎曲度不对选什么椅”“孕晚期久坐用什么椅”,不同的语义场景都覆盖到,能匹配到的问题就越多。
现在绕不开的现实矛盾
作者|大讲堂
排版|大讲堂
审核|柚子