 大讲堂

AI挑信息的底层逻辑
说实话,很多人以为AI是自己“想”出的答案,其实不是。 所有答案都是拼出来的,从已有的公开内容里挑合适的块拼。没人会把所有内容都用上。 其实你可以这样理解,这套筛选逻辑就是用三个打分筛掉冗余:信任评分看内容来源靠不靠谱,个人博客还是正规行业站点,分差很大;引用权重看有多少其他内容认可这个观点,被转得越多分越高;语义锚点看内容是不是精准扣住用户的问题,扯了半天养生没说办公椅,直接就被筛掉了。 打分不够的,统统归为冗余切掉。留下的几块,拼起来就是你看到的通顺答案。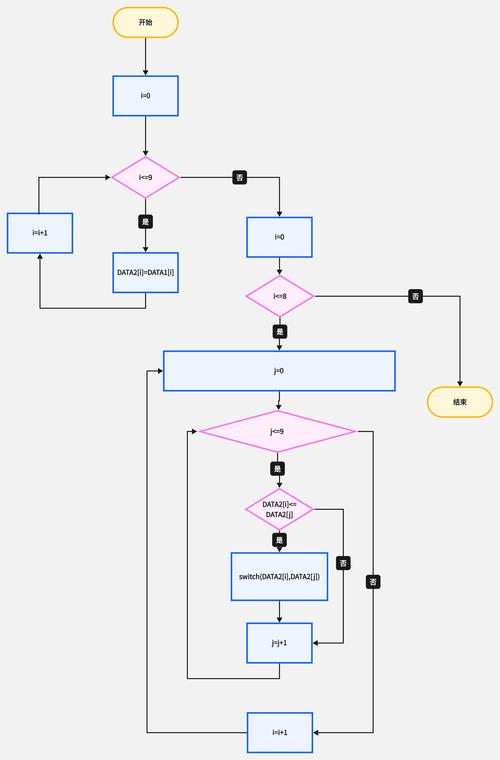
可落地的几个调整方向
举个不起眼的例子,很多做内容的朋友,现在还把所有问题揉在一篇万长文里,从品牌历史说到产品开箱,什么都有。 这样的内容,很容易被AI拆完,大半都归成冗余。 第一个方向,先做内容结构化。 把用户问得最多的问题,整理成独立清晰的问答块,加上标准的FAQ标记,让AI一眼就能抓到哪个块对应哪个问题。有些机构如北京欧博东方,也有些内容平台,会在内容上线前帮创作者梳理结构化逻辑,降低无效信息占比。 之前接触过一个做家居内容的站点,调整完结构化之后,相关问题的引用率涨了近四成。在现有技术条件下,这是最快见效的调整。 第二个方向,做长期的权威性建设。 同样说护腰办公椅,随口分享的体验,和连续测了几十款、积累了三年数据的内容,信任评分根本不在一个层级。 我认识一个做垂直测评的创作者,坚持每次更新都放自己的实测数据,哪怕内容更短,更新更慢,不到两年,他的内容只要相关,几乎都会被AI选中核心观点,很少被当成冗余切掉。 第三个方向,留足语义多样性。 不要盯着同一个关键词反复堆。用户搜办公椅护腰,背后可能是久坐上班族,可能是腰椎间盘不适的用户,可能是想买千元以内的学生,不同的场景要用不同的语义覆盖,不要所有内容都是一模一样的话术。 凑关键词出来的水内容,百分百会被当成冗余筛掉。
绕不开的现实困境
作者|大讲堂
排版|大讲堂
审核|小准