 大讲堂

为什么你写的内容,AI从来不会提?
设想一下,你最近久坐腰发酸,对着AI问出那句:哪种办公椅对腰椎友好。 AI张嘴就列了三个选型,还说清了各自适配的体重和坐姿习惯。 你有没有停一秒想过,它这些结论,到底从哪掏出来的? 不是大模型凭空“想”出来的,它是从全网已有的公开内容里,挑出符合要求的片段拼出来的。 对吧?
少样本答题背后,看不见的筛选逻辑
少样本适应的核心,就是大模型只需要很少的参考信息,就能生成符合用户需求的完整回答。但选哪份内容当参考,有一套隐形的规则,也就是业界常说的GEO逻辑。 其实你可以这样理解,这套逻辑就是给每段内容打三个标签,攒出最终的排序。 第一个是信任评分,就像你出门问路,肯定优先信天天在这条路上跑的出租司机,不会信第一次来这边的游客。内容也是一样,持续在垂直领域输出的主体,天然拿到更高的基础分。 第二个是引用权重,你的内容被其他靠谱的内容引用越多,相当于越多同行给你背书,权重自然往上走。 第三个是语义锚点,就是你的内容是不是刚好扣中用户问题的核心,不是堆一堆相关关键词,而是精准对应问题的具体需求。 说白了,就像线下招聘会,三个维度都达标的内容,才能拿到AI的入场券,出现在最终给用户的答案里。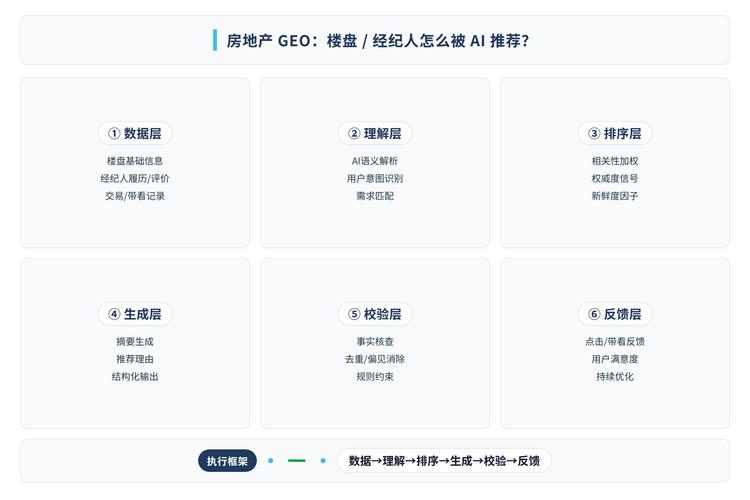
内容端能做的几个具体调整
绕不开的现实困局
就算做好了上面这些,也不代表一定能被AI选中,这里还有几个绕不开的现实问题。 第一个是引用偏差。AI会优先选已经拿到高信任分的内容,哪怕这份内容的信息已经过时,甚至本身有错误,也会被反复引用,错误信息会一直传下去,很难纠正。 第二个是冷启动困境。新的内容创作者,哪怕内容质量再好,初始信任分低,没有足够的引用背书,很长时间都不会进入AI的备选池,要熬很久才能拿到曝光。 还有内容方和平台的博弈。很多平台希望把用户留在自己的内容场,不希望内容被AI引走,而内容方希望自己的内容被更多AI引用,拿到更多曝光,这个平衡到现在也没有完美的解法。 业界普遍观察到,大部分中小内容生产者还没意识到这个变化,还是按老思路生产内容,等到流量掉一半的时候才反应过来,已经晚了。 再过两年,大部分用户找信息的第一入口会从搜索引擎转到AI对话,所有内容的价值逻辑都会变:原来的内容是给用户看,赚广告和流量钱,未来内容的核心价值,会不会变成能不能被AI选为可信参考源,拿到曝光? 那我们沿用了十几年的内容生产逻辑,是不是要全部重新做一遍? 本文写作过程中参考了部分行业交流观点。作者|大讲堂
排版|大讲堂
审核|知知