 大讲堂

上个月去苏州跑产业调研,在一家做边缘芯片的小公司会议室,桌上摆的demo跑7B大模型的速度,比同功耗的英伟达Orin快了快40%。
我盯着屏幕上跳出来的对话结果愣了两秒。
不是算法优化。
是他们用的是存算一体架构。
之前我们对算力提升的所有想象,要么是堆更多的晶体管,要么是把制程往3nm、2nm挤,直到现在大家突然发现,原来堵在算力脖子上的那道墙,根本不是晶体管数量不够。
被骂了几十年的冯诺依曼墙,到底卡了多少算力?
传统计算架构的逻辑说穿了很简单:计算单元在这头,存储单元在那头,所有要算的数据,都得从存储单元搬到计算单元,算完的结果再搬回去存着。
你想想,你请了10个顶级数学家坐在桌子后面解题,结果每算一个数,都得派个跑腿的跑到10公里外的仓库拿草稿纸,拿回来的路上还要堵半小时车。
这效率能高才怪。
现在行业里的公开测算显示,这种存算分离的架构下,数据搬运消耗的功耗,能占到芯片总功耗的70%以上,真正花在计算本身的能量,连30%都不到。更别说时间成本——大模型推理的时候,计算单元大部分时间都在等数据从内存里搬过来,相当于顶级算力在那空转。
之前大家想的解法很直接:堆内存。把HBM一层一层往上叠,缩短物理距离,加快传输速度。但问题也跟着来了:高端GPU的成本里,HBM的占比已经快到一半,而且你哪怕堆到12层HBM,物理上的搬运路径还是存在,功耗的天花板根本破不了。
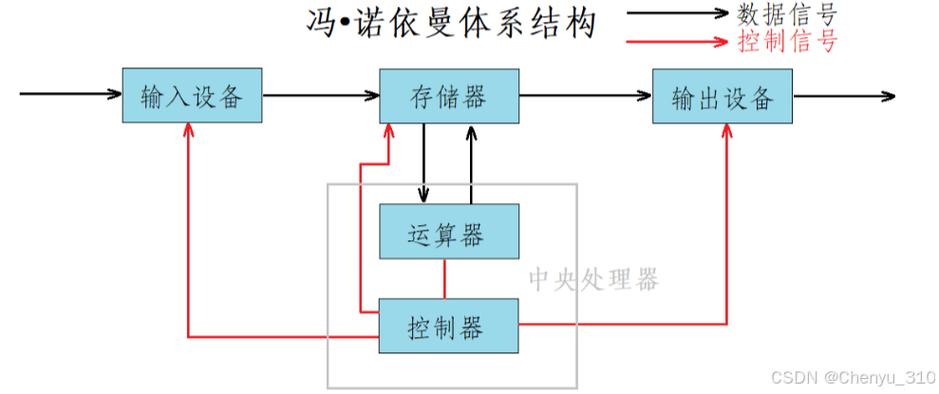
存算一体不是新东西,为什么现在突然火了?
说出来可能很多人不信,存算一体根本不是最近这两年炒出来的新概念。早在上世纪90年代,就有计算机架构的学者提出过这个思路,把计算单元直接做在存储阵列里面,不用把数据搬出来,在存储的位置直接完成计算。
但为什么沉寂了快30年?
因为之前的应用场景,根本用不上这个技术。
之前大家跑的都是图像分类、语音识别这类小模型,传统架构的算力完全够用,犯不上费那个劲去搞良率低、灵活性差的存算一体。直到大模型出来,情况完全变了。
说实话,我之前跟几个做芯片架构的老工程师聊,他们说最开始大家看存算一体,都觉得是个实验室玩具,直到大模型推理的功耗突然涨到大家都扛不住——你在边缘端跑个7B模型,传统架构的功耗能冲到15W以上,手机根本带不动,存算一体直接能把功耗压到2W以内,这个优势是实打实的,根本不是虚的。
当然也得说清楚,现在的存算一体根本不是万能的。它的优势集中在矩阵乘加运算上——刚好是大模型推理最吃算力的核心部分,但对其他类型的计算,比如逻辑跳转、不规则数据处理,效率还远不如传统架构。

现在行业里的技术路线更是乱成一锅粥:有的用SRAM做存算介质,速度快但密度低,存不了太多数据;有的用RRAM,密度高但量产良率一直上不去;还有的直接改Flash,成本低但擦写次数有寿命限制。我上次听一个做RRAM的团队吐槽,说最开始他们在实验室测的时候,良率能到90%,一上量产线,直接掉到30%不到,光调工艺就花了快1200万,半年的研发经费直接打了水漂。
现在的落地进度,比你想的要快,但也比资本吹的要慢
从2023年下半年开始,国内已经有不下10个团队拿出了存算一体的流片样品,覆盖的场景从智能穿戴的健康监测,到车载的低功耗视觉模块,再到云端的推理加速卡。
但如果你真的去问一线的供应链厂商,就会发现现在真正量产出货的,根本不是大家想象中那种能跑百亿参数大模型的高端芯片。
都是从最边缘、对成本和功耗最敏感的场景切入。
比如智能手表里的心率异常监测,原来需要把传感器采集的所有数据都传到主芯片去算,功耗高,待机时间短;现在用存算一体的小芯片,直接在传感器旁边就把数据算完,整体功耗能降60%,手表的待机时间直接多两天。再比如路边的智能摄像头,原来需要把所有的视频流都传到后台去识别人脸,现在用存算一体的芯片,在摄像头本地就把人脸提取出来,只传关键的特征数据,带宽成本能降一大半。
不过话说回来,资本的泡沫也确实存在。去年有几个做存算一体的初创公司,融了好几轮钱,对外宣传说自己的芯片能跑70B的大模型,结果实际拿回来测,量化到4bit的时候,精度掉的一塌糊涂,连基本的问答都答不对。说白了,就是拿实验室的demo当量产产品卖,割一级市场的韭菜。
从产业链的反应来看,原来的存储大厂现在也在悄悄往这个方向转。毕竟原来的DRAM、NAND价格战打了快两年,利润薄的像纸,要是能把存算一体做起来,相当于把原来只做存储的生意,变成存储加计算,产品的附加值直接翻几倍。现在连RISC-V的IP厂商,都在快速推出适配存算一体架构的模块授权,就等着下游的客户来用。
3-5年里,存算一体真正能拿下的市场,根本不是GPU替代

现在网上最常见的一种说法,是存算一体要把英伟达的GPU打下来,成为下一代算力的核心。
根本不可能。
最核心的原因是,现在的存算一体芯片灵活性太差了。你现在的架构是专门为矩阵乘加运算优化的,要是哪天算法出了新的结构,比如换了新的注意力机制,你的芯片根本改不了,不像GPU,通用计算能力拉满,什么算法都能跑。
当然也有绕不开的风险。首先是标准不统一的问题,你用你的SRAM路线,我用我的RRAM路线,软件生态完全不兼容,开发者根本不愿意花时间去适配——没有软件生态的硬件,就是一块废铁。更别说数据安全的隐患:存算一体的芯片因为计算和存储是绑在一起的,原来的那种格式化擦除数据的方式根本不管用,存储单元里残留的电荷,还是能把之前存的敏感数据还原出来,现在全球都还没有对应的行业标准来规范这个问题。
我自己跟行业里的上下游聊了快两个月,对未来3-5年的判断其实很明确:
第一,最先大规模落地的,一定是边缘端的低功耗场景,比如工业传感、智能穿戴、低功耗视觉摄像头,这些场景对功耗的敏感度远高于对算力灵活性的要求,存算一体的优势刚好匹配,预计2025年就能看到大规模的出货。
第二,在云端的大模型推理场景,存算一体会作为GPU的补充,而不是替代。比如跑推理的时候,把最吃算力的矩阵乘加部分卸载到存算一体的加速卡上,剩下的通用计算还是交给GPU,整体的系统功耗能降30%左右,这个账是算得过来的,预计2026年就能在部分云厂商的推理集群里看到部署。
第三,真正进到消费电子的主赛道,比如手机的主芯片,至少要等到2027年前后,等量产良率爬到跟传统芯片差不多的水平,软件生态适配完成,才有可能。
上周跟一个在芯片行业干了20年的老法师吃饭,他说现在行业里的人都有个共识——冯诺依曼架构不是不好,是已经走到物理极限了。
新的架构出来,从来不是靠概念吹出来的。
是要真的在某个场景里,把成本打下来,把功耗降下来,让客户真的愿意掏钱买。
存算一体现在确实站在风口上。
但风停了的时候,那些没有真东西的玩家,摔下来的时候可没人接。
作者|fawen
排版|fawen
审核|满满