 大讲堂

上周帮一家做端侧大模型的客户算算力账,对方报出来的数把我吓一跳——70B总参数量的模型,跑在单张A100上,推理延迟比同规模的传统稠密模型低了62%。
问了半天才肯说实话,他们偷偷把模型架构从稠密换成了MoE。
也就是混合专家模型。
‘被吹成显存救星的MoE,到底是个什么东西’
很多人对MoE的第一认知是”拆大模型凑小模型”。
错。
它的核心逻辑根本不是拆,是分流。传统的稠密大模型,不管你输入是问中午吃什么,还是问火箭发动机的推力公式,模型里所有的参数都要参与计算,算完全部的权重才能出结果。但MoE不这么干——它把整个模型的参数拆成若干个独立的”专家”模块,前面架一个小小的”路由”网络,专门判断当前输入最匹配哪几个专家,每次推理只激活2-4个和输入匹配的专家模块,剩下的所有参数直接处于休眠状态,不参与计算,也不占推理时的显存带宽。

听起来是不是很香?总参数量可以堆得很高,效果接近超大稠密模型,但是实际计算的参数量只有总参数的1/10甚至1/20,推理成本比同规模稠密模型低60%以上。
但别以为这是无本买卖。
我见过最离谱的某开源MoE模型,给它发一段关于家养橘猫的养护知识,路由网络居然把90%的权重都分给了讲航天材料的专家模块,输出的内容驴唇不对马嘴。还有的模型训完了一看,有三分之一的专家从来没被路由激活过,占了近40%的显存,纯纯的”占坑专家”。
说白了,MoE从出生那天起,就带着两个天生的bug:路由选得准不准,专家分的均不均。这两个问题到今天都没有完美的解决方案。
‘现在的MoE,已经卷到什么程度了’
圈里没人明着说,但你翻各家厂商的内部推理成本报表就会发现,从2023年下半年开始,头部厂商的单位token推理成本比两年前同效果的模型低了快70%,背后一半的功劳是MoE。
最早大家对MoE的认知,还是谷歌2017年提出来的稀疏激活思路,那时候的专家数也就2个、4个,效果和同激活参数的稠密模型比还差一截。直到GPT-4的架构被业内扒出来是8专家的MoE,全行业才突然反应过来——原来OpenAI早就偷偷换赛道了。
现在的卷法,已经远超当时的想象。

你去看今年发的开源模型,16个专家的算入门款,32个、64个专家的已经成了主流,甚至有团队搞了256个专家的架构,每次推理只激活1个专家,总参数量直接干到1T,实际激活的参数也就4B左右,效果居然能追上同激活参数的70B稠密模型。
说真的,我第一次看到这个参数表的时候,第一反应不是牛,是后背发凉。
这意味着什么?意味着只要路由网络的精度够,你就算把总参数量堆到10T、100T,实际推理的成本也不会涨多少。但反过来,要训这么多专家,跨卡互联带宽的要求比传统稠密模型高3倍——因为专家是分散在不同GPU卡上的,每次路由要把数据从卡A传到卡B,带宽不够的话,训练速度直接掉一半。
这也是为什么很多小厂看着MoE的好处眼热,但根本玩不起。原来凑个几十张消费级显卡就能训个7B稠密模型,现在要训MoE,首先得凑够全互联的高速InfiniBand集群,光网卡和交换机的钱,就够原来三四个小团队的启动资金了。
‘MoE砸下来,整个大模型产业链要变天’
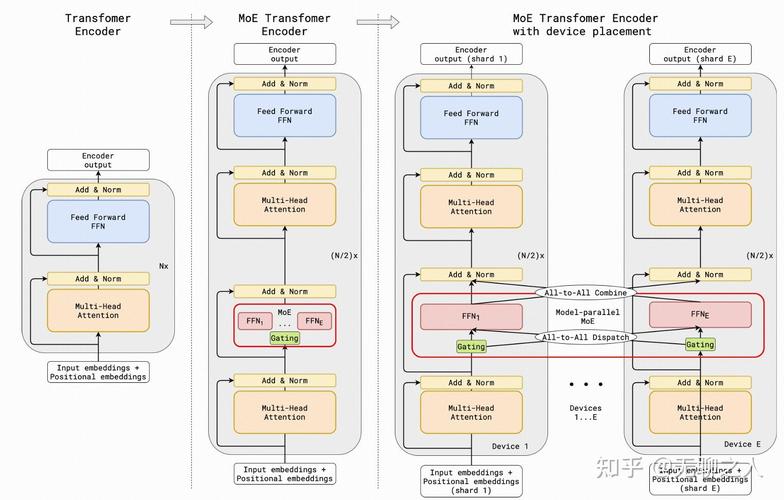
很多人以为MoE只是个技术架构的小调整,其实它是在把整个大模型产业的成本结构重新拆碎了重拼。
最先感受到冲击的是推理服务商。原来跑一个70B的稠密模型,需要8张A100显卡才能达到可接受的响应速度,现在换成同效果的MoE架构,2张卡就能跑,硬件采购成本直接砍到原来的四分之一。这也是为什么去年开始,很多推理服务商的报价直接降了一半——不是他们做慈善,是架构换了,成本真的下来了。
然后是端侧大模型的普及。原来端侧想跑个10B的稠密模型,都得把量化压到4bit,还经常卡成PPT。现在用MoE架构,总参数量可以堆到30B,但是每次实际激活的参数只有2B,跑在手机的NPU上,响应速度比原来的7B稠密模型还快。上个月某国内手机厂商的开发者大会上,演示的端侧通用大模型,就是用的32专家的MoE架构,离线就能写文案、做PPT、修图,根本不需要联网。
更有意思的是行业的分工变化。原来大家都在拼谁的模型参数大,现在开始拼谁的路由网络做的准,谁的专家能力拆的细。比如有的团队专门做通用的路由模块,给其他厂商的MoE模型做优化,把路由的错误率从15%降到3%,光这个服务就能收费。还有的团队专门做垂直领域的专家模块,比如医疗的、法律的,直接插到通用MoE模型里,就能快速做出垂直领域的专用模型,根本不需要从头训。
不过话说回来,这也不是全行业的狂欢。原来那些靠堆算力、堆参数做模型的团队,现在突然发现自己的优势没了——你花几千万堆出来的175B稠密模型,别人用MoE架构,花十分之一的训练成本,就能做出同效果的模型,这谁顶得住?
‘藏在MoE背后的那些坑,现在还没人能绕过去’

任何技术都有代价,MoE的代价,现在才刚开始浮出来。
第一个坑是治理的难度指数级上升。传统的稠密模型,你要查某个输出的偏见或者错误,直接顺着参数调就行。但MoE是黑盒套黑盒——你根本不知道这次输出是哪个专家出的问题,也不知道路由为什么选了这个专家。之前有研究团队测某MoE模型的偏见输出,发现只要输入内容涉及特定群体,路由有80%的概率会分到那个训练时喂了大量刻板印象数据的专家模块,输出的歧视性内容比同规模的稠密模型高了3倍。更麻烦的是,你想修这个偏见,你都不知道该改哪个专家的参数——路由的逻辑是没有明确边界的,你改了A专家,可能下次路由就把B专家激活了,又出新的问题。
第二个坑是专家的能力坍缩。训练的时候,路由网络天生就有”偏心”的问题,总是喜欢激活那几个能力强的专家,剩下的专家分到的训练数据越来越少,能力越来越弱,最后变成根本没用的”废专家”。很多团队训完MoE模型,一看专家激活率,有三分之一的专家激活率不到1%,等于白占了30%的显存,但是你还不敢随便删——删了之后模型的输出直接崩,因为路由网络已经习惯了有这些模块的存在,哪怕它们根本没干活。
第三个坑,也是最现实的,是行业的集中化会被加速。原来稠密模型的时代,小厂还能靠算法优化、量化压缩追上大厂的脚步,但是MoE的时代,拼的是集群规模、是互联带宽、是长期积累的路由优化经验,这些东西不是靠几个工程师熬几个夜就能补上的。算下来,全球能玩得起顶级MoE模型的厂商,也就那么五六家,国内也就两三家。最后整个赛道变成几个大厂的游戏,创新的活力会不会被磨掉?
我现在有时候会想,当所有的大模型都变成一堆分散的专家模块,那我们到底是在和一个统一的智能对话,还是在和一堆被路由随机拼起来的碎片对话?这个问题,现在还没人能答。
聊到这,你可能会问,MoE到底能走多远?
我自己的判断是,未来3年,所有超过30B参数的通用大模型,都会默认采用MoE架构。没有例外。
到那时候,GPT-4级别的模型推理成本会再降一个数量级,原来因为成本太高跑不起来的场景,比如实时的全域智能客服、车载的通用助手、甚至家电里的个性化管家,都会真正落地。端侧的大模型会彻底普及,你手机里的助手,可能总参数量有50B,但是跑在本地,根本不需要把你的隐私数据传到云端。
但另一个趋势也会同步到来:顶级MoE模型的门槛会越来越高,小团队根本没有机会参与通用大模型的竞争,只能在垂直专家模块的细分赛道里找机会。
说实话,我现在有点期待那个场景,但又有点怕。怕再过几年,我们想做个自定义的小模型,都得从大厂的MoE体系里抠点参数出来用,连自己的核心模型主权都没有。
毕竟,技术从来都不是中立的。它从来都是跟着成本、跟着门槛、跟着谁能玩得起,一步步往前走的。
作者|fawen
排版|fawen
审核|满满