 大讲堂

别被论文术语绕晕,GNN的本质说穿了很简单
很多人看了一堆顶会论文,觉得GNN是个玄乎到不行的黑科技。说穿了,它的核心逻辑根本不复杂:把现实世界里的所有实体——人、商品、原子、论文、路口——都当成图上的节点,把这些实体之间的关联关系当成本来就存在的边,然后让模型沿着这些边在节点之间“串门”,把每个节点周围邻居的特征信息,揉到自己的特征表示里,最后基于这些融合后的特征做预测或者分类。
现在的GNN,离“通用基础模型”的距离比火星还远
2022到2023年那波GNN创业潮,现在已经悄悄死了一半。剩下还在牌桌上的玩家,根本不是靠什么通用图模型吃饭,都是抱着几个垂类场景在啃硬骨头。 目前跑通落地的场景,掰着手指头数也就那么几个。最成熟的是金融反欺诈:支付机构发现,套现团伙往往会形成一个闭环的资金转移网络,这种跨用户的关联关系,是传统单用户特征模型根本抓不到的,用GNN把这些资金往来的边连起来,确实能比规则模型多抓出三成左右的隐蔽套现交易。但这里的“成熟”也是打引号的——几乎所有上线的GNN风控模型,都需要人工每半个月重新洗一次图结构,把新出现的作弊关联关系补上,本质上就是个套了深度学习壳的复杂规则引擎,根本不是什么能自动进化的智能系统。 第二个跑的还行的场景是药物早期筛选。把分子结构当成图,原子是节点,化学键是边,用GNN预测分子和靶点的结合能力,确实比传统的分子动力学模拟快几十倍。但这里也藏着一个行业公开的秘密:很多论文里报的90%以上的预测准确率,都是在公开的标准数据集上测出来的,真拿到实验室做湿实验验证,能有三分之一的预测结果靠谱就谢天谢地了。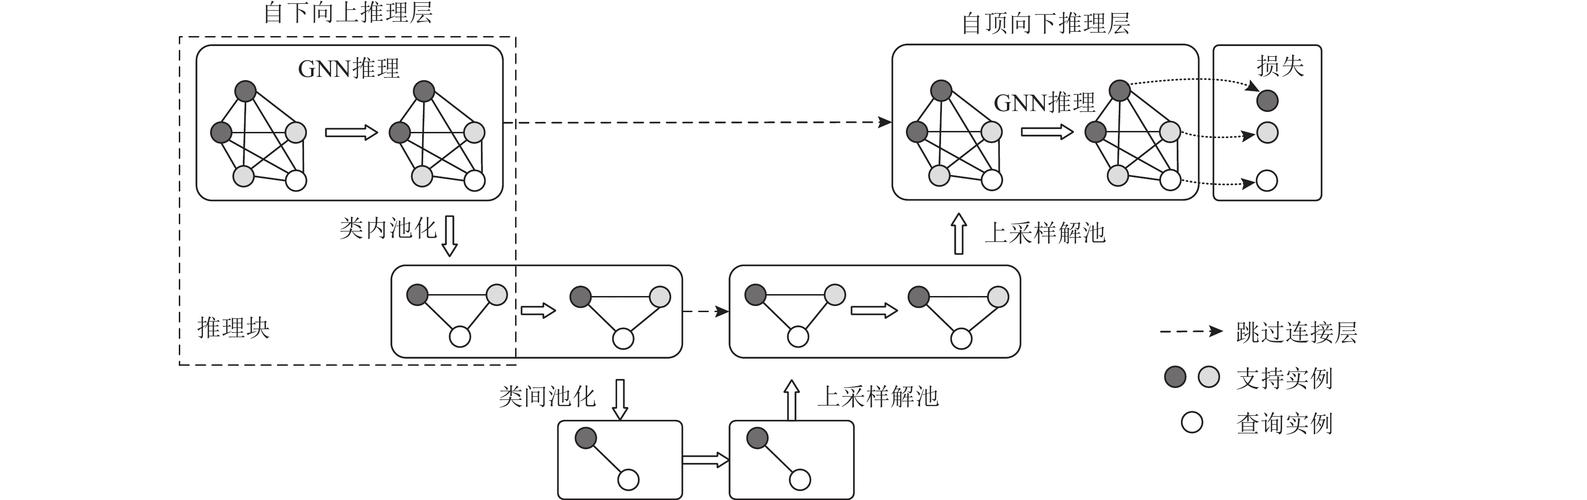
那些没人愿意公开说的坑,现在谁都绕不过去
我见过太多团队吹GNN的效果,绝口不提背后藏着的风险。 首先是图结构自带的偏见。比如你要做一个招聘场景的GNN,把过往入职员工的学校背景、社交关系、工作经历全连成一张图,模型最后学出来的结果,一定会偏向那些和现有员工有相似背景的候选人——相当于把原来的职场圈层固化,通过算法给放大了。更麻烦的是,这种偏见根本不是从单个特征里能挖出来的,它藏在节点和节点的连接关系里,你想删都不知道从哪下手。 然后是绕不开的隐私雷区。要把用户的社交关系、资金往来、浏览记录全连成一张图,涉及的敏感数据量比传统单用户模型大了好几个量级。之前就有学术团队做过测试,就算把图里所有用户的个人身份信息全部做了加密脱敏,只要拿到图中某几个节点的连接关系和度值,攻击者就能通过图的拓扑结构特征,反向定位到某个匿名用户的真实身份。这种泄露风险,是传统模型根本不具备的。 还有个很现实的行业乱象:现在全行业根本没有统一的GNN效果评估标准。同样一个反欺诈场景,A团队测出来准确率92%,B团队拿公开数据集跑出来只有58%,为啥?因为大家自己凑的图结构都不一样,谁也不知道自己的模型到底是真的有效,还是在自己搭的舒服圈里做的自我感动。 最后说点实在的,关于未来3到5年的GNN走向。 别信那些说GNN会替代Transformer成为下一代通用基础模型的鬼话。它就是个特定场景下的专用工具,就像你不能拿螺丝刀拧所有型号的螺丝。3年之内,能真正跑通规模化商业落地的GNN场景,也就那么三四个:金融反欺诈、药物分子早期筛选、知识图谱补全、供应链异常节点检测。其他吹得天花乱坠的场景,基本都是凑论文、拿项目经费的噱头。 5年尺度上,一定会出现专门针对GNN计算特点设计的专用芯片,把现在那种指数级上涨的推理成本打下来。到那个时候,可能会有几个新的场景慢慢跑出来,比如城市级的交通流量动态调控——这个场景现在算不起,等算力成本降到位了,说不定真能做出点东西。 上次跟那个骂人的学弟吃完饭,他说组里已经准备把那个不靠谱的GNN风控项目砍了,先把现有的XGBoost模型调优明白再说。 挺好的。作者|fawen
排版|fawen
审核|柚子