 大讲堂

问原因。
说取个“华东区Q3会员客单价”的数,要找三个数据开发,等整整三天,算出来的数还跟财务那边的账对不上——两边扯了快一个月,谁都觉得自己是对的。
太正常了。
很多人对数仓的误解,还停留在“把业务库的表抽过来存着就算完事”,但说白了,数仓建模才是决定这套系统到底是资产还是负债的核心——你建得好,业务团队取数效率能提10倍,数据可信度能拉到90%以上;建得烂,那就是个占存储成本的大型数据垃圾堆,谁碰谁嫌麻烦。
为什么90%的数仓建模从第一天就走歪了
大部分团队启动数仓项目的时候,第一反应是找几篇网上的建模教程,照着星型模型、雪花模型的标准画个ER图,把业务库的表一个个迁过来就算交差。根本没人停下来问一句:我们建这个数仓,到底是给谁用?要解决什么问题?
我见过最典型的一个项目,当时技术团队为了追求模型的“教科书级规范”,光把用户相关的表拆成了23张,每个表只存一类字段——用户基本信息在A表,用户的收货地址在B表,用户的会员等级变更记录在C表,甚至连用户的上次登录时间,都单独拆了一张关联表。
等业务团队上来用的时候傻了:想查一个用户的最近消费记录,要关联8张表,跑一次查询要等20分钟。
更要命的是口径问题。
同样是“销售额”,财务算的是扣完所有退款、优惠券抵扣之后的实际到账金额,运营算的是用户下单时的支付总额,商品部算的是扣除运费之后的商品货值——三个部门对着同一个字段吵了大半年,最后才发现,当初建模的时候,根本没把这三个完全不同的口径拆成独立字段,全塞在同一个“sales_amount”的列里。
这种错,不是技术能力不够,是从一开始建模的思路就偏了:把“表结构设计”当成了建模的全部,却忘了建模的本质,是给整个企业的数据定规则、立标准。
数仓建模的核心,从来不是画ER图
很多人被教科书上的维度建模理论吓住,觉得数仓建模是个特别高深的技术活,要背一堆公式、记一堆模型范式。其实真不是。
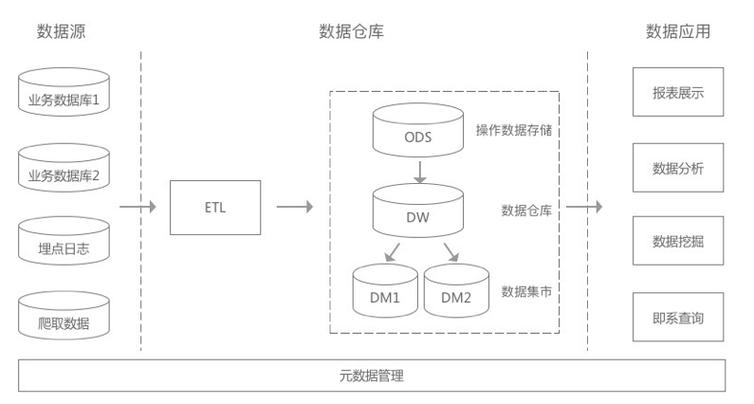
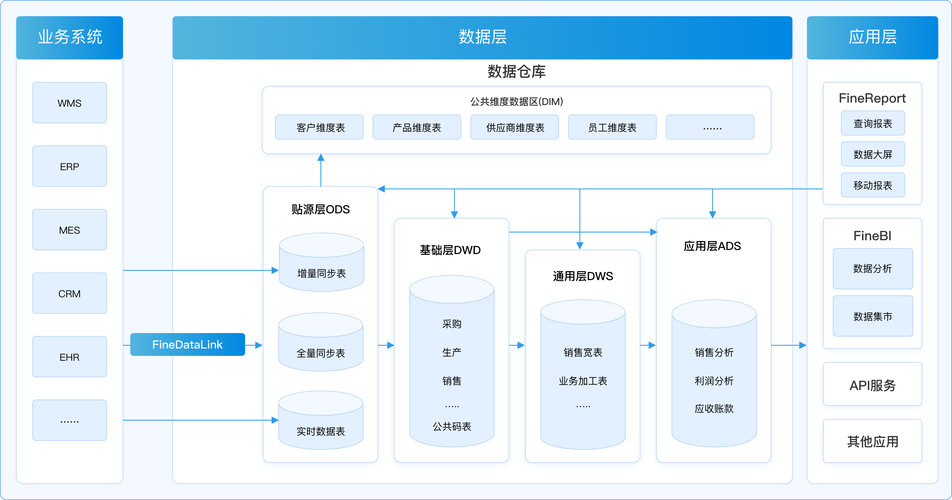
你只要把整个数仓的分层逻辑理清楚,就会发现建模的事根本没那么复杂:ODS层就是原封不动同步业务库的原始数据,别上来就改字段、删记录,先把数据全量存下来,留好溯源的底子;DWD层是做数据清洗,把重复的、脏的、格式不对的数据滤掉,同时把每个字段的业务定义钉死——比如哪个字段存实付金额,哪个字段存下单金额,哪个字段是用户的脱敏手机号,全写在元数据里,谁都别随便改;DWS层是按业务主题做汇总,把用户、商品、交易这些核心主题的指标提前算好,不用等业务团队来取数的时候再临时跨表join;ADS层就是直接给业务用的结果表,点开就能看数,零SQL基础的运营也能自己查。
我见过太多团队把ODS层当成万能垃圾桶,什么乱七八糟的埋点数据、第三方爬的行业数据、甚至员工自己上传的零散Excel都往里面塞,最后DWD层的开发天天像在垃圾场捡东西,光清洗数据的时间就占了整个开发周期的70%。
有这精力,不如在建模一开始就把每个层的准入规则写死——ODS层只接经过格式校验的业务库同步数据,别的一概不收。
就这么简单的事,80%的团队做不到。
说穿了,好的数仓建模,本质上是在给数据“划斑马线”——什么人能走什么道,什么数存在哪个位置,什么指标对应哪个业务定义,全是明明白白的,谁来了都不用瞎摸。
现在行业里的建模,已经卷到什么程度了
搁五年前,大家对数仓建模的认知还停留在离线T+1的维度上,就是每天凌晨把前一天的业务数据抽出来,跑一批任务,算出结果第二天早上给业务看。现在早就不一样了。
首先是实时数仓的普及,把原来的建模逻辑全打乱了。以前离线建模可以等全量数据落盘了再做清洗、再做汇总,现在实时场景下,数据是按秒级流进来的——比如外卖平台要算骑手的实时配送时长,电商平台要算直播间的实时转化率,根本等不了用户完成整个订单流程、全量数据落盘了再算。这时候的建模,就得把每个业务动作拆成独立的事件流:用户点提交订单是一个事件,用户完成支付是一个事件,骑手取餐是一个事件,每个事件单独存到对应的主题域里,要算哪个指标直接拉对应的事件流就行,根本不用跨表join。
我之前接触过一个头部即时零售平台的技术团队,他们现在的实时数仓里,根本不存传统意义上的“订单表”,全是拆碎的事件流,算出来的实时指标跟离线T+1的指标误差能控制在0.5%以内,计算成本还比原来的实时方案低了60%。
还有就是建模思路的分化。原来大家全照着Kimball的维度建模那套抄,现在互联网公司因为业务迭代太快,经常这周改个活动规则,下周改个会员体系,传统维度建模改表的成本太高,很多团队开始转用Data Vault 2.0的建模方式——把核心的业务实体、关联关系、业务事务全拆成独立的模块,要改业务规则的时候,只需要加个新的关联表就行,根本不用动原来的核心表结构,灵活度高了不止一个档次。
不过话说回来,也有不少团队在跟风走歪。比如有的公司看别人上湖仓一体,就把原来的数仓全拆了,所有数据全存在数据湖里,建模的时候连最基本的分层规则都不要了,结果算出来的数可信度越来越低,最后又花了大半年时间把原来的分层逻辑捡回来。
建模最容易踩的隐形坑,没人会主动跟你说
第一个坑,就是合规风险的提前埋雷。很多团队建模的时候,根本没把数据合规当回事,把用户的手机号、身份证号、交易明细全存在DWD层的明文表里,连个脱敏都不做。等哪天监管上门检查,或者发生数据泄露事件,再想回头改表结构、做字段加密,那个成本高到能让人崩溃——毕竟所有上层的报表、数据接口全是基于原来的明文表做的,一动全动。
第二个坑,就是过度设计。
我见过最离谱的一个数仓,光用户主题域就拆了17张关联表,取个用户的基本信息要join8次,本来10秒能跑出来的查询,现在要跑10分钟。最后运营部的小姑娘宁愿自己导一周的Excel拼表,都不愿意碰数仓的接口——你说这建模建的,到底是给谁用的?
说白了,好的建模从来不是越细越好,而是越好用越好。如果你的模型设计得特别“完美”,但业务团队用的时候要费半天劲,那这个建模就是彻底失败的。
第三个坑,就是没有迭代机制。
很多团队建模的时候,一劳永逸的心态特别重,觉得一开始把表结构设计好,以后就不用改了。但企业的业务是一直在变的,今年的“销售额”口径跟去年的可能都不一样,明年可能还要加新的业务指标。如果建模的时候留好迭代的口子,没有建立定期的元数据评审机制,用个两三年,数仓里就会全是重复的表、口径混乱的字段,最后整个系统彻底烂掉。
未来3—5年数仓建模会往哪走
第一个判断,建模的门槛会降到几乎为零。现在已经有不少云厂商把大模型接到了数仓建模的流程里,业务人员根本不需要懂什么维度建模、什么分层逻辑,只要用自然语言说“我要算每个门店每个月的会员复购率”,系统就能自动对齐对应的业务口径,自动生成需要的表结构,自动把计算任务跑起来,根本不需要数据开发手写建表语句、写SQL脚本。以后数据开发的核心工作,可能就不是天天建表写SQL了,而是给系统定规则、管口径,把重复的劳动全交给大模型。
第二个判断,原来僵化的分层建模思路会被彻底打破。
现在湖仓一体的架构越来越成熟,数据湖的存储成本已经降到跟本地磁盘差不多的水平,大家根本不需要为了省存储,提前把数据层层汇总、层层加工。以后的建模,可能不会再有严格的ODS、DWD、DWS的分层边界,核心会变成动态的元数据治理——不管数据存在哪个位置,系统都能知道这个字段是什么意思,对应哪个业务口径,能溯源到最原始的来源数据。
第三个判断,建模的评价标准会彻底变天。
以前大家评价一个数仓建得好不好,全看是不是符合教科书的规范,表设计是不是够“范式”,模型是不是够“标准”。以后根本没人管你是不是符合教科书,大家就看两个指标:一是业务团队取数的效率有多高,能不能1分钟内拿到可信的数;二是整个数仓的存储和计算成本有多低。
毕竟,数仓从诞生的第一天起,就不是为了给技术团队自己玩的。
它是给业务用的。
作者|大讲堂
排版|大讲堂
审核|柚子