 大讲堂

上个月在南京的一场工业AI闭门沙龙上,碰到个做电力巡检的老工程师。他蹲在会场外面抽烟,吐槽现在圈内的风气——不管啥场景上来就谈大模型,谈千亿参数,真到现场拍板的选型,还是掏出来2017年训的LSTM模型。
“为啥?”
“边缘端的摄像头算力就那么点,大模型跑不起来啊。”
这话真的。好多人现在一提循环神经网络(RNN),就觉得是被Transformer拍在沙滩上的老古董,是教科书里翻到第三章就跳过的过时知识点。但实际上,从你早上对着智能手表喊“看心率”,到工厂里的风机故障预警,再到银行的交易异常检测,RNN从来没真的退场。
被误解的核心:RNN的优势从来不是“能打”,是“够用”
和所有把输入当成独立样本处理的传统神经网络不一样,RNN从设计之初就带了“时间维度”的记忆——它会把上一步处理完的状态存下来,和当前的输入一起算下一轮的输出。就像你读这句话的时候,不会忘了开头说的是啥,本质上是把时序上的依赖关系给学进去了。
当然早期的原生RNN有个致命的毛病:记忆太短。序列稍微长一点,比如读个百字的段落,前面的信息就顺着梯度消失的路径漏光了,根本记不住。后来LSTM出来,给记忆加了三个门控,才把这个问题解决了。
LSTM的三个门控(输入门、遗忘门、输出门)本质上是给记忆加了“过滤阀”:重要的信息留下来,没用的冗余信息直接删掉,不会让无效内容把记忆空间占满。
我当年读博的时候调LSTM参数,前后花了三个月,把实验室一块3090跑烧过,就为了把长序列的准确率提两个点。那时候总觉得这模型是万能的,直到后来Transformer出来,大家一窝蜂转去做注意力机制,好像谁再提LSTM就是跟不上潮流。
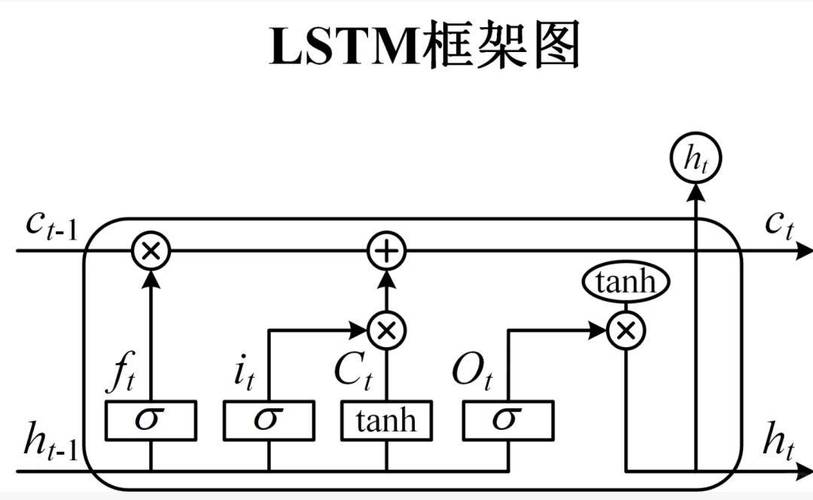
但很少有人提,LSTM的推理成本有多低。同等精度下,LSTM的推理速度是同参数量Transformer的3到5倍,功耗只有后者的十分之一。这东西就像你家里的老式电饭锅,没有智能屏,不会连wifi,甚至不能预约做饭,但按下键就能煮出熟饭,从来不会掉链子。你让它去做满汉全席当然不行,但煮个白米饭,比那些花里胡哨的智能厨具靠谱多了。
找对战场的RNN:现在还在哪些地方默默干活
之前跑产业调研的时候,我算过一笔账:目前国内已经落地的时序类AI应用里,接近60%的底层还是用的RNN家族的模型(LSTM、GRU这些简化版本),根本不是大家想象的那样全是Transformer。
为啥?因为这些场景根本不需要大模型那种“上知天文下知地理”的能力,只需要快、准、省。
比如智能手表的心率异常检测。你戴着表跑步,心率每一秒都在变,模型要实时判断你有没有心律失常的风险,要是等个几百毫秒的延迟,等检测出问题的时候,人可能都已经晕了。这种场景下,轻量化的GRU模型只有几百K大小,跑在手表的MCU上,功耗低到可以忽略,准确率还能做到90%以上,换个小的Transformer都不一定能跑起来。
再比如工厂里的电梯、风机故障检测。这些设备装在各个角落,不可能每个设备都配个高性能的边缘网关,大部分就靠设备本身的主控芯片跑模型。国内某头部家电厂商的空调风机预警系统,就是用的1.2M大小的GRU模型,直接烧在空调的主控板上,不用联网,就能根据电机的振动频率预判磨损情况,准确率比之前的规则阈值方法高了22个百分点。
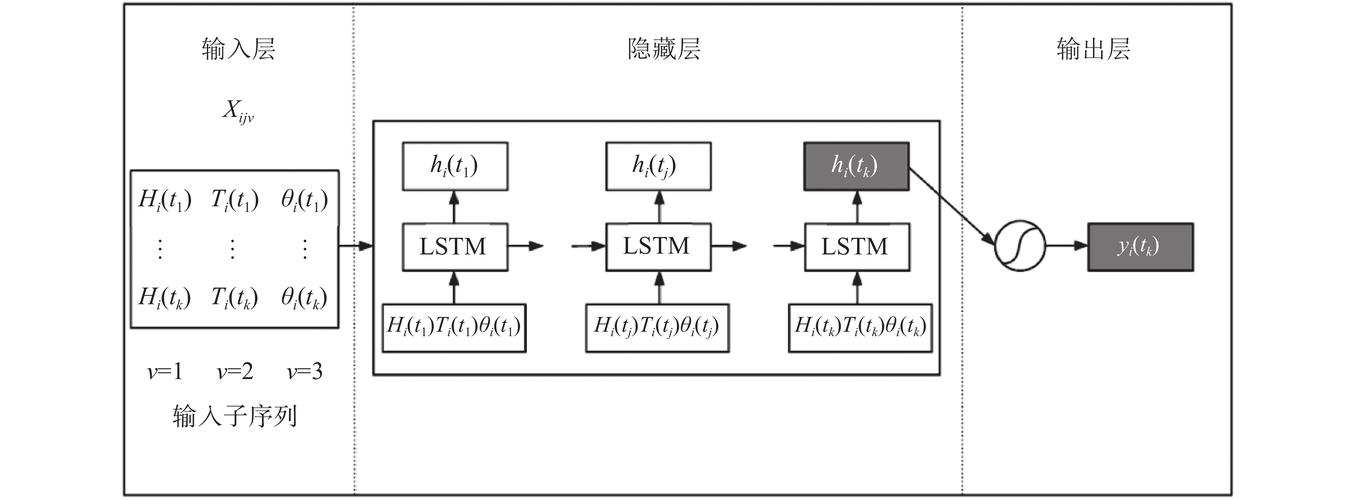
还有大家每天用的语音唤醒。现在不管是智能音箱还是手机,你喊一声唤醒词,从听到你说话到给出反应,整个过程不能超过300ms,不然用户就会觉得卡。这个唤醒词检测的模块,90%以上用的都是轻量化RNN,因为它只需要识别几个固定的关键词,不需要理解复杂的语义,用RNN刚好够快,根本犯不上用大模型。
说个有意思的事:去年有个做券商量化交易的朋友跟我说,他们的日内交易策略里,用来预测股价短期波动的模型还是LSTM,不是因为他们不追新技术,是因为这个模型每10ms就能出一次预测结果,换个稍微大一点的模型,延迟上来,交易机会就没了。
没人盯着的风险:RNN落地的隐形坑
大家现在谈AI风险,全盯着大模型的幻觉、版权、偏见问题,很少有人注意到RNN的风险。
首先是黑盒问题。RNN的记忆是存在权重里的,你根本不知道它到底记住了啥。之前有个做医疗AI的团队,用LSTM分析患者的心电图数据,训练完了发现模型能精准预测哪些患者有医保,后来查了半天才发现,它把心电图信号里夹带的医院收费系统的时序特征给学进去了——这根本不是心电图本身的规律,是系统噪声。要是基于这种预测做临床决策,后果不堪设想。
然后是数据泄露的问题。因为RNN会把训练数据的细节“刻”在记忆里,之前有学术测试发现,经过训练的LSTM能还原出训练集里的原始文本片段,要是训练数据里有患者的隐私信息、用户的消费记录,这些信息很可能会被模型带出来,而且你根本没法从外面查出来它记了啥。
还有个更现实的坑:大家觉得RNN是老模型,技术成熟,随便改改就能上线,根本不做鲁棒性测试。去年苏州有个工厂,上线了一套基于LSTM的电机故障预警系统,结果冬天室外温度降到零度以下,电机的振动特征变了,模型连续报了三天的高危故障,工程团队跑过去拆了三回电机,啥问题都没找到,白折腾了一圈,损失了十几万的停机成本。
说白了,RNN没有大家想的那么“傻”,它的记忆逻辑是跟着训练数据走的,训练数据没覆盖到的场景,它根本不会处理。
未来3到5年的判断:不是替代,是互补
我自己跑了快三年的产业调研,对RNN的未来有个很明确的判断:它不会被大模型替代,反而会成为端侧AI的核心骨架。
首先,所有离用户近的、需要实时响应的、算力有限的场景,永远是RNN的主场。你不可能把一个几十G的大模型装在智能手表、空调主板、电梯控制板上,这些场景需要的是轻量、快速、低功耗的模型,RNN天生就适合干这个。
其次,现在的新架构已经把RNN的短板补上了。比如最近火的RWKV、线性RNN这些新模型,把RNN的循环结构和注意力机制的优点结合起来,既保留了推理快、功耗低的特点,又能处理几万字的长序列,现在已经有团队在做端侧跑的7B参数模型,用的就是RWKV架构,在手机上的推理速度比同规模的Transformer快了4倍。
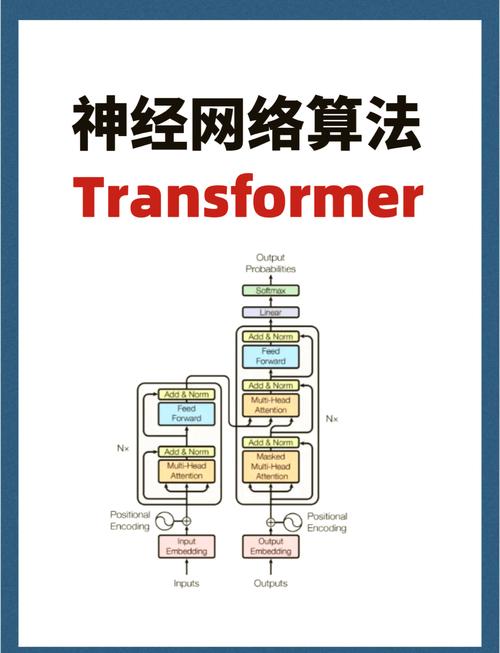
以后的AI架构根本不会是“大模型一统天下”的样子,而是分层的:离用户最近的端侧设备,用轻量化的RNN模型做实时的简单交互,比如唤醒词识别、心率检测、设备故障预警;近场的边缘服务器,跑中等规模的模型做本地的复杂处理;云端的大模型,负责处理需要全局知识、长文本生成的复杂任务。
谁要是说以后所有场景都要上大模型,那基本是没去过工厂,没摸过真实的边缘设备。
RNN从1980年代被提出来,到现在已经快40年了,它不像Transformer那样自带流量,天天上新闻,但它一直在产业的最底层,默默处理着每一秒的时序数据。就像城市地下的管网,没人会特意提它,但一旦它停了,整个系统就转不起来。
作者|大讲堂
排版|大讲堂
审核|乐乐