2026-10-24 22:56:12 作者:大讲堂
上周在南京跟几个做AI落地的朋友吃十三香小龙虾,有人拍桌子说自己公司花了大几百万买的LLM私有化部署,最后全公司用得最多的功能,是写每周部门周报。
拆开LLM的黑盒:它根本不是”会思考的机器”
很多人对LLM的认知还停留在”它能跟我聊天,能写代码,能画图,所以它是有智慧的”。
错了。
它不会真的”懂”。
本质上,现在所有主流的大语言模型,核心逻辑都是基于海量公开文本训练出来的”下一个词概率预测器”。它没有自主意识,没有价值判断,所有输出的内容,都是在计算”在当前的上下文里,哪一个词接在后面出现的概率最高”,然后把这些词串成通顺的句子。
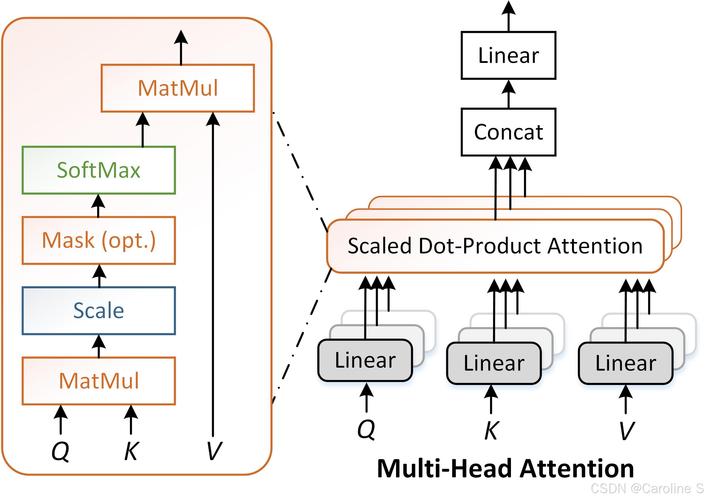 LLM Transformer架构注意力机制可视化图
你问它怎么给你家猫选猫粮,它能把网上所有关于猫粮测评、猫龄对应营养需求、不同品牌溢价空间的文本片段拼出最符合概率分布的回答,但如果你家猫刚好对鸡肉过敏,而所有公开文本里都没提过你家猫的具体情况,它的回答本质上是在”猜最可能正确的选项”,不是基于事实的推理。
我之前测试过某个头部开源LLM做小学三年级四则运算题,题目带了个常见陷阱:”小明有15个苹果,分给3个小朋友之后,又买了相当于剩余量2倍的苹果,问现在总共有多少苹果”。它连续三次给错答案。
错得离谱。
这就是LLM的核心能力边界:它擅长处理那些在训练数据里出现过无数次、有固定文本范式的内容,但是一旦遇到需要严谨逻辑推理、需要基于私有信息做判断的场景,它的错误率会直线上升。之前有媒体统计过,哪怕是当前最顶级的闭源模型,在做需要多步推理的数学题、法律逻辑题的时候,错误率依然在30%以上。
现在的LLM落地,一半是泡沫,一半是真需求
我过去半年接触过27个做LLM落地的创业团队,真正跑通付费闭环、客户愿意持续续费的,只有4个。
其中3个是做企业专属知识库的。说白了就是把公司内部的制度文档、项目历史、合同条款、产品手册喂给微调后的LLM,让新员工不用翻几百个加密文件夹找报销规则,不用追着老同事问某个三年前的项目当时为什么定那个价格,不用把产品手册翻到第47页找客户问的售后政策。这个场景是真的硬,因为它替代的是原来需要专门招两个行政助理、花大量时间做重复答疑的人力成本,算下来ROI特别清晰,很多中型公司用了之后,光行政答疑的人力成本每个月就能省大几万。
剩下的团队呢?要么在跟风做所谓的”AI数字人直播”,最后发现LLM生成的话术根本带不动货,观众一进来就知道是机器人,平均停留时间还不如真人直播的三分之一;要么在做面向C端的AI写作工具,最后发现用户写来写去都是那几篇千篇一律的公众号水文,付费率连2%都不到;还有的团队在做所谓的”AI全能助手”,吹得天花乱坠,最后产品上线之后,用户用了两次就卸了——因为它连准确记住用户的偏好都做不到。
 企业LLM知识库落地流程架构图
其实整个行业的风向早就变了。现在全球LLM的竞争已经从”拼模型参数”进入了”拼落地效率”的阶段。两年前大家还在比谁的模型参数多,从千亿到万亿,好像参数越大就越厉害;现在OpenAI自己都开始推GPT-4o的轻量化版本,开源社区的Llama 3、通义千问这些模型,参数只有几百亿,但是在很多垂直场景的表现,已经追平了一年前的千亿级模型。
为什么会有这个变化?因为大家终于反应过来了:绝大多数企业根本不需要一个能解奥数题、能写莎士比亚十四行诗的超级模型,他们需要的是一个能准确读懂自己公司文档、不会乱说话、推理成本够低的”专属助理”。
别等通用AGI了,3年内的LLM战场在垂直细分场景
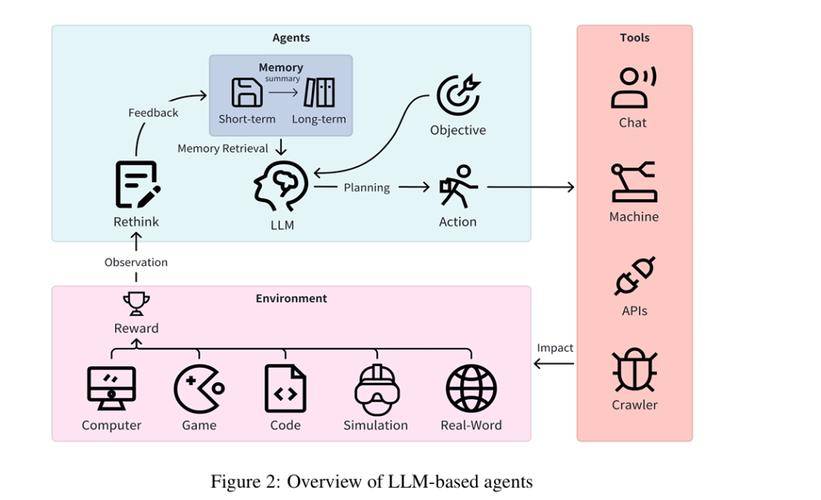 别等通用AGI了,3年内的LLM战场在垂直细分场景
现在舆论场对LLM的认知两极分化特别严重。
一边是过度乐观的人,说LLM马上要实现通用人工智能,要抢所有人的工作,要改变人类文明的进程;另一边是完全悲观的人,说LLM就是个高级聊天机器人,生成的内容全是正确的废话,根本没有实际价值。
说实话,我特别反感这两种论调。
真实的风险和机会都在中间地带。
先说说风险。现在很多人对LLM的风险感知是错位的:大家担心的是LLM会产生自主意识反过来控制人类,但是实际已经发生的风险,全是非常落地的现实问题。比如你让LLM帮你写一份给客户的合同,它可能会一本正经地编一个根本不存在的法律条款,等你签完字才发现出了大问题;比如企业用LLM做对外客服,它可能会把公司根本没承诺过的售后政策说出去,最后赔得一塌糊涂;更别说现在训练数据里的版权问题,很多模型爬了一堆作者的书、媒体的深度报道、画师的作品,最后拿来做商业化产品赚钱,连一分钱版权费都没付,这个雷迟早要爆。
再说说未来3-5年的判断,没有什么玄乎的概念,全是可以落地的趋势:
第一,所有需要大量文本处理的岗位,都会把LLM变成一个标配工具。就像现在的上班族用Excel、用搜索引擎一样,你不会因为Excel能算函数就说财务要失业,但是不会用Excel的财务肯定会被会用的淘汰。未来不会用LLM处理文档、整理信息、生成初稿的文案、行政、程序员、律师,都会慢慢被同行拉开效率差距。
第二,会出现一批专门做垂直场景LLM的小而美公司。比如专门给律所做合同条款审核的,专门给制造企业做设备故障排查手册生成的,专门给跨境电商做多语言商品详情页文案的。这些模型根本不需要有通用聊天能力,只要在自己的细分场景里准确率够高、推理成本够低、不会乱说话,就能活得很滋润,根本没必要跟OpenAI这种做通用模型的巨头卷。
第三,关于LLM的监管规则会慢慢落地。比如要求所有公开传播的AI生成内容必须明确标注,要求企业不能把用户的隐私数据随便喂给公共LLM,要求训练数据的版权来源必须可追溯。这些规则出来之后,现在那些靠野蛮生长、打擦边球起来的团队会被清出去,剩下的都是真正做正经产品、算得清投入产出账的玩家。
上周跟朋友吃小龙虾的时候,那个拍桌子说花了几百万部署LLM最后只用来写周报的老板,上个月把原来的重资产私有化部署砍了,换成了一个轻量化的开源模型,专门用来处理公司的项目验收文档。现在每个月能省两个行政的人力成本,算下来一年就把之前亏的钱赚回来了。
你看,LLM从来不是什么万能的神。
它就是个工具。跟当年的PC、互联网、移动互联网一样,最后能留下来的,从来不是那些把概念吹得满天飞的玩家,而是真的能解决具体问题的人。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:别再吹LLM万能了:从技术边界到3年落地的真实账本
文章链接:https://lfdjt.com/info_23_28109.html
 大讲堂
