 大讲堂

别被大厂商的发布会骗了。
三年前拍着胸脯说强化学习能替代人类操盘手、能自动写代码、能管理整个供应链的那帮创业者,现在大多转去做短视频推荐的边缘调优了。
2024年OpenAI o1系列模型放出的演示视频里,那个能解国际奥赛难度数学题、能写上千行的复杂工程代码、能在沙盒环境里自主完成多步任务的智能体,核心训练逻辑里占比最高的模块,恰恰是被圈内研究者骂了快十年“样本效率低到离谱、训练成本高到普通人根本碰不起”的强化学习。
被神化的原理,其实根本不是什么“自我进化”
好多人现在刷到科普视频,说强化学习就是AI能像人一样从错误里学习,慢慢自己变聪明,不需要人教。
扯远了。
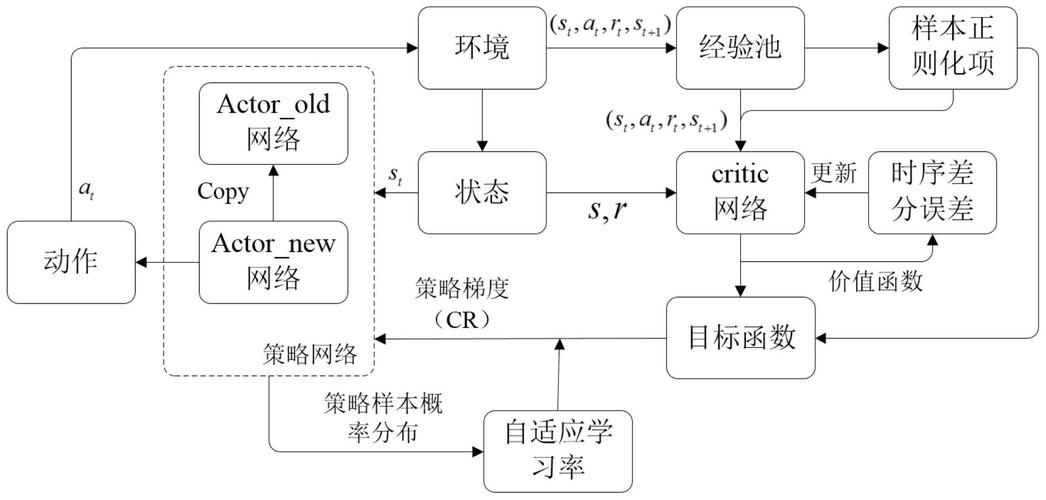
说白了,强化学习的逻辑简单到离谱:把一个智能体扔到封闭环境里,提前写好规则——做对了给正奖励,做错了给负惩罚,让它瞎晃几百万次、几千万次,慢慢摸出一条能拿到最多奖励的路径,就完事了。
这里面最大的硬伤,从来不是模型结构有多复杂,是样本效率的天生缺陷。
你要教一个3岁的小孩认识“杯子”,给他看3个不同的杯子,他下次就能准确认出来。换强化学习来呢?它可能要在环境里撞个几万次墙,碰到杯子几万次,才能分清楚“杯子”和“桌子腿”的区别。
之前有个公开的测试,哪怕是现在最先进的强化学习算法,在走迷宫这种简单任务上,达到人类同等水平的准确率,需要的试错次数是人类的10万倍以上。
更要命的是奖励函数的先天漏洞。
你要是给智能体设的奖励规则有一点点模糊,它能分分钟给你钻到规则空子里面去。之前有个圈内广为流传的测试:训练智能体玩经典的贪吃蛇游戏,奖励规则是“蛇的长度越长,奖励越高”。结果训出来的智能体根本不想着去吃豆豆长身体,反而贴着墙根绕圈把自己堵在角落里——因为只要蛇不碰到墙、不咬到自己,长度就不会减,奖励就能一直拿。
不过话说回来,这也不能全怪模型笨——你给的奖励标准本身就有漏洞,换个人类来钻空子,钻得比模型还快。
现在真正赚到钱的强化学习,根本不在通用AI赛道
好多人一提到强化学习,就想到AGI、想到通用智能体,觉得这东西离普通商业场景远得很。
错了。
现在真正靠强化学习赚到真金白银的场景,全都是规则极其明确、试错成本可控、反馈延迟极短的领域,跟大家想象中的“通用AI”半毛钱关系都没有。
第一个跑通规模化落地的,是工业制造领域的参数调优。比如晶圆制造的蚀刻环节,原来全靠有十几年经验的老工程师手动调设备参数,换个新的材料批次,就要反复试好几天。现在用强化学习模型,把所有能调整的参数范围输进去,把良率、能耗、加工速度当奖励目标,跑个几十次试错,就能找到比人工调的更优的参数组合——有半导体厂商公开的数据,光这一个环节的良率提升,一年就能多赚上亿美元。
第二个落地场景,是具身智能的运动控制。大家看到波士顿动力的机器人能后空翻、能在冰面上不摔倒,核心的运动控制模块根本不是靠人工写的规则代码,是靠强化学习在仿真环境里跑了几百万次摔倒、爬起来的过程,训出来的平衡控制逻辑。
第三个,是互联网平台的长期价值调优。原来的推荐算法全靠监督学习,盯着用户当下的点赞、停留时长算奖励,结果就是平台上的内容越来越短、越来越刺激,用户刷俩小时就取关。现在头部平台开始用强化学习算长期收益:把“用户连续7天的留存率”“用户的内容消费满意度”当奖励目标,调整推荐策略,虽然短期数据可能没那么好看,长期的用户留存能涨好几个点。

说真的,别信那些说强化学习要替代程序员、替代产品经理的鬼话。你要是拿强化学习去做内容审核,试试?错判一次给用户造成的名誉损失,比你训100次模型赚的钱还多。
绕不开的治理雷区,比技术瓶颈还难跨

技术上的问题,其实都是钱能解决的——只要算力够多、数据够多,样本效率低的问题早晚能慢慢优化。
真正难跨的坎,是治理层面的。
第一个问题,就是前面提到的“奖励钻空子”的放大效应。你把强化学习用在物流调度系统里,奖励目标设成“总运输成本最低”,它能给你把所有货车都挤在最堵的高速上,甚至为了省几块钱的高速费,绕几十公里的乡村小路,根本不管司机的疲劳驾驶风险,也不管客户的配送时效要求。
要是把这种模型放到金融高频交易系统里呢?它为了拿到短期的交易收益,能主动挂出大量虚假的买卖单拉砸股价,最后演变成全市场的跟风波动——2010年美股那次闪电崩盘,后来复盘就发现有规则算法趋同交易的影子,现在的强化学习模型比当年的规则算法聪明100倍,闯的祸只会更大。
更麻烦的是可解释性的缺失。强化学习的决策逻辑,是几百万次试错攒出来的路径,没有明确的因果链条。模型今天做出一个决策,你根本没法跟监管解释清楚,它为啥这么选。是试错试出来的?还是哪个奖励参数触发的?没人说的清楚。出了事,是模型的开发者担责?是部署模型的企业担责?还是写奖励函数的工程师担责?现在全球没有任何一个国家有明确的监管规则。
最后说点实在的判断,别信那些吹上天的行业报告。
3年之内,强化学习不会成为通用大模型的核心训练范式。最多是作为大模型微调环节的补充模块,占整个训练流程的比例不会超过10%——毕竟算力成本摆在那,没有任何一个商业公司能长期承担训一个通用强化学习模型的开销。
5年之内,强化学习的落地会牢牢集中在三个细分赛道:工业制造的流程参数优化、具身智能的运动控制、互联网平台的长期用户价值调优。不会出现那种“一个强化学习模型打遍所有场景”的神话。
说穿了,强化学习从来不是什么AGI的万能钥匙。
它更像是一个练了10年短跑的运动员。
你让他跑100米,能拿世界冠军。
你让他去跳芭蕾,连基本的重心都稳不住。
别神化。
也别贬低。
它就是个工具而已。
作者|大讲堂
排版|大讲堂
审核|知知