 大讲堂

上周跑WAIC的展台,脚都磨出泡的时候,我在一个虚拟人厂商的展架前停了十分钟。
那个数字人站在屏幕里,穿着定制的西装,说话的口型跟实时语音流严丝合缝。我故意对着摄像头做了个单侧挑眉加撇嘴的搞怪表情。
它卡了半秒。
然后两边眉毛一起抬了起来。
我当时就笑了。
那是我第三次在同类型展台遇到一模一样的bug——号称端侧实时渲染的数字人,在遇到非预设的微表情组合时,要么直接僵住,要么把简化后的肌肉绑定逻辑直接暴露在观众面前。很多人看完觉得数字人“假”,根本不是因为皮肤材质做的不好,是肌肉的运动逻辑从根上就不对。
先拆穿行业的“遮羞布”:什么才算真的“实时肌肉模拟”?
现在行业里吹的“实时面部模拟”,十有八九是偷换概念。
传统的BlendShape形状混合方案,就是建模师手工在三维模型上做几十到几百个预设表情——比如“抬左眉”“撇嘴”“微笑”,驱动系统只需要实时计算每个预设表情的权重,把不同的形状按比例混合在一起,就能生成看起来动态的表情。这套方案用了快二十年,从早期的游戏角色到现在的直播数字人,本质上从来没变过。你把混合的速度提到60帧,把预设的表情数量加到500个,它还是“搭积木”的逻辑,跟真实的肌肉运动半毛钱关系都没有。
真的基于解剖学的实时肌肉物理仿真,逻辑完全不一样。首先要把人脸上的42块表情肌的起止点、收缩方向、拉力大小,甚至不同皮下脂肪厚度对肌肉形变的影响,全部按照真实的解剖结构做进三维模型里。驱动的时候根本不需要预设任何表情——只要给摄像头捕捉到的面部动作对应的肌肉收缩信号,系统就会实时计算每一块肌肉收缩的时候,会拉扯哪部分皮肤,会形成什么样的纹路,甚至会因为肌肉的联动,带动相邻的软组织产生什么样的微小形变。
举个最直观的例子:真实的人做一个假笑的动作,只有嘴部的肌肉在动,眼角的眼轮匝肌是不会收缩的,所以假笑的时候眼角不会出现自然的鱼尾纹;但如果是发自内心的笑,眼轮匝肌会跟着一起收缩,眼角的纹路是自然挤出来的。这种联动关系,靠手工做BlendShape是根本覆盖不全的——你要把所有可能的肌肉联动组合都做成预设形状,少说要做上万个模型,端侧设备根本跑不动。
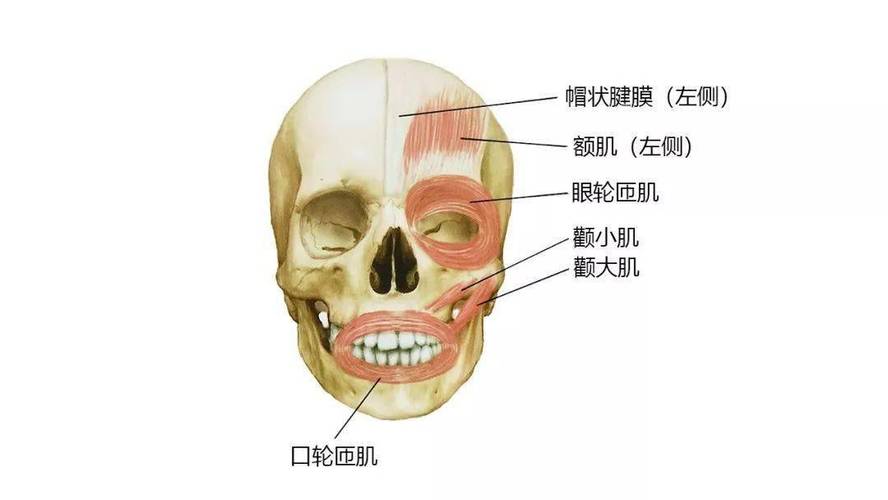
这也是为什么很多数字人看着“僵”:因为预设的表情是孤立的,没有真实的肌肉联动,你做个抬眉的动作,它的额头纹路是浮在表面的,不会因为肌肉的拉扯,连带着眼尾的皮肤一起动。太假了。
现在的玩家们,都卡在哪一步?
我跟圈内几个做驱动算法的工程师聊过,大家的共识是:现在的实时肌肉模拟,技术上已经能做出来了,但是离大规模商用还差好几个坎。
首先是算力的问题。最开始这套物理仿真的方案,是影视行业先用起来的——比如《阿凡达》系列里的纳美人面部表情,就是用离线的肌肉仿真算出来的,一帧画面的渲染时间要好几分钟,根本不可能实时。直到最近两年,英伟达在Omniverse里推出了针对数字人肌肉仿真的优化模块,才能做到单张消费级显卡跑30帧的实时效果。
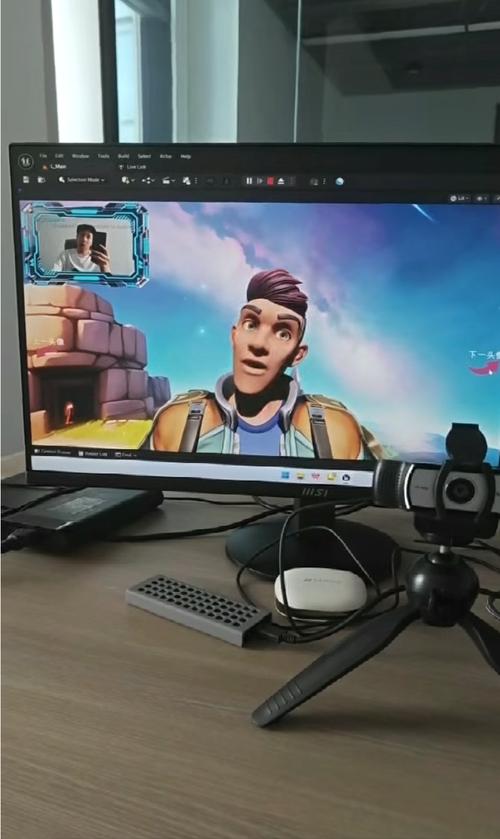
但就算是这样,这套方案对硬件的要求还是太高了。你要想在手机上跑,就得把本来需要GPU集群计算的仿真模型,通过蒸馏、量化的方式压缩到端侧的NPU上,压缩完的模型精度会掉多少,谁心里都没底。
然后是非常现实的商业矛盾。我之前碰到个创业团队的技术负责人吐槽,说他们按照真实的解剖学逻辑做了套肌肉仿真模型,上线给客户演示,结果被客户骂了——“你这个数字人笑的时候,为什么眼角的纹路这么深?我们要的是上镜好看的标准微笑,不是真实的人笑的时候皱巴巴的脸。”
最后没办法,他们只能把模型里的眼轮匝肌收缩强度调低了30%,把皮肤的粗糙度参数改高,让纹路看起来浅一点,才过了客户的验收。
你看,技术上的“真实”,有时候跟商业上的“好用”根本是两码事。现在大部分客户要的不是跟真人一样的数字人,是好看、不出错、符合大众审美的数字人,这种需求下,谁会花大成本去做实时肌肉模拟?用BlendShape做的预设表情,调得好看又稳定,成本还低,何乐而不为?
真正落地的时候,没人关心你的技术参数
我之前做过一个调研,问了身边二十个经常看直播的用户,对现在的直播数字人有什么不满。所有人的答案都出奇的一致:“看着像个机器人,说话的时候表情跟内容对不上。”
为啥对不上?因为现在的直播数字人,大多是把语音转成对应的口型,然后搭配几个预设的“开心”“疑惑”“惊讶”的表情模板,根本没有实时的肌肉反馈。你说“这个产品今天打五折”,它就切到“开心”的模板笑一下;你说“大家有问题可以打在公屏上”,它就切到“疑惑”的模板歪一下头。久了谁都能看出来假。
如果实时肌肉模拟真的落地了,第一个被颠覆的就是直播数字人的成本结构。以前做一个定制的高保真数字人,建模师要花两三周的时间,手工调几百个BlendShape的权重,光这部分成本就要十几万。现在只要把对应的面部肌肉参数输进仿真系统,所有的表情联动、皮肤纹路、微表情变化都是自动生成的,建模的时间能压缩到两三天,成本直接砍到原来的十分之一。
更有想象力的场景其实是在交互端。比如以后的车载数字人,当你开长途累了打哈欠的时候,它能实时做出跟着打哈欠的表情;当你因为堵车皱眉头的时候,它能同步做出安抚的微表情。这种基于实时肌肉模拟的情绪反馈,是以前的预设表情根本做不到的。
但随之而来的风险也一点都不小。现在的人脸支付、人脸身份认证,本质上是识别你面部的静态结构,但是如果实时肌肉模拟的技术成熟了,别人只要拿到你的面部三维结构数据,就能实时驱动一个跟你一模一样的数字人,连肌肉运动的节奏、表情的细微变化都跟你毫无差别,摄像头根本分不出来对面是真人还是数字人。之前有个实验室做过测试,用这套实时驱动的数字人打视频电话,连续聊10分钟,有六成的测试者没发现对面是AI。
这哪是数字人啊,这是给深度伪造开了个直通车。
很多厂商现在吹,说再过一两年实时肌肉模拟就会成为消费级数字人的标配。我反正不信。
3年之内,这个技术根本下不到手机端。现在就算是旗舰手机的NPU,要同时跑大语言模型的推理、摄像头的实时捕捉、肌肉仿真的物理计算,算力根本不够。你总不能让用户开个数字人,手机烫得能煎鸡蛋吧?
真要等这个技术普及,大概要到5年左右。等端侧的NPU算力摸到100TOPS的门槛,等仿真模型的压缩技术再成熟个两代,那个时候的数字人,才真的能做到你做什么表情,它就跟着做出什么表情,连你笑的时候苹果肌抬多高、法令纹深多少,都跟你同步。
不过也别太乐观。就算技术真的到了那一步,数字人还是会有“假”的地方。毕竟真实的人脸上的微表情,很多是不受自主控制的——比如你紧张的时候会不自觉的舔下嘴唇,你撒谎的时候眼珠会不自觉的往旁边瞟,这些行为层面的细节,靠肌肉模拟是算不出来的,还得靠长期的行为数据训练才能补上。
离真正的“活人感”,哪有那么容易到啊。
作者|大讲堂
排版|大讲堂
审核|满满