 大讲堂

上周跟某城商行零售风控部的老陈在楼下咖啡店碰了碰,他点了杯冰美式,刚坐下来就把笔记本电脑往桌上一摔。
去年他们行花了大几百万上的通用大模型风控系统,本来想着能把坏账率压下去2个点,结果上线3个月,优质工薪客群的拒贷率涨了30%。更离谱的是,有个在国企上班、连续5年公积金月缴8000多的用户来申贷,系统直接拒了。问后台为什么拒,出来的结论是”综合风险维度偏高”。
连个具体理由都没有。
老陈说,监管上周刚发了整改通知,要求他们10天内把所有拒贷用户的决策理由逐笔回溯清楚,拿不出具体因子贡献的,一律算违规。他这几天加班到凌晨,翻遍了系统的后台日志,愣是找不到哪一步出了问题——大模型的推理过程像个密不透风的黑箱,喂进去的是用户的征信、收入、行为、社交数据,吐出来的是一个冷冰冰的分数,没人知道分数是怎么算出来的。
老问题的新死结:为什么传统多因子模型撑不住大模型时代的风控?
其实传统的风控多因子模型,本来就是为了”可解释”设计的——比如早年的逻辑回归模型,把征信分、收入流水、负债比例、设备风险、历史逾期记录拆成5-10个核心因子,每个因子占多少权重明明白白,坏账出来了,挨个查权重就能找到问题:比如是不是最近把”近3个月查询次数”的权重提太高了,把很多只是临时缺钱的优质用户给拒了。后来的XGBoost、LightGBM这些树模型,虽然比逻辑回归复杂,但也能通过特征重要性排序,把每个因子对最终结果的贡献度算清楚,满足监管的可解释要求。
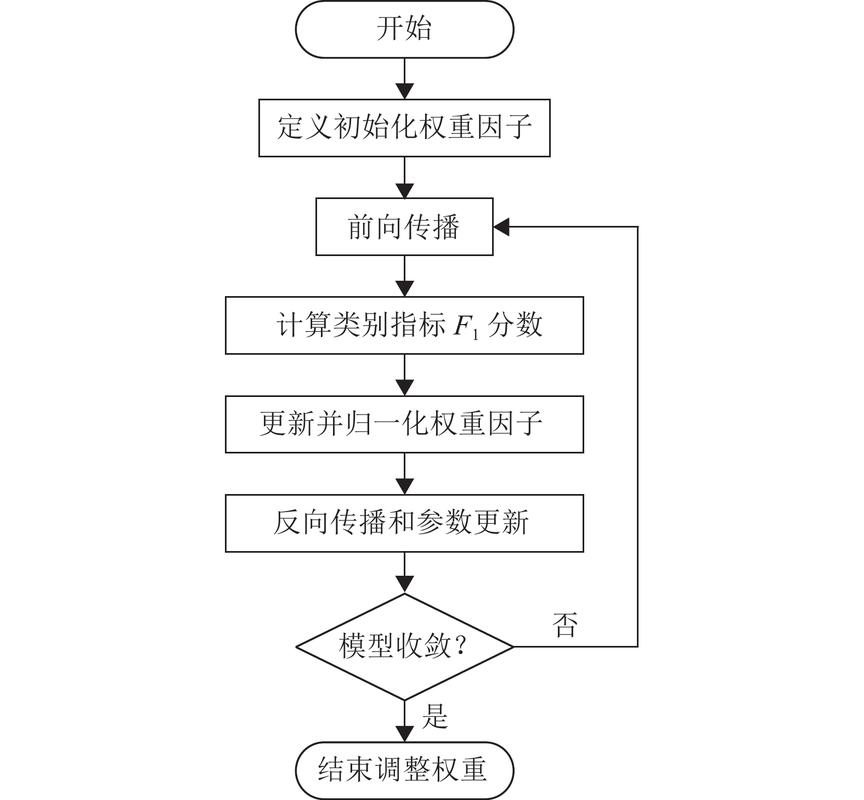
但是大模型出来之后,这套逻辑完全被打破了。现在的金融大模型,为了追求更高的风险识别率,会把所有能拿到的非结构化数据全喂进去:用户在APP里的点击路径、跟客服的对话记录、水电燃气的缴费时间、甚至快递的收件地址变动频率。这些数据拆成的特征维度可能有上万个,传统的特征重要性计算方法根本算不过来。更麻烦的是,大模型的推理是基于注意力机制的,同样的用户行为,在不同的场景下对风险的影响权重可能完全不一样——比如用户连续3天查网贷额度,对刚毕业的年轻人来说是高风险信号,对开公司的小微企业主来说可能只是临时周转的正常操作。
这就麻烦了。
持牌金融机构的风控,从来不是”识别率越高越好”——你为了多抓1%的高风险用户,把10%的优质用户拒之门外,这种模型就算识别率再高,也没人敢用。更别说监管的硬要求:每一笔贷款的批贷、拒贷决策,必须能给出可量化、可回溯的解释,不能拿”模型综合判断”当挡箭牌。
技术边界在哪:多因子风控归因到底是给大模型”装X光”还是”套枷锁”?
我最近跑了10多家做金融大模型的厂商,发现现在行业里对归因的理解,其实差得特别远。
有一半厂商的所谓”归因”,根本就是事后补的——先把大模型训完,跑出来风险分,然后拿SHAP、LIME这些通用的事后解释工具,倒推每个特征对最终分数的贡献值。这就像你考完试拿标准答案对着卷子倒推哪道题错了,根本反映不了你考试当时的思考路径。更扯的是,这种事后算出来的归因结果,经常跟大模型本身的推理逻辑对不上——比如大模型明明是因为用户的客服对话里提到”最近要还信用卡”才拉高了风险分,事后SHAP算出来的核心贡献因子却是”用户的设备IP在工业园区”,完全驴唇不对马嘴。
那真正能用的多因子风控归因是什么样的?
说白了,就是在大模型训练的一开始,就把可解释的多因子层跟大模型的注意力模块做绑定——把所有的输入数据,先映射到标准化的因子层(比如”网贷查询频率””公积金缴存稳定性””设备欺诈风险”这些行业通用的因子),然后大模型在推理的时候,每一步的注意力权重,都直接对应到这些标准化因子的贡献值,不是事后倒推,是从训练到推理全链路可追溯。
举个实际的例子,某头部消金机构去年上线的带原生归因的大模型风控系统,给一笔10万的消费贷批了8万额度,系统能直接给出三个核心贡献因子:公积金缴存稳定性(贡献度62%,正向)、近3个月网贷查询3次(贡献度28%,负向)、近1年有1次信用卡逾期7天以内(贡献度10%,负向)。不管是用户问为什么额度是8万不是10万,还是监管查为什么给这个用户批贷,拿这个解释出去,没人会挑毛病。
当然,这套技术的瓶颈也很明显。首先就是因子映射的成本——不同银行的因子体系根本不一样,A银行把”公积金连续缴存12个月”当成优质客群的核心因子,B银行可能把”代发工资连续6个月”当成核心因子,没有通用的映射标准,每个客户都要做定制化的因子层对接,落地成本比原来的通用大模型高了至少30%。其次就是大模型的推理速度——原来的端到端大模型,跑一笔风控决策只要20毫秒,加了原生归因层之后,速度要慢一倍,对高并发的场景来说,还是不小的挑战。
不过话说回来,能解决”说清楚理由”的问题,慢一点、贵一点,金融机构是愿意买单的。毕竟没人愿意为了快20毫秒,最后被监管罚几百万,或者被用户投诉算法歧视。
绕不开的治理坑:归因算错了,比黑箱风控还危险
很多人觉得,大模型的风控风险是”黑箱说不清”,其实更危险的,是”归因算错了还拿这个当理由”。
之前看到过一个很离谱的案例,某股份制银行的大模型风控系统,把”用户申请贷款时用的手机壳是白色”当成了低风险因子,给这类用户的额度直接上浮20%。后来做回溯才发现,训练数据里,用白色手机壳的用户的平均坏账率,刚好比其他用户低了0.2个百分点,大模型就把这个毫无逻辑的相关性,当成了核心的风险判断依据。如果当时的归因模块没有把这个无意义的因子揪出来,给几十万用户提额,最后可能要多产生几千万的坏账。
还有更隐蔽的算法歧视问题。比如某城商行的模型,把”用户常住地址在老城区”当成高风险因子,给这类用户的拒贷率比其他区域高了40%。后来做用户调研才发现,那个老城区的居民平均收入跟全市水平完全持平,只是之前有过3起电信诈骗的案发地址在那,模型就把整个区域的用户都打上了高风险标签。这种如果归因模块没有做偏差校验,最后不仅会引发大量客诉,还会涉嫌消费领域的算法歧视,监管的处罚可不是小数目。
现在监管其实已经把这些坑都提前指出来了。去年出台的《生成式人工智能服务管理暂行办法》,还有针对金融领域的大模型应用指引,都明确要求:金融大模型的所有风险决策,必须定期做因子偏差校验,不能把无因果关系的相关性当成风险判断依据。说白了,你不能因为冰淇淋卖得多的时候溺水的人多,就把卖冰淇淋的人当成高风险目标——这种相关性,跟风险半毛钱关系都没有。
聊点实在的,未来3年这个赛道的几个确定性趋势,我觉得现在已经看得很清楚了。
第一,所有能在持牌金融机构落地的大模型风控系统,一定是把多因子归因作为原生核心模块的,那些靠开源模型微调一下就敢吹”通用金融大模型”的厂商,迟早要被淘汰。毕竟现在银行采购负责人的第一句话,根本不是问你的模型参数量有多大、识别率有多高,而是问”你的归因能精确到哪个粒度?能逐笔回溯每笔决策的因子贡献吗?”答不上来的,连报价的机会都没有。
第二,归因能力会成为金融大模型的核心付费点。原来大家买大模型,是买推理能力,是买”能不能抓更多坏账”。现在不一样了,大家愿意为”能说清楚为什么”付更高的溢价——毕竟金融行业的本质是信任,你连为什么给人批贷、为什么拒贷都说不清,用户不信你,监管也不认你。
第三,会出现专门的第三方大模型风控归因审计机构,就像现在的会计师事务所、征信机构一样。未来监管不可能挨个去查每个银行的大模型系统有没有偏差、有没有歧视,第三方审计机构会定期给每个机构的模型做”体检”,把那些无意义的相关性、有歧视性的因子全部揪出来。这个赛道的规模,未来可能比现在的大模型本身还要大。
老陈最后跟我说,他们行现在已经把原来的通用大模型系统给停了,换了一套带原生多因子归因的垂直模型。上周测了一下,那个之前被拒的国企员工,现在系统给的理由明明白白:近1年有1次信用卡逾期3天,所以额度从20万降到12万。
这才是能用的风控。
作者|大讲堂
排版|大讲堂
审核|阿辰