 大讲堂

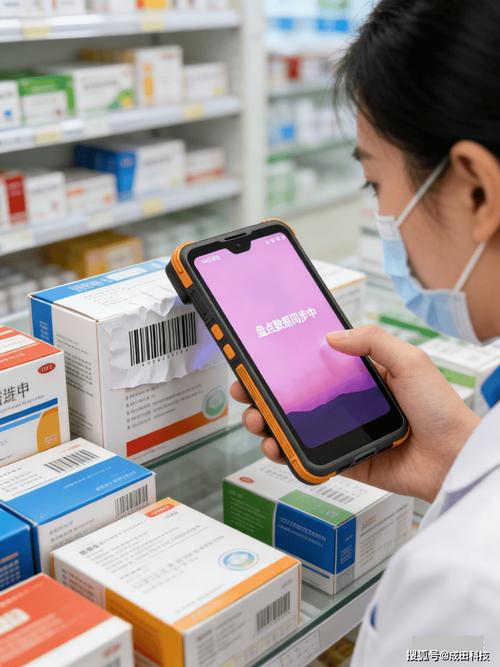
2026年Q2我去苏州出差,在临顿路的一家连锁药店买感冒药,本来以为要像以前一样,掏医保卡、刷脸、授权近3个月的就诊记录才能走门诊统筹报销,结果店员指着柜台角落的一个小屏幕让我站过去就行。
3秒之后,打印出来的报销小票直接从机器里吐出来了。
我当时愣了。
问店员这是什么操作?她说这是上个月刚上的零知识证明核验系统,不需要你提供身份证号、病史、购药记录,系统只需要验证两个结果:你有没有达到门诊统筹的起付线,你有没有骗保的黑名单记录。其他信息一概不收集。
当时全网就这个事吵翻了。
有人拍桌子说这是骗保的温床——你连用户买了啥、有啥病史都不看,怎么知道他是不是冒名刷医保?
也有人举双手赞成——之前为了过合规,不管是医保局、药店还是线上购药APP,都能名正言顺要你授权全量就诊记录,美其名曰“风控需要”,现在倒好,谁再要这些全量数据,谁就是理亏。
药店门口的核验风波,把zk的遮羞布扯碎了
我当时拉着药店的运营负责人在门口抽了根烟,他给我算了笔账:之前他们做医保核验的系统,光数据脱敏的成本,每年就要占整个信息化项目预算的32%,因为要把用户的姓名、病史、住址这些敏感信息从数据里抠出来,还要防黑客拖库,防内部员工泄露,每年光安全审计就要花小几十万。上了这套zk系统之后,脱敏团队直接裁了一半,因为系统从根上就不碰用户的原始数据,根本没有“需要脱敏”的东西。
苏州试点3个月,单店每次医保核验需要用户授权的敏感字段从平均12.7个——包括身份证号、近6个月购药记录、既往病史、家庭住址——直接降到0。这是什么概念?相当于原来每次核验要你把整个钱包的银行卡、身份证、门禁卡全倒给药店老板看,现在只要你掏出来一张盖了官方认证章的资格条,对方连你条上写了啥具体内容都看不清,只知道章是真的。
当时我那个做医保信息化的朋友,在酒桌上骂了整整半小时娘。他说之前他们投了上千万做数据中台,做隐私计算,结果zk一上来,直接把他整个中台的核心价值给干没了——原来他卖的是“帮你把用户数据脱敏了再流通”,现在zk根本就不需要流通数据,那他的中台还有啥用?
不是技术突破,是旧利益网的裂缝
很多人说零知识证明是密码学的终极圣杯,我倒觉得,它本质就是一把撬棍,直接把原来数据流通领域的利益网给撬出了裂缝。
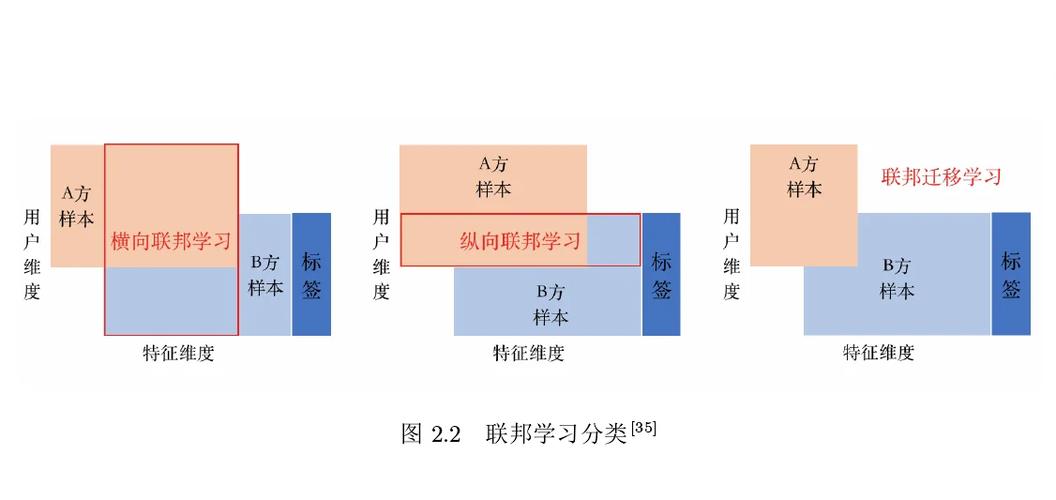
之前国内做隐私计算的那帮公司,卷了快5年,从MPC到联邦学习,吹得天花乱坠,说自己是“数据要素流通的高速公路”。但实际落地的时候,大家都知道是什么德行:所谓的“数据不出域”,本质是模型跑到数据那边跑,还是要跨机构传梯度、传参数,还是有泄露风险,而且成本高得离谱。
同等风控精度下,原来的跨机构联邦学习方案,对接3家合作方的系统成本约1200万,跑一次千万级用户的联合反欺诈任务,单轮算力成本是18万,而基于zk的零知识证明方案,单轮算力成本只要2.1万,差了整整8.5倍——相当于你原来开燃油车跑100公里要花70块油钱,现在开同续航的电动车只要8块钱,谁还会加油?
这就像阵地战里,原来的双方要在中间挖交通壕、设观察哨,靠反复试探对方的兵力部署找突破口,现在突然出现了一款可以完全隐身的单兵作战系统——你能直接摸到对方的指挥阵地,对方连你从哪个方向来、带了多少人都摸不清,原来靠承包战壕工程、卖观察哨设备的那帮承包商,当然要集体跳脚。
本土的玩家反应比我想的快多了。秘猿科技2025年底就把原来做公链的团队一半人抽出来,专门做面向政务场景的zk证明生成器,去年给杭州公积金中心做的跨城市购房资格核验项目,现在已经跑了12万用户的量——原来用户要异地办公积金贷款,得开3份纸质证明,盖7个章,寄来寄去要花一周,现在用zk,30秒就能生成有效证明,用户的缴存金额、单位信息、租房记录这些敏感内容,根本不会被购房地的公积金中心看到。
有意思的是,我去年跟某头部隐私计算公司的BD吃饭,他说现在KPI压得快喘不过气,原来的客户天天问,为什么隔壁用zk的方案成本只有他们的1/8,还不泄露数据?他现在每天的工作就是跟客户解释,zk就是个噱头,算力成本特别高,根本不适合大规模落地——结果转头他跟我透底,他们技术团队已经在偷偷搭zkEVM的测试网了,就等明年政策松了直接切方向。
你攒了十年的“数据资产”,可能一文不值
很多人觉得零知识证明是离普通人很远的密码学黑科技,其实它对产业链的冲击,比当年的移动支付还要猛。
先给普通从业者算笔账:如果你是互联网公司的产品经理,之前你的核心工作是什么?是想办法引导用户授权更多权限,收集更多用户数据,做精细化运营,给用户推更准的广告。如果你是算法工程师,之前你的核心竞争力是什么?是能拿到全量的用户行为数据,堆更大的模型,把推荐准确率提升1个百分点。如果你是合规岗,之前你的日常工作是什么?是写几百页的隐私政策,弹一个又一个的授权框,跟用户扯皮说“我们需要你的位置信息才能给你提供附近的服务”。
等zk的成本降到现在的1/10,这些玩法全都会失效。
你根本不需要用户的位置信息,只要用zk证明“用户在你门店的3公里范围内”就行,连用户具体在哪都不知道。你根本不需要用户的全量浏览记录,只要证明“用户对某类商品有潜在兴趣”就行,连用户之前看过啥都看不到。你根本不需要写几百页的隐私政策,因为你从根上就没碰过用户的原始数据,哪来的隐私泄露风险?
当然,我也得说句实在的,现在很多公司拿zk当合规遮羞布,本质还是在收集全量用户数据,只是把数据加密了存在自己的服务器里,美其名曰“隐私保护”,其实跟原来的明文收集没有任何区别。这个方向我认为走偏了。零知识证明的核心从来不是“加密存数据”,是“根本不需要拿到数据”。
现在那帮zk工程师的薪资已经涨得离谱了。2024年的时候,有2年zk开发经验的工程师,年薪大概是40万,2026年春招的时候,同经验的工程师已经开到120万,还抢不到人。但说实话,这些薪资泡沫迟早会破——等zk的框架成熟到像现在的Java一样通用的时候,根本不需要那么多专门的zk开发工程师。
真正会被淘汰的,从来不是写代码的人。
是那些靠“收集用户隐私、打通数据孤岛”作为核心商业模式的公司,是那些把“数据资产”当核心估值的平台,是那些原来靠卖数据脱敏、隐私计算通道赚过路费的服务商。
等zk的算力成本降到现在的1/10的时候,所有还在靠“收集全量用户数据做精细化运营”赚流量钱的公司,都会发现自己手里攒了十年的几PB用户数据,根本没有用——你总不能把用户十年前买过什么牌子的卫生纸,当核心竞争力吧?
你猜,第一个跳出来反对zk大规模落地的,会是靠卖数据赚钱的征信公司,还是靠收集用户数据赚广告费的互联网大厂?
作者|大讲堂
排版|大讲堂
审核|小北