 大讲堂

咖啡早就凉透了。
他面前的三块屏幕上,最中间那块跑着的扩散模型没有像大家熟悉的那样,输入几个关键词就生成赛博朋克的雨夜街景、穿着宇航服踩滑板的橘猫,而是在把一堆从老录像带、旧照片里抠出来的、被岁月磨得只剩模糊色块的随机噪点,一点点往真实的影像上推。
他从追热点的赛道上,拐去了没人走的小路
阿凯是我读博时候同系的师弟,前两年在互联网大厂的生成式AI部门做核心研发,按他当时的职级,年薪七位数是起步的。去年秋天他外婆走的时候,他赶回老家奔丧,翻遍了家里三个抽屉的相册,才发现能找到的外婆的影像,要么是二十年前用VHS录像带拍的、糊得连眉毛都看不清的截帧,要么是过年时候亲戚凑在镜头前拍的大合影,外婆永远站在最边缘,脸被旁边人的肩膀挡了小半。
他说那天他坐在老家的堂屋,看着手里的老照片,突然就不想回去上班了。
之前在大厂做项目的时候,团队的KPI永远围着“生成效率”“商用转化率”转——模型生成的海报能不能让电商的点击率涨两个点,生成的短视频素材能不能帮MCN机构省一半的剪辑成本,生成的虚拟人能不能替代客服接电话。这些目标当然没错,但那天他盯着照片上外婆模糊的脸,突然觉得,这些事好像没有那么重要。
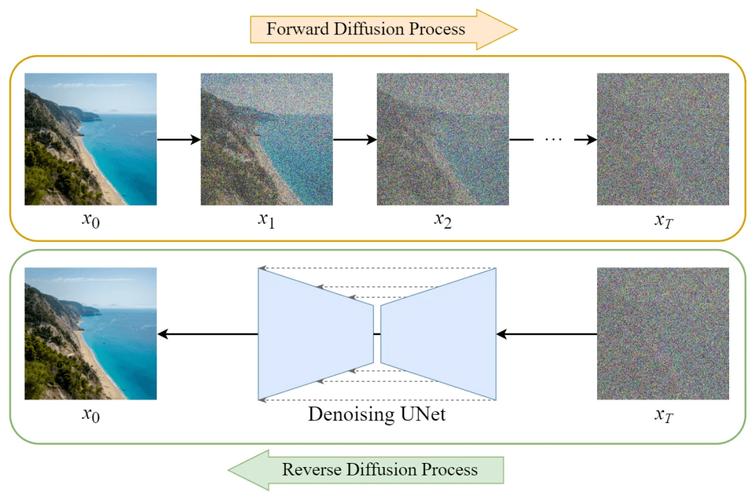
他找了实验室的导师,说想把自己之前研究了快三年的扩散模型方向,从商用文生图,转到老影像修复上。导师当时以为他只是丧亲之后情绪不好,劝了他好久,说这个方向太“小众”,没有商业化前景,投论文也很难拿高分。他没辩解,就把自己在宿舍偷偷跑了一周的demo放给导师看——屏幕上全是随机分布的雪花噪点,随着模型一步步迭代,噪点被逐层剥离,慢慢露出外婆穿着藏青布衫站在橘子树下的轮廓,最后连她鬓角那缕白头发、笑起来时候眼角的细纹都清清楚楚。
导师看完半天没说话,临走的时候拍了拍他的肩膀,给他开了实验室最高等级的GPU资源权限。
那些从来没上过产品发布会的应用
说实话,之前我对扩散模型的认知,也停留在“生成式AI的玩具”层面。直到那天在实验室,阿凯给我翻了他这半年帮别人修复的几百段老影像,我才突然反应过来,我们之前对这个技术的误解有多深。
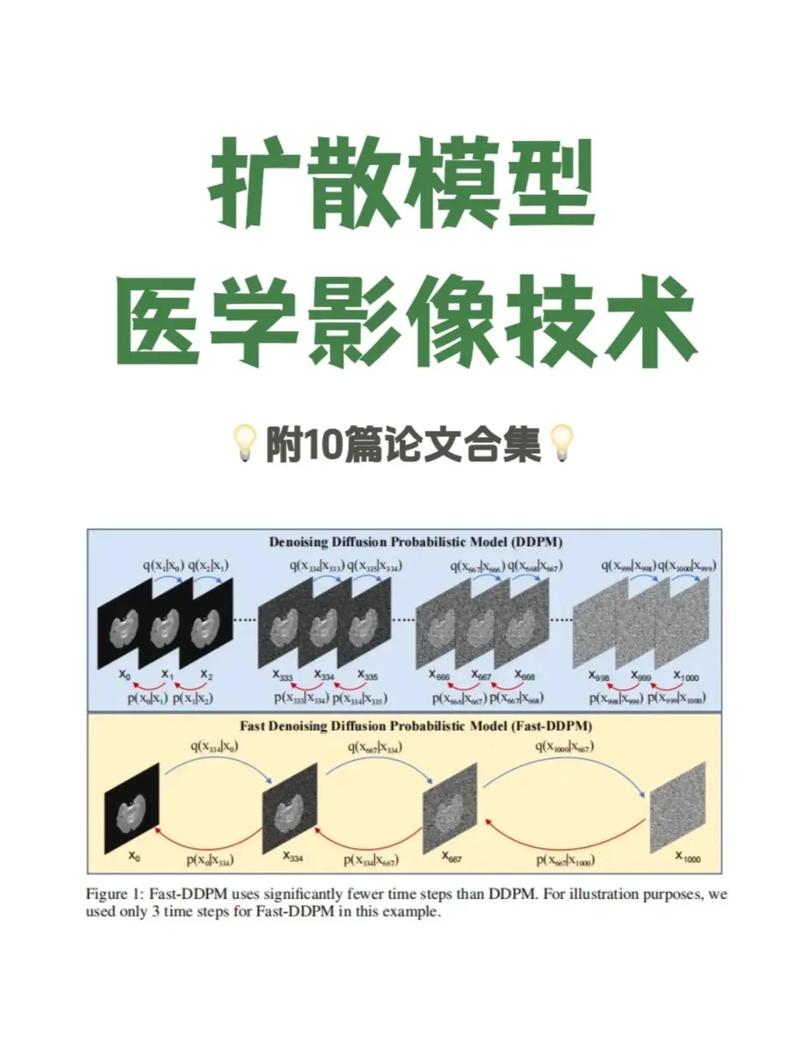
他说根本不是大家想的那样,扩散模型的核心不是“无中生有编东西”,逻辑反过来才对——训练的时候,模型先给一张清晰的原图逐次加噪,直到整张图变成没有任何规律的雪花屏;推理的时候,再学着一步步把这些噪点剥掉,还原出最开始的清晰图像。听着是不是有点像文物修复师补碎掉的瓷瓶?
以前的老照片修复软件,本质上是靠算法“猜”哪里该补什么颜色,经常把老人脸上的皱纹磨得像塑料假人,把眼睛修得对称得像复制粘贴,连说话的声音都修得没有一点烟火气。但扩散模型不一样,它在训练的时候见过太多真实世界的影像纹理、光影逻辑、甚至人在说话时候的微表情,知道老人的皮肤不是光滑的,知道风刮过树叶的时候影子会晃,知道人激动的时候声音会发颤。
找他做修复的人什么身份都有。有拍了十年三峡移民纪录片的导演,素材因为早年的磁带受潮,三分之一的片段全是噪点,里面有个老太太坐在门槛上对着镜头讲当年搬家的事,之前用了好几个商用修复软件,要么把老太太的声音修得像机器人,要么脸变形得根本认不出来。阿凯用自己微调的模型跑了三个晚上,出来的片段里,老太太嘴角的那颗痣都清清楚楚,连她说话时候喉咙里的痰音都没被修掉。导演拿到片段的时候在电话里哭了快十分钟,说这是他拍了十年,最完整的一段素材。
还有个刚上初中的小姑娘,找过来的时候带着一张她爸爸的老照片——她爸爸在她三岁的时候因为车祸走了,家里能找到的爸爸的影像,只有一张当年拍的证件照,连动态的视频都没有。阿凯帮她把照片生成了一段10秒的动态视频:年轻的爸爸穿着藏蓝色的工装,对着镜头挥了挥手,笑着说“放学早点回家”。小姑娘拿到视频的时候,给阿凯发了个小红包,里面装了她攒了好久的23块钱零花钱。
阿凯说他从来没跟这些人收过费,实验室的GPU资源够跑,花点时间的事,换回来的那些感谢,比之前在大厂拿的任何季度奖金都实在。
被重新定义的“真实”
之前网上总有人骂,说用扩散模型生成和已故亲人的合影、动态视频,是对记忆的亵渎,是自欺欺人,是把虚拟的东西当真。我之前也有过类似的顾虑,直到上次我把自己家里一张糊掉的、我爸抱着一岁的我的老照片发给阿凯,他跑了不到十分钟,就生成了一段3秒的动态片段:留着长头发的我爸,穿着洗得发白的牛仔外套,在院子的石榴树下面把我举过头顶,我笑得口水都流在他的衣领上。
我盯着那段视频看了好久,根本不觉得这是“假的”。
我们对一个人的记忆,本来就不是像素级精确的。你能准确说出你外婆的脸上有几颗痣吗?你能准确记得你爸爸上次跟你说话的时候,穿的衣服是什么颜色吗?不能的。我们的大脑本身就是个不停在“去噪”的扩散模型——把那些无关的细节、那些当时的嘈杂、那些已经模糊的感官记忆一层层筛掉,最后剩下最核心的、最柔软的部分。不过话说回来,谁的记忆不是带点自己脑补的细节呢?那些被模型补全的细节,本来就藏在我们的记忆里,只是之前的照片没拍下来而已。
当然也有闹心的时候。比如前阵子有个做网红的找过来,想让阿凯用扩散模型生成一段“自己和去世的爷爷互动”的视频,说要发抖音涨粉,开直播带货。阿凯直接把人拉黑了。换谁谁不烦啊?他说技术可以用来接人没处放的遗憾,但不能用来割流量的韭菜。
天快亮的时候,阿凯在折叠椅上睡着了。屏幕上的模型还在慢慢跑着新的一批噪点,一点点往一张新的老影像上靠。窗外的太阳已经升起来了,把香樟树的影子拉得很长,路上的早高峰已经开始堵了,卖早餐的摊子冒着白汽。
我轻手轻脚地带上门出来的时候,突然想起之前看的科幻小说里写的,说未来的技术会把人变成没有情绪的代码。可那天我看着实验室亮着的屏幕,根本不这么觉得。
我们总在讨论扩散模型会取代多少设计师的工作,会生成多少真假难辨的内容,会带来多少伦理上的麻烦,却很少停下来想,这个技术最打动人的地方,从来都不是它有多强的算力,能生成多复杂的图像。
是它能接住那些快要散掉的记忆。
是它能把我们藏在噪点里的,没来得及好好告别的遗憾,一点点捞回来。
作者|大讲堂
排版|大讲堂
审核|乐乐