2026-10-13 23:22:49 作者:大讲堂
上周在中关村咖啡馆碰着个做AIGC创业的老熟人,他面前的电脑屏幕上一半是扩散模型的训练参数面板,另一半是律所发来的版权函。
他说现在团队已经快被两头逼疯了:客户要的生成精度越来越高,算力成本涨了三倍;另一边,训练用的开源数据集被版权方告了三次,光和解费就掏了小两百万。
真的。
很多人把扩散模型当成下一代生成式AI的终局,其实挤破头进这个赛道的人都知道,这玩意儿从实验室里的demo走到真正能赚钱的产品,差的根本不是那点算法优化的距离。
被神化的去噪逻辑,其实没有那么玄乎
别被那些论文里的马尔可夫链、概率分布术语吓住,扩散模型的核心逻辑说穿了特别简单:先拿一张正常的图,一步步往上面加随机噪点,直到最后整张图变成一片完全没有规律的雪花屏;反过来,再从这片雪花屏开始,一步步把噪点擦掉,最后还原出符合你输入提示词的图。
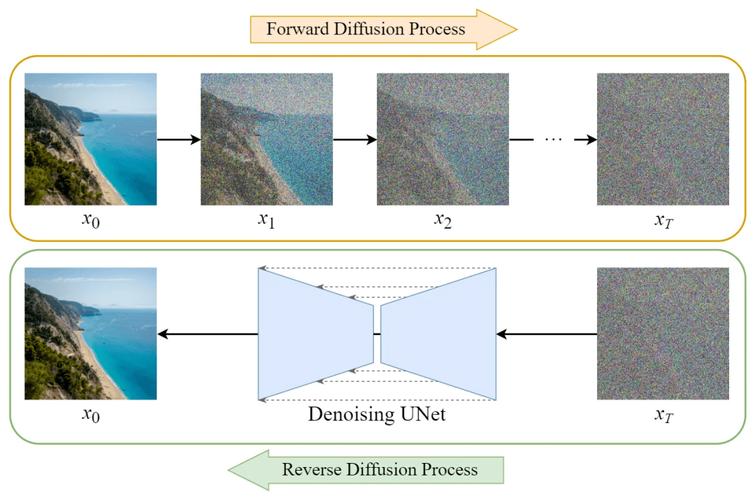 扩散模型前向加噪与反向去噪流程示意图
很多人说它比早年的GAN好,本质是因为GAN是“一次性生成整张图”,很容易出现五官错位、结构崩坏的恐怖谷效果;而扩散模型生成的内容细节更自然,也更容易通过提示词调整方向。
但没人愿意主动提它的硬伤。
扩散模型的核心成本从来不是算法本身,而是反向去噪过程中每一步的算力消耗。
你在Midjourney上输一行字等两秒出图,背后是模型跑了几十步去噪计算,每一步都要占GPU的显存。去年有个做电商图生成的团队给我算过账,单张4K分辨率的商品图,推理成本差不多是8毛钱——听起来不多?如果是大促期间一天生成10万张图,光推理成本就是8万,还不算前期微调模型、清洗数据集的投入。
那些在发布会上拍胸脯说自己的扩散模型推理成本能降到传统方案1/10的团队,大概率是在拿720p的低清图做测试,真放到生产环境里跑4K分辨率、要符合品牌色值的图,成本表能把CFO看得直皱眉头。
挤破头的落地场景,一半是根本站不住脚的伪需求
现在你随便刷科技媒体,都能看到扩散模型的落地案例:电商美工、游戏原画、影视概念图、建筑设计,好像所有跟视觉相关的工作都要被它取代了。
实际上呢?
上个月跟某头部电商平台的内容运营聊,他们去年试过全链路用扩散模型生成商品主图,跑了三个月就停了——因为生成的图根本没办法精准匹配商品的实际颜色,比如消费者收到的口红是正红色,结果生成的主图是橘调的,退单率直接涨了8个百分点。
更扯的是那些吹“用扩散模型做建筑施工图”的案例。施工图要的是精确到毫米的尺寸、固定的承重结构、合规的管线走向,扩散模型本质是概率生成的工具,它能给你画个大概的户型轮廓,但你要是真把它生成的图丢给施工队,最后盖出来的楼墙厚能差出15公分,承重墙都能给你生成成空心的。
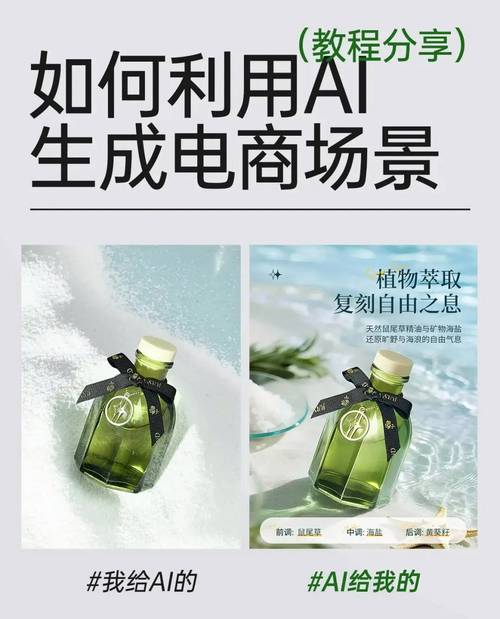 电商平台商品图扩散模型生成前后对比
真正能跑通的场景,其实都有个共同特点:对精度的要求没那么极致,对创意发散的需求远大于精准度要求。比如游戏里的场景概念草稿、短视频的背景素材、广告的创意初稿——这些内容本来就需要反复改,用扩散模型先出个十版八版的方向,设计师再在基础上调整,确实能省不少时间。
不过话说回来,现在整个产业链的竞争早就变味了。
当前扩散模型的商业化竞争,已经从“谁生成的图更像人”,转向了“谁能给客户兜住版权风险的底”。
开源模型的训练集里爬了多少没授权的图片,大家心里都有数。之前Getty图片社告Stable Diffusion侵权的案子,到现在都没出最终判决,谁也不敢保证自己用开源模型生成的图,哪天就被版权方找上门。现在To B客户买扩散模型的服务,根本不是冲着生成效果去的,是冲着服务商给的那纸“版权兜底协议”去的——毕竟真出了侵权官司,服务商得帮着赔钱,这个比生成的图好看点难看点重要多了。
没人敢明说的行业雷区
 没人敢明说的行业雷区
聊到风险,很多人第一反应是深伪、是版权,但真在行业里待久了就知道,最容易出问题的雷,其实藏在大家没注意到的细节里。
就拿深伪来说,现在普通用户拿一张消费级显卡,跑个开源的扩散模型,一下午就能生成一段跟真人一模一样的换脸视频,而且因为扩散模型是逐步生成像素的,现有的深伪检测工具根本追不上它的更新速度——你今天训练了个能检测扩散模型生成图的检测器,明天模型改个去噪的步长,检测器就完全失效了。
说真的,我上次刷短视频刷到个换我老板脸的视频,跟他平时开会皱眉头的表情一模一样,要不是知道他那天根本没出门,我都以为他偷偷开小号接广告去了。
还有个更隐蔽的风险:模型的记忆泄漏。
很多企业为了让生成的内容更贴合自己的业务,会拿内部的敏感数据去给开源模型做微调——比如车企拿未发布的车型设计图、律所拿客户的合同文本、游戏公司拿没上线的角色设定图。但很少有人知道,扩散模型的训练逻辑里,会把训练集里的内容“记”在模型权重里,只要输入合适的提示词,就能把你喂进去的内部敏感数据原封不动生成出来。之前某新势力车企就出过这事儿,拿未发布的SUV设计图微调扩散模型,结果有用户输入提示词之后,直接生成了完整的设计草图,提前半个月流到了网上,光研发损失就好几个亿。
聊到对未来的判断,其实行业里有共识,但没人愿意在公开场合说。
3年之内,扩散模型根本不可能取代任何需要高精度要求的专业岗位。它的定位永远是“创意助手”,不是“替代者”——你要拍个精准匹配品牌色的硬广,要做尺寸严丝合缝的工业零件图,要出符合规范的施工图,这些活它干不了,也不该让它干。
5年之内,真正能跑出来的玩家,根本不是那些做通用生成模型的大厂。大家都盯着通用文生图的赛道卷到死的时候,那些扎在垂直场景的团队反而能赚到大钱:比如专门做印刷行业色彩校准的扩散模型,专门做工业产品缺陷检测的扩散模型,甚至是专门给医生做CT影像降噪的扩散模型——毕竟很多人都忘了,扩散模型的去噪逻辑,天生就适合做异常检测、做信号降噪,根本不是只能用来生成好看的图片。
上次跟那个创业的老熟人分开的时候,他说现在团队已经不卷通用文生图了,打算扎去做工业领域的零件缺陷检测。
他说,总不能一辈子靠生成美女图赚钱吧。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:被吹爆的扩散模型:从生成玩具到产业工具,还要跨多少道坎
文章链接:https://lfdjt.com/info_23_25671.html
 大讲堂
