 大讲堂

2026年3月的车圈骂战,我到现在还没忘。
太离谱了。
头部新势力极氪发布的改款001,发布会前半个月全网都在传,这次车机要上7B参数的端侧量化Transformer,能离线处理多轮对话,甚至能帮你写自驾游的攻略。结果发布会当天放实测,连续识别主驾、副驾、后排的12条交叉语音指令,响应速度比上一代快了40%,整车语音模块的待机功耗直接降了60%。有人扒了底层模型的参数表,直接炸了——根本不是什么新架构,是改了3个细节的GRU。
车评圈直接吵成两派。一派拍桌子骂“开倒车”,拿十年前的老模型割韭菜;另一派翻个白眼说“懂个屁,端侧的命是功耗给的”。我当时刷着两边的直播连线,差点把手里的咖啡喷在电脑上。
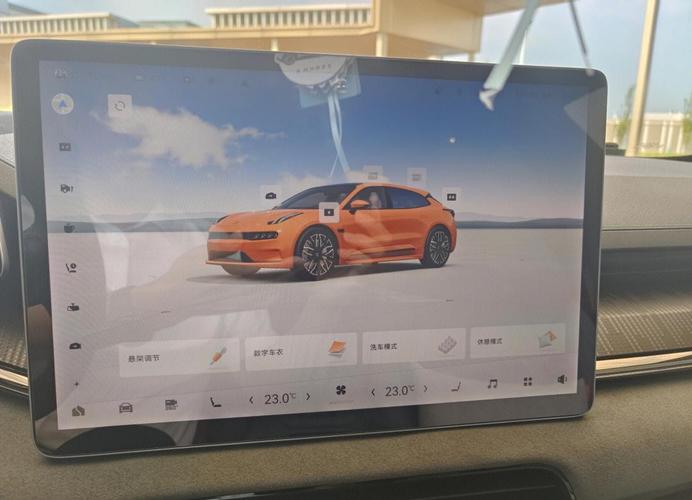
这套GRU模型的整包体积只有18MB,相当于你手机里一张1200万像素的原图大小,而之前行业普遍用的量化端侧Transformer语音模型,最小也要120MB,差了近7倍。我认识的一个极氪的算法工程师私下吐槽,之前团队为了把Transformer的功耗压下来,熬了整整3个月,剪冗余层、降量化精度,最后还是比GRU的功耗高30%——总不能为了个语音交互,把车的续航砍10公里吧?用户算得比谁都清楚。
没人愿意承认,那些被技术圈鄙视了快十年的老模型,正在2026年的端侧场景里,把所有吹得天花乱坠的新架构按在地上摩擦。
GRU的翻红,从来不是技术胜利,是成本账算到骨子里的结果
GRU的逻辑说白了就是给时序信息的流动开了两个阀门,一个管要不要把旧的记忆带进来,一个管要不要把新的信息塞进去,比之前的LSTM少了一个阀门,参数直接砍了近三分之一。没有什么黑科技,就是省。
杭州的Rokid在2025年底踩过的坑,现在很多端侧厂商还在踩。之前他们出的新一代AR眼镜,用的是剪过枝的轻量Transformer做离线语音交互,连续语音交互的续航只有2.5小时,用户骂爆了,说“买个眼镜还要随身带充电宝?”算法团队熬了2个月,把时序语音模型换成了优化过的GRU,直接把续航干到了6.5小时,首发3万台的退货率比上一代低了80%。
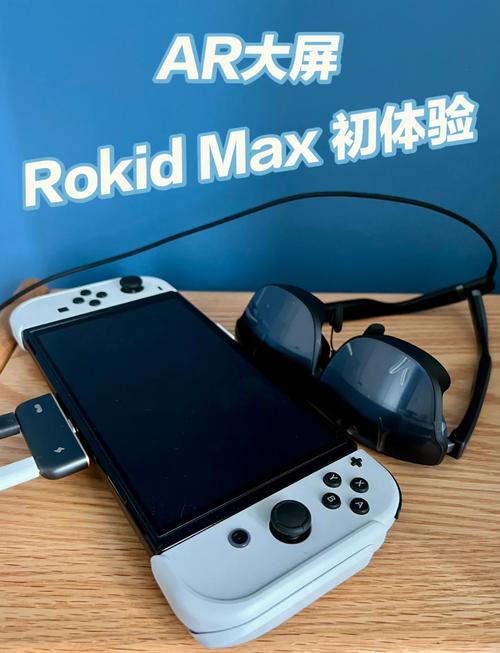
现在的大模型架构竞赛,就像二战时候造重型坦克,大家都在堆装甲堆火炮,觉得越重越厉害,结果GRU就是那种轻装侦察兵,没有厚重的装甲,没有大口径炮,但是跑的快,续航远,在复杂的山地(也就是算力受限的端侧场景)里,比重坦实用10倍。
Rokid当时的技术负责人在内部会上算过一笔账:如果继续优化轻量Transformer,要把同样的语音识别准确率提上去,需要把端侧NPU的算力从2TOPS拉到8TOPS,对应的芯片成本要涨32块钱,而优化GRU只需要在原有算力上改3层网络结构,成本只涨了2块钱,准确率还比之前的Transformer高了2.1个百分点。
说实话,之前很多技术圈的人看不起GRU,觉得是学生作业水平的模型,结果现在大厂的端侧团队偷偷把GRU的代码提交量翻了3倍,谁也不好意思对外说,怕被人说“连Transformer都不会用”。毕竟云端的大模型团队还在卷参数榜,端侧的团队早就被功耗和成本逼到墙角了——你总不能为了用个新架构,把AR眼镜的电池从1000mAh涨到2000mAh,把重量从40g涨到80g吧?用户戴半个小时就压得鼻梁疼,谁买?
被卷怕的从业者,终于在GRU身上找到了新的活路
2025年秋招的时候,算法岗的JD全是“熟悉Transformer架构,有大模型微调经验优先”,非大模型方向的简历连HR的初筛都过不了。我认识的一个普通双非的硕士,投了30多份算法岗,全石沉大海,最后去了个做嵌入式的小公司写单片机代码。结果2026年春招,我刷了几十份端侧团队的JD,近一半都加了一条“有GRU/LSTM时序模型优化经验优先,能把模型参数压缩到20MB以内的直接开2倍薪资”。那个双非的硕士上周刚拿到某头部车厂的offer,薪资比之前做单片机翻了3倍。
我还认识个985的算法硕士,去年还在给70B的大模型做RLHF,天天在朋友圈晒训练 loss 曲线,觉得自己站在技术风口上,今年春招被极氪的端侧团队录了,进去之后天天对着GRU的门函数调参数,头发掉的比去年做RLHF的时候还多,上周跟我吃饭的时候说,“早知道GRU这么吃香,我去年就不啃那几十篇Transformer的论文了”。
产业链的反应更快。之前做端侧芯片的瑞芯微、全志,全在堆NPU算力,从1TOPS堆到5TOPS,再堆到10TOPS,结果发现很多中小客户根本不需要这么高的算力,他们需要的是能跑低功耗时序模型的芯片。现在这些厂商都开始在芯片里加专门的GRU推理加速单元,整体成本降了15%,出货量反而涨了40%。
更有意思的是那些中小硬件厂商。之前很多做智能门锁、老人手环的小厂,想做个离线语音交互,要么掏几十万买云端的API授权,一年服务费十几万,要么用开源的Transformer模型,跑起来功耗高得离谱,门锁的电池三个月就没电。现在自己部署个优化过的GRU模型,一次性授权费只要几千块,准确率还跟云端的差不多,很多小厂去年的出货量直接翻了一倍。
这个方向我认为根本走不偏——毕竟用户从来不会关心你用的是GRU还是Transformer,他们只关心车机的唤醒够不够快,AR眼镜的续航够不够长,门锁的电池能不能撑半年。
那些当年在知乎上写“GRU已经过时了”的技术大V,现在会不会偷偷把自己的简历上的“大模型架构师”头衔,改成“端侧GRU优化专家”?
作者|大讲堂
排版|大讲堂
审核|知知