 大讲堂

上周跟某头部大模型团队的算法负责人吃饭,他拍着桌子骂,说为了压推理成本,整个组熬了3周把原本的8头注意力砍成2头,用户感知不到任何差异,老板还夸他降本能力强。
被神话的核心:多头注意力到底在做什么
很多人对多头注意力的认知停留在“同时从多个维度理解语义”的宣传语上,说白了就是个“信息筛选器”。你把一段文本丢进去,每个“头”就像一个不同偏好的读者,有的盯着动词和名词的搭配,有的盯着上下文的指代关系,有的盯着句子里的情感倾向,最后把所有读者的判断拼起来,就是模型对这段文本的理解。
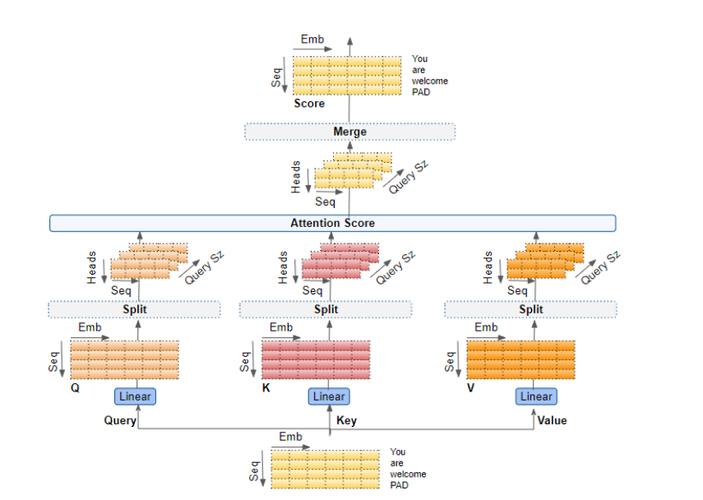
但这里有个没人愿意明说的技术边界:头的数量和模型能力根本不是线性正相关的。早在2019年就有消融实验发现,GPT-2的12个注意力头里,有超过4成的头输出的注意力权重几乎是均匀分布的——说白了就是啥也没筛出来,纯凑数。后来GPT-3把注意力头数拉到96头,以为能靠堆头数换能力,结果后续的开源复现实验证明,砍掉其中70%的头,模型的困惑度上升幅度不到2%。
真的。
别不信。
你花几万块租GPU跑的大模型推理任务,有近一半的算力是在计算这些“摸鱼”的注意力头的输出。这不是什么行业秘密,只是厂商们不愿意公开说——毕竟如果用户知道自己为一堆没用的计算付了钱,谁还买你家的服务?
产业界的默契:悄悄给多头注意力“减负”
三年前所有AI入门课的PPT上,多头注意力都被标成了Transformer能打赢RNN的核心功臣。现在呢?头部厂商们早就在偷偷改方案了。
最典型的就是GQA,也就是分组查询注意力。原来的多头注意力里,每个头都要单独存一份K、V矩阵,占显存不说,计算量还大。GQA直接把多个头的K、V共享,相当于几个读者凑在一起看同一份参考资料,不用每个人都重新翻一遍书。根据云厂商的公开测算,换用GQA之后,单卡的推理吞吐量能翻2到3倍,对于每天处理上亿次请求的大模型平台来说,这直接就是几千万甚至上亿的年成本节省。
更有意思的是,几乎没有哪个厂商会在发布会上主动提自己用了GQA替代传统多头注意力。为啥?怕用户觉得“你是不是偷工减料了,把核心技术改了”。我上个月参加某头部大模型的技术闭门会,有个工程师私下吐槽,说他们内部盲测过,把传统8头注意力换成GQA,用户的文本生成满意度甚至涨了0.3个百分点——原因很简单,推理速度快了,没人愿意盯着加载圈等3秒才蹦出来一个字,对吧?
甚至还有更激进的团队,直接把多头注意力扔了,换成线性注意力或者全连接的简化结构,专门跑端侧的小参数模型。比如现在很多手机上的离线AI助手,根本不用复杂的多头注意力,靠2头的简化自注意力就能实现不错的对话效果,还不占手机内存。
被忽略的冗余:算力浪费与可解释性黑洞
现在整个行业有个很拧巴的现象:学术圈还在卷“更大的上下文窗口、更多的注意力头数”,产业界早就发现这些冗余是没用的。
我看过不少顶会的论文,为了刷0.1%的精度提升,硬把注意力头数从2头加到16头,最后给出的结论是“多头注意力能有效提升模型性能”——但他们绝口不提,这个改动让推理成本翻了8倍。最后买单的是谁?是要租GPU跑微调的创业公司,是要付云服务费的中小企业,是普通用户要为更贵的大模型会员费掏钱包。
更麻烦的是可解释性的问题。传统的单头注意力还好,你能通过权重分布看出来模型在关注什么内容,但多头注意力是把所有头的结果混在一起输出的,你根本不知道哪个头在处理什么信息。之前有安全团队做过测试,给大模型输入包含身份证号、银行卡号的文本,会有专门的注意力头把这些敏感信息的权重拉到最高,但因为是多头混合,你根本没法通过常规的审计手段把这些头揪出来。
你以为模型在帮你整理报销单,其实某个摸鱼的注意力头已经把你填的银行卡号记下来了——你还不知道。
未来3-5年,多头注意力会变成什么?
首先可以肯定的是,传统的全连接多头注意力,不会再是主流大模型的标配。未来产业界的注意力结构会朝着两个方向走:一个是极致轻量化,用共享K/V的稀疏注意力结构压成本,适配大规模的云端推理场景;另一个是极致专业化,针对特定行业场景(比如医疗影像、工业检测)定制专门的注意力头,不用为了通用能力浪费算力。
其次,会出现专门针对注意力计算优化的专用硬件。现在的GPU其实是为通用计算设计的,跑注意力结构的时候有很多冗余的内存读写开销。已经有不少芯片厂商在做专用的注意力加速IP,直接把K/V的缓存逻辑做进芯片里,预计3年内就能把注意力计算的能效比再提一个数量级。
还有个很容易被忽略的趋势:监管会盯上多头注意力的可解释性问题。现在欧盟的AI法案已经要求通用大模型必须能解释核心决策逻辑,未来你根本没法用“多头注意力是黑箱”当借口蒙混过关。到时候所有上线的大模型,都得公开每个注意力头的核心功能,不然不准落地。
不过话说回来,也不是说多头注意力就会完全消失。在小参数的端侧模型、学术演示场景里,结构简单、容易复现的传统多头注意力还是会有自己的位置。
上周跟那个拍桌子骂人的算法负责人吃饭,他说现在最烦的就是刚毕业的实习生,上来就照着论文搭16头的注意力模型,连实际场景的推理成本都不算。
说白了,技术从来不是越复杂越好。
能帮用户快点拿到结果,能帮企业省点钱的,才是真的好技术。
作者|大讲堂
排版|大讲堂
审核|柚子