 大讲堂

2026年3月17号,我手机里那个全是电商运营的微信群,从早上9点炸到凌晨2点。
有人晒后台截图。卖手工编织婴儿小袜子的,被系统自动归成了“工业防护手套”;卖宠物烘干箱的,被划进了“工业恒温设备”类目;做鲜切花批发的,直接被打上了“园林绿化工程物料”的标签。我当时在群里翻了200多条消息,就看到一个做宠物用品的商家说,他那一周的自然搜索流量直接跌到之前的4%,相当于开在核心商圈的门店,被物业没打招呼把招牌换成了废品站的指引牌,路过的人要么绕路,要么进来骂两句就走。
据杭州余杭区电商服务商协会的不完全统计,那次事件里有超过1.2万中小商家的7天搜索曝光量跌幅超过70%,整体损失的GMV相当于整个余杭区2025年第一季度直播电商总规模的1/3。
说实话,我第一反应不是觉得抖音的技术烂。是这帮人真敢啊。
之前行业里的共识是,不管什么新系统上线,至少要拿5%的流量做灰度测试,找几百个商家做内测,有问题及时回滚。结果抖音倒好,直接把全平台12亿存量商品的标签全扔给全量无监督学习的自动归类模型,连个基础的人工校验闸口都没加,就全量推了。
为什么敢?因为算过账。
之前的人工打标,每个标签的平均标注成本是8厘钱,全平台12亿商品打一遍标签要花近10个亿,还得养个几千人的常年标注团队,年运维成本两个多亿。现在用无监督学习跑,一次性算力成本是1200万,后续每个月的算力开销才30万,算下来第一年就能省9个多亿。这个成本差,相当于你花100块钱买了个扫地机器人,就把每个月花3000块请的住家保姆给开了——哪怕这机器人偶尔会把猫砂扫到餐桌上,账面上也是血赚。
哦对了,那次事件之后,抖音给每个受影响的商家发了1000块的流量券当补偿。1000块换商家一周十几万的GMV损失,说好听点是公关安抚,说难听点就是打发叫花子。但没人真的去闹。毕竟平台的规则摆在那,你要是不想玩,自然有别的商家挤进来占你的位置。
无监督学习的本质,从来不是算法突破,是数据所有权的抢滩
好多科技媒体当时写这事,说这是无监督学习技术的里程碑式落地,是算法迭代带来的效率革命。我看了只觉得好笑。
无监督学习的本质,从来不是什么自编码器、对比学习这些算法框架的突破,是整个行业终于摸透了一个逻辑:只要你手里有足够多的、没有被标注过的、真实场景下的行为数据,根本不需要花大价钱做人工标注,模型自己就能摸清楚所有的分类规律。
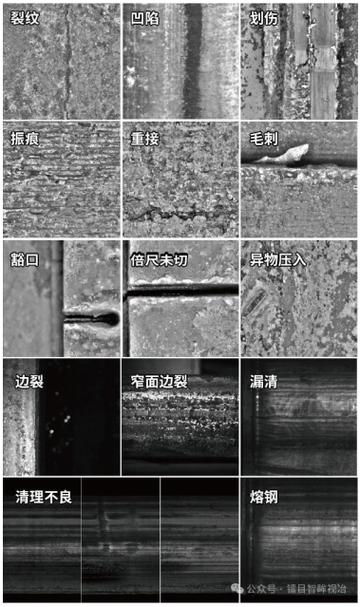
我去年在山东济南跟创新奇智的技术团队聊过,他们给当地的大型钢铁厂做表面质检系统。最早用监督学习的路径,团队花了6个月时间,收集了10万张有表面缺陷的钢板照片,找标注员把每一处划痕、凹坑、锈迹都标出来,喂给模型训练,最后缺陷检出率做到92%,整个项目花了2000多万。后来他们换了无监督学习的路径,根本不用收集有缺陷的照片——只需要把钢铁厂过去3年生产的所有正常钢板的图像数据喂进去,让模型自己学习“一块合格钢板的像素分布是什么样”,但凡和这个分布有偏差的区域,就自动标记成异常点。这个项目最后只跑了2个月,总成本300万,缺陷检出率反而做到了96%。
说个跨行业的比方。之前的监督学习,就像古代的兵法教材,要把所有的战例、阵型、地形应对方法全整理好,一条一条教给新兵,新兵背熟了才能上战场。但无监督学习是什么?是把新兵直接扔到原始丛林里,让他自己摸清楚什么果子能吃,什么动静是老虎来了,什么地方下完雨会涨水——根本不需要教官把所有的生存规则一条一条写下来。
这种路径的变化,直接掀了之前整个数据标注行业的桌子。2024年国内数据标注市场的规模快摸到100亿,贵州、河南好多县城靠建标注产业园解决了几万人的就业。结果无监督学习的场景一落地,这些标注公司的订单直接砍了快一半。我去年跟贵州一家头部标注公司的老板吃饭,他还拍着桌子说数据标注是未来十年的黄金赛道,只要大模型还在迭代,他们的生意就不会差。结果今年再发微信,人家已经转行去做AI生成内容的版权确权了。
说白了,之前的产业链利润分配里,标注公司靠“加工数据”赚走了大头,现在掌握海量原始数据的平台,直接把这部分利润全吃了。抖音敢在生产环境直接跑无监督模型,根本不是因为技术有多成熟,是因为他们手里握着全平台的用户行为数据——什么商品被用户点了,什么商品被加购了,什么商品被退货了,这些真实的行为反馈,比人工写的标签准10倍都不止。人工标注员哪知道,一个卖“老北京布鞋”的链接,80%的点击用户是给家里70岁以上的老人买的,不是追求国风的年轻人。模型自己从行为数据里摸出来的这个关联,比任何人工标注都靠谱。
被卷到的,根本不是算法工程师
现在行业里聊无监督学习,总觉得这是算法工程师的狂欢——要学新的框架,要跑新的实验,要追最新的论文方向。但实际落地了才发现,最先被卷到的,根本不是写代码的人。
最先被冲垮的,是那300万靠数据标注吃饭的从业者。之前这些人的主力是三四线城市的宝妈、兼职的大学生、县城里的闲散劳动力,靠给图片画框、给文本打标签,每个月能赚个两三千块,够补贴家用。现在无监督模型跑起来,这部分的标注需求每年都在以30%的速度往下掉。我之前认识的一个贵州的标注团队负责人,2024年还养着200多个标注员,2025年底就裁到只剩20个人,剩下的人主要做模型的错误校验,根本不需要做全量的标注工作。
紧跟着被冲击的,是做传统企业SaaS的公司。之前这些公司靠给企业做客户分类、员工画像、内容标签体系,一年能收企业几十万的服务费。现在企业只要把过去5年的客户行为数据、内部运营数据扔给无监督模型,模型自己就能把客户分成十几个细分群体,自动识别高价值客户、流失风险客户,根本不需要SaaS公司来做定制化的标签体系。之前一年几十万的服务费,现在可能花几万块买个API调用就搞定了。我去年接触的一家做零售SaaS的公司,之前靠给连锁超市做商品分类标签,一年能做3000万的营收,2025年这块业务直接跌了60%,现在全公司都在转做AI模型的落地咨询。
还有像抖音上那些中小商家,他们才是最直接的承压者。无监督学习的模型是没有“社会常识”的,它只知道数据的分布相似度,不知道不同商品的用户群体差了十万八千里。比如模型看到“猫条”的文本特征和“实验动物饲料”的文本特征有70%的相似度,就直接归成一类了,根本不知道这俩东西的买家一个是养猫的年轻人,一个是做生物实验的科研人员。
好多人说无监督学习会带来下一次技术革命,会让大模型更聪明,会把整个社会的效率拉到新的高度。我倒觉得,先别扯那么远。
现在所有人都在算无监督学习能省多少成本,能赚多少利润,能抢多少市场份额。可没人停下来问一句——三年之后,当你刷到的所有内容、买东西看到的所有分类、找工作匹配的所有岗位,全是无监督模型自动给你贴的标签,你会不会突然反应过来:从一开始,我们就不是这个系统的用户,只是它用来训练的原料而已?
作者|大讲堂
排版|大讲堂
审核|小北