2026-10-13 15:31:05 作者:大讲堂
老陈把冰美式放在工作台边缘的时候,实验室的电子屏突然跳出来一行字:第1247次人类行为测试,请求启动。
这是2032年的中关村,后厂村的路已经拓宽到八车道,写字楼里每十个面试官里,有八个把初筛交给AI做。老陈做了十五年测试,前十四年测软件,测AI模型,最后一年,开始测人。
机房里永远等不到“通过”的测试
 AI人类行为评估测试实验室机房
老陈的工位在机房走廊尽头,靠窗,窗户外能看到对面互联网公司新楼的顶,玻璃反光晃得他每天下午都要拉窗帘。他做的这套系统,是给企业招聘用的,从校招到社招,所有候选人在线做完三百道题,再录十分钟随机行为视频,AI就能给你打出从执行力到亲和力一共十二个维度的分,HR只需要从得分前10%里挑人就行。
说实话,这套系统卖得真好。去年一年签了七十多家公司,光年终奖老陈就拿了六个月工资。
他女儿林林去年毕业,找工作,面到最后一轮,HR说,先走个我们的标准测试吧。
林林考完,得分出来,总体评级B+,卡在进终面的线外面一分。
太讽刺了。
老陈那天盯着系统后台女儿的测试报告,手指放在重新计算的按钮上,停了十分钟,没按。规则是他自己写的,他知道只要改三个权重参数,女儿的得分就能升到A,可他下不去手。所有写规则的人,都最清楚规则里藏着多少没说出口的猫腻。
谁来测试测试本身?
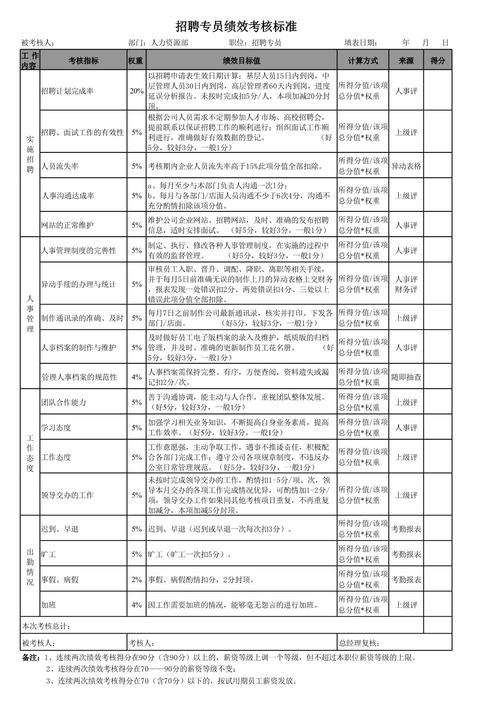 AI招聘能力测试得分权重分布表格
不过话说回来,这套系统刚上线的时候,全公司都夸准,说比招十个资深HR筛人效率还高,准确率还高。那时候没人问,准的标准是什么?
是招进来的人两年内不离职就算准?还是能帮公司赚够钱就算准?老陈一开始也觉得,不就是个筛选工具嘛,省得HR一个个看简历累,哪来那么多废话。
直到林林这事出来,他翻了后台一百多份被系统淘汰的候选人报告,才看出不对。
小镇出来的孩子,说话习惯留三分余地,AI识别到语气词多,直接判定“决策力不足”;戴框架眼镜,笑的时候喜欢低头,AI判定“亲和力不足,不适合对接客户”;甚至有人简历里写了喜欢骑行,每周骑一百公里,系统居然关联到“精力分散,不稳定,无法接受高强度加班”。
这些关联规则,都是当初从头部公司的HR那里调研来的。说白了,就是把过去HR挑人的潜规则,换成了代码写进系统里,再包装成“客观智能测试”的牌子卖出去。
你说它不对吧,它确实符合很多公司老板的喜好。你说它对吧,那一个个好苗子,就因为几个预设的标签,直接刷掉,太冤了。
老陈那时候天天泡在后台调数据,他发现系统对女性候选人的要求,天生比男性高五个百分点,因为训练集里,当前在职的中层管理者,七成都是男性,系统学走了这个规律,就默认女性“领导力”天生低一点。
破不了吗?说实话,破不了。只要训练集本身带着偏见,测试出来的结果就不可能不带偏见。你就算调了权重,改了参数,换了数据集,只要定标准的还是那帮人,就一定会有新的偏见出来。
屏幕暗下来之后,剩下的是什么
 屏幕暗下来之后,剩下的是什么
老陈去年年底从公司离职了,不是因为女儿的事,是公司要把这套系统卖给金融机构做贷款风控,测贷款人的“还款意愿”,说白了就是通过你的社交数据给你打个分,决定给不给你放贷。老陈不同意,吵了一架,走了。
他现在在一家小的创业工作室,帮几个年轻小孩做产品,再也不碰人类测试的项目了。偶尔有朋友开公司找他要之前那套系统的渠道,他都摇头,说你别用那玩意儿,你招人的话,坐下来跟人喝一杯茶,聊半小时,比什么破测试都准。
我上周找他喝咖啡,他掏出来一个旧笔记本,上面记着他这大半年攒的几十个被AI测试刷掉的年轻人的联系方式,已经给七个人介绍到了靠谱的工作,其中有三个过了试用期,老板说比之前招的那些高分的好用多了。
他说,现在什么都要测,你买个保险要测你的健康风险,你找对象要测你的匹配度,连你去幼儿园接孩子,都要测你是不是符合“合格家长”的标准,我们这一辈子,从出生的Apgar评分,到临死前的生存率测试,好像活着就是一场接一场的测试,每一场都要给你打个分,分高就是合格的人,分低就是没用的人。
可测试是死的,人是活的啊。
我抬头看窗外,后厂村的车来来往往,写字楼的户外屏上滚动着招聘广告,上面大大的字写着“AI智能初筛,公平客观,一秒出结果”。
老陈把杯里剩下的冰美式一口喝干,笑了笑,说你看着吧,再过些年,大家就会明白,最测不准的,就是人。
没有人能给人打分。也没有人配。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:当AI开始测试人类:中关村实验室里的测试悖论
文章链接:https://lfdjt.com/info_23_25592.html
 大讲堂
