 大讲堂

今年跑了五家持牌消费金融公司,聊下来发现大家都在抢同一件事——把原来的多因子风控体系,往金融大模型上迁。
风控这个行当,这么多年玩来玩去,核心从来都是:谁能把风险归因说清楚,谁就能赚到更低坏账的钱。原来的玩法不行了,才轮到新方案上场。
传统多因子风控的死结
说白了,传统多因子风控就是堆变量。把人行征信记录、多头借贷次数、还款历史、消费数据这些一堆因子丢进逻辑回归模型,算出来一个违约概率,再给每一个因子算一个贡献度,就完成了归因。
坑真的很多。
第一个坑,归因只能停留在表面,说不清楚因果。比如一个年轻人最近三个月换了三个住址,传统静态模型直接会打一个高风险标签,但你根本分不清楚他是刚毕业换租房,还是频繁跳槽躲债,甚至是帮黑产走账换收款网点?归因到“住址变更”这个因子,等于没说。
第二个坑,非结构化数据全浪费了。用户的通话记录文本、电商购物评论、APP行为日志这些信息,传统多因子根本没法提炼成有效因子,只能弃用,平白丢了好多风险信号。
第三个坑,迭代太慢。传统因子三五个月更一次,黑产的骗贷手法几个星期就换一轮,等你调完参数,坏账已经出来了。
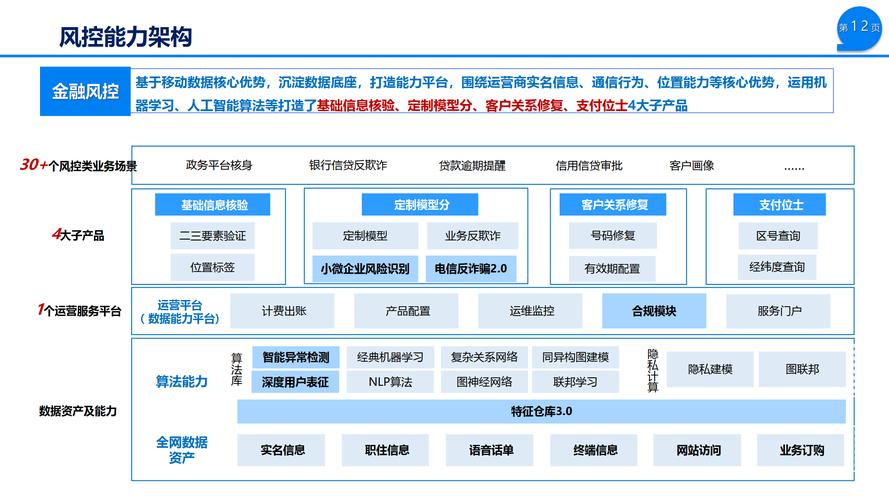
金融大模型多因子风控归因的核心:把黑箱掰成透明的
很多人一听大模型就觉得是黑箱,没法做金融风控——毕竟监管要求你必须说清楚,为什么给用户拒贷,不能扔出来一个“模型说你风险高”就完事。
现在跑通的玩法,根本不是让大模型直接做风控决策,而是用大模型补传统多因子的短板,归因逻辑是分层走的。
第一层,大模型负责挖隐性因子。把所有非结构化数据喂进去,大模型从里面提炼出原来传统模型挖不出来的新因子,比如从用户的购物记录里提炼出“刚需支出占比”“消费波动幅度”,从出行记录里提炼出“跨城流动频率”,这些都是原来没有的新风险信号。
第二层,分层归因,每一步都可追溯。先算哪一类大类因子(征信类、行为类、文本类)贡献了多少风险权重,再具体到某一笔申请,把归因链条拉出来:不是因为你总分期,是因为你最近三个月所有到账资金都在24小时内转到了高风险体育博彩平台,所以拒贷。每一步都能说清楚,监管挑不出毛病。
说实话,头部银行的金融科技子公司已经把单户归因的响应时间压到了100毫秒以内,跑一次全量多因子更新的时间,从原来的一周变成了现在的隔夜,效率提升不是一点半点。
不过话说回来,技术边界也很清楚。大模型生成的隐性因子很容易带训练数据的偏差,比如训练数据里把低线城市用户默认为更高风险,那归因出来的结果天然就有歧视,这个问题到现在也没有完美的解决方案。
落地难,卡在两座大山
现在行业的现状是,所有人都盯着这块蛋糕,但真能落地跑起来的,不超过十家。核心就是卡了两个问题。
第一是合规墙。监管要求所有风控模型必须可解释,你大模型生成的隐性因子,怎么证明它没有性别歧视、地域歧视?去年南方某城商行内测大模型风控,就被监管要求整改,原因就是无法说清楚新因子的合规性。现在所有机构都在等监管出明确的规则,没人敢先大规模上线。
第二是成本墙。能支撑全量多因子实时归因的金融大模型,参数规模至少是百亿级,每天几百万笔查询跑下来,一个月光算力成本就要大几百万,中小银行、城商行根本扛不起这个费用。现在也就头部持牌消费金融、国有大行能玩得起。
还有团队的问题。原来的风控团队都是玩逻辑回归、传统机器学习的,对大模型的归因逻辑不熟悉,转型也要一两年的时间。
产业链现在已经慢慢分出格局了:头部互联网科技公司做通用金融大模型基座,给中小机构输出API按调用量收费;垂直金融科技公司深耕细分场景,比如专门做车贷、经营贷的多因子归因,抢细分市场;小公司就做点数据标注、因子清洗的边角活。
当然还有不能不提的伦理风险:有些机构为了提升准确率,偷偷拿用户的社交关系、医疗数据挖因子,归因准是准了,但踩了隐私红线,去年已经有好几家因此被罚了。
未来三年的判断
第一,传统多因子不会被淘汰,未来很长时间都是传统模型加金融大模型的混合架构,大模型负责挖新因子做归因补充,传统模型做最终决策,兼顾准确率和可解释性。谁要是告诉你他已经全栈替换了传统模型,十有八九是出来割韭菜的!
第二,合规标准会很快落地,监管肯定会出台金融大模型风控归因的测试规范,哪些因子能用,偏差怎么测,黑箱怎么透明化,都会有明确的要求,之后才会迎来大规模落地的潮。
第三,中小机构会走云化路线,不会自己建大模型,直接买头部厂商的归因服务就行,按笔付费,成本降下来,才能普惠。
最后说一句,风控这个行当,从来都是技术跟着监管和需求走,原来的方案解决不了现在的问题,新方案才会起来。金融大模型多因子风控归因,本质上就是解决“准”和“可解释”的老矛盾,方向对不对?对。能不能成?还要等规则落地,还要看成本能不能打下来。
作者|大讲堂
排版|大讲堂
审核|阿辰