2026-10-02 16:26:02 作者:大讲堂
当国内个人信息保护法正式落地,欧盟GDPR的千万欧元罚款单一张接一张开出来。原来AI行业那条“先攒数据再训练,有了数据才能做大”的老路,走不通了。
你手里有数据不敢拿出来用,我手里有数据想合起来训模型,双方隔着合规红线握手都不敢。这不就是最近这些年AI产业最大的悖论之一吗?
联邦学习就是冲着这个问题来的。
联邦学习到底是什么?真能解决数据孤岛问题?
很多人一听到“联邦”两个字就觉得玄乎,其实核心逻辑一句话就能说透:数据不动,模型动。
原来的AI训练是什么样?把所有参与方的原始数据全都传到同一个中心服务器,清洗、标注、训练,一条龙走完。可现在这个模式在隐私监管面前,就是裸奔。
联邦学习反过来,每个参与方把自己的数据存在本地,只把训练出来的模型参数或者梯度传出去,做聚合更新,来回几轮之后,大家就能一起得到一个效果更好的模型,全程没有一方能拿到别人的原始数据。
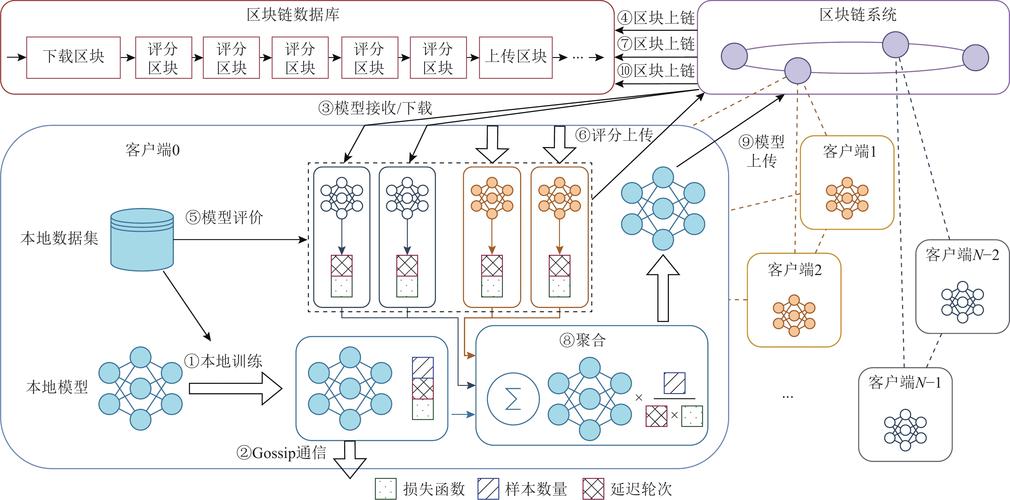 横向联邦学习训练流程示意图
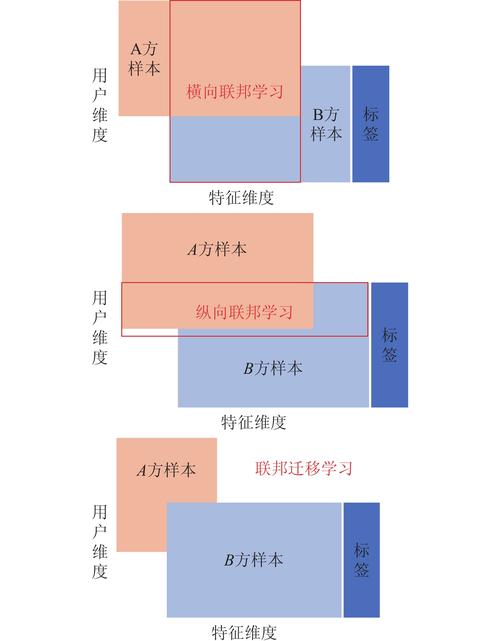
它不是只有一种玩法,常见的分三类。横向联邦,是不同机构有同类型不同样本,比如两个不同省份的城商行,用户都是借贷客户,都有风控数据,样本不重叠,合起来训模型。纵向联邦,是同个用户群体,不同机构有不同维度的数据,比如银行有用户的资金流数据,电商有用户的消费数据,用户重合度很高,合起来训模型能更准。还有联邦迁移学习,针对双方样本重叠度很低,数据维度也不一样的场景,适合跨界合作。
很多人会问,那它和差分隐私、同态加密这些隐私计算技术是什么关系?说实话,联邦学习更偏向于一种分布式训练的框架,很多时候会把这些加密技术打包进去用,它本身不是为了完全灭绝隐私风险,只是在数据可用不可见这个需求上,找到了一个性能和安全的平衡点。
产业落地:哪些场景已经跑通了?
最先用起来的,肯定是对数据合规要求最高、对模型精度提升需求最迫切的行业——金融。
国内已经有不少股份制银行在用联邦学习做联合风控。和第三方消费机构合作建模,银行不用拿用户的原始消费数据,机构不用拿用户的信贷数据,双方联合训出来的反欺诈模型,AUC比银行单家建模能高出5到8个点,坏账率能降好几个百分点,还完全合规。
然后是医疗。多家三甲医院联合训练肺癌影像诊断模型,每个医院的影像数据都不用出本院的防火墙,攒出来的训练样本量翻了好几倍,模型诊断准确率比单家医院训的高了10%以上,这个要是放在以前,根本不可能——谁也不敢把患者的病历影像随便往外传。
 联邦学习医疗影像联合建模场景图
还有互联网广告行业。媒体有流量数据,广告主有转化数据,以前双方为了数据安全都不肯把原始数据开放,现在用联邦学习一起训点击率预估模型,投放ROI能涨两成左右,已经有头部互联网公司在核心广告业务全线用了。
不过话说回来,现在联邦学习还没到大规模普及的地步。绝大多数落地项目都是头部机构的试点,真正把核心业务全搬上去的没多少。产业链上的玩家,主要是大厂的云服务部门,还有少数几家垂直创业公司,整个市场还在培育期。
藏在光鲜下的坎:没人愿意说的落地障碍
第一个坎就是成本。联邦学习是分布式训练,模型参数要在各个参与方之间来回传,通信开销比集中式训练高好几倍。要是训一个十亿参数级别的大模型,这个成本很多中小机构根本承受不起。
第二个坎是性能。哪怕优化做得再好,联邦学习因为加入了隐私保护的扰动,模型精度多多少少会比集中式训练降一点。对精度要求极高的场景,比如自动驾驶的感知模型,这个损耗现在还是没法接受。
第三个坎是安全不是绝对的。最近两三年,已经有不下十篇研究论文证明,就算是加密过的梯度,也能通过算法反推出来原始训练数据,大模型参数越多,这个泄露风险越高。很多企业说自己用了联邦学习就绝对安全,本质上就是营销话术。
还有一个很现实的问题,标准不统一。各家做的联邦学习框架互不兼容,你用A家的平台,我用B家的,要合作就得重新做适配,成本一下子就上去了,很多跨行业合作就是卡在这一步,最后不了了之。
说实话,很多现在上线的联邦学习项目,更多是为了符合监管要求的“面子工程”,真的要产生足够的业务收益,还有很长的路要走。
未来三年:联邦学习会往哪走?
 未来三年:联邦学习会往哪走?
第一个明确的方向就是联邦大模型。现在大模型火了,每家行业机构都有自己的私有行业数据,但是谁也不愿意把数据拿出去给别人训大模型。联邦学习刚好解决这个问题,多家机构一起训一个行业专属大模型,数据都留在本地,效果比通用大模型好太多,这个方向已经有不少大厂在做试点了。
第二个,监管会推着联邦学习往前走。现在隐私监管的口径越来越严,凡是需要跨机构合作使用数据的场景,合规成本越来越高,联邦学习是目前所有“数据可用不可见”方案里,最成熟、性能最好的一个,越来越多的企业会把它当成首选方案,而不是可选方案。
但是我得说,联邦学习永远不会取代集中式AI。它就是一个补位的技术,只解决那些“数据不能出域,必须联合训练”的场景,大部分能合法集中数据的场景,集中式训练还是比联邦学习好用又便宜。
未来三年,联邦学习会从现在的试点项目,慢慢渗透到金融、医疗、政务这些强监管行业的核心业务,市场规模会翻好几倍,但不会出现爆发式的增长。它是一步一个脚印走出来的技术,不是一夜就能改变AI产业的神话。
你看,AI产业走到今天,早就过了只要有数据就能躺赢的阶段。接下来拼的,就是谁能在合规的框架下,把数据的价值挖出来。联邦学习踩中了这个最大的刚需,能不能长成参天大树,就看产业界能不能把那几个坎慢慢迈过去了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:联邦学习:数据隐私铁笼下,AI产业的破局新路
文章链接:https://lfdjt.com/info_23_23630.html
 大讲堂
