 大讲堂

2026年端侧大模型的吵架现场
今年春天小米发布15Ultra的时候,发布会没怎么刻意提,可有人拆完模型结构发现,端侧运行的7B参数小爱大模型,时序编码层用的不是现在主流的FlashAttention,改了GRU的定制变体。
一下子炸锅了。
论坛里吵翻了天,有人骂小米抠门省成本疯了,拿十年前的老技术出来骗消费者。有人回怼,你行你上,12GB内存跑全尺寸Transformer,开个微信就要杀后台,你用啊?说实话,我当时看到这个新闻,一口茶差点喷出来。五年前被Transformer摁在地上摩擦的GRU,居然现在杀回了核心位置。
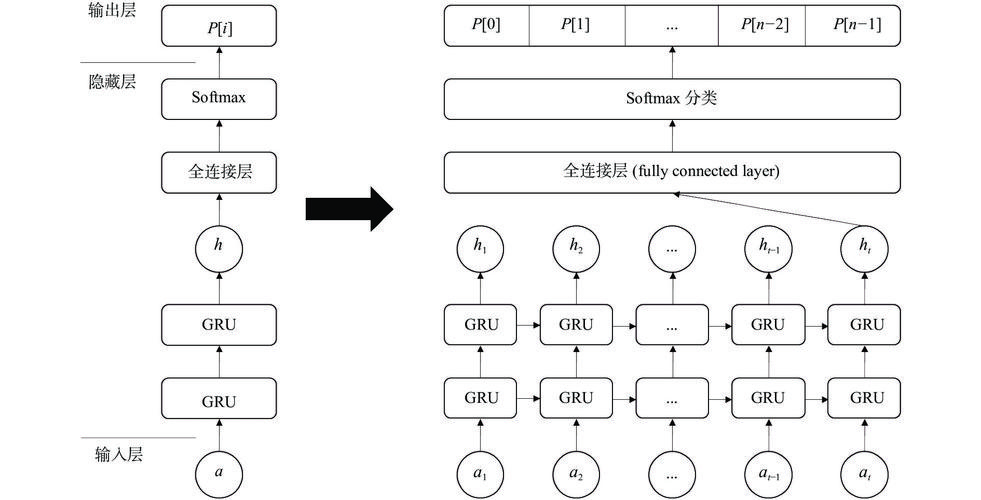
你去翻2017年Transformer刚出来的论文,哪篇不是把RNN、LSTM、GRU踩得一无是处?说并行计算差,长序列记忆丢得快,早该进人工智能博物馆了。这快十年过去,风水转得比A股赛道还快。当大模型从云服务器沉到手机、车机、家用智能摄像头,所有问题的前提都变了。
云里不在乎多占几张A100卡,端侧在乎每1MB内存、每1毫瓦功耗。我上个月跟某头部手机厂的算法总监吃饭,他说现在端侧大模型的内卷,已经卷到按「每MB内存」算KPI了。少占10MB,就能多给用户存两张手机照片,这就是实打实的用户体验,就是实打实的卖点。GRU在这里,刚好踩中了所有痛点。
它参数少,计算快,不用每次都重新算整个序列的全注意力,天生就是给吃紧的算力腾地方的。对吧?跑端侧7B大模型的时候,相同生成速度下,GRU架构比纯Transformer少占1.2GB内存,能让12GB内存的手机多开3个日常后台APP,这就是用户能摸得到的差异。
老技术翻红的底层,是本土化落地的博弈
其实GRU从来没死过,只是不在顶会论文的聚光灯下而已。国内做自动驾驶芯片的地平线,早就在征程5芯片上用GRU做BEV时序特征融合了。我之前拿到过他们内部的测试数据,相同的感知精度下,GRU模块的算力占用只有纯Transformer时序层的18%,相当于把一块成本1000元的车载芯片,硬生生榨出了1200元芯片的性能,这里省下来的,就是整车厂大几千块的BOM成本差,十几万的家用车就能多赚小一万的利润,这从来不是小事。
比当年的LSTM,GRU又少了30%的参数,跑同样的时序任务,功耗还能再降25%,相当于车机芯片连续运行4小时,能省出一块车载中控屏半小时的用电量,你说香不香?
这里很多人都搞错了,技术迭代从来不是你死我活的侏罗纪公园式淘汰赛,更像即时零售的全渠道布局——Transformer就像是远在郊区的城市大仓,货全容量大,适合处理大批次全量数据,调货一次费点劲也没关系;而GRU就是开在你小区门口的前置仓,只存你高频用的那批货,拿了就能走,速度快还不占市中心的黄金地皮,这么说是不是一下子就通透了?
国内企业为什么比海外科技公司更愿意挖GRU这种老技术出来用?说白了,我们的产业链下游,要的不是顶会论文的最优SOTA指标,是能出货、能降本、能赚钱的落地方案。OpenAI玩千亿参数云模型,人家赚token的钱,当然可以堆Transformer堆算力。我们做端侧做车载做消费级智能硬件,要卖给普通消费者,你把方案成本堆上去,终端售价涨几千,消费者用脚投票不买,你论文发得再漂亮有什么用?
我去年接触过一家深圳宝安的智能摄像头厂商,他们做人脸移动追踪,全程用GRU做时序跟踪,比用Transformer方案,单颗芯片成本便宜8块钱,一年出1000万台,就是足足8000万的净利润。这个方向我认为走不偏,反而很多天天追最新风口的团队,走偏了。为了涨一两个点的测试集准确率,把方案成本翻一倍,最后落不了地,只能拿出去骗融资。
被技术风口抛弃的人,反而捡到了枪
这件事最有意思的地方,其实是对普通从业者的影响。五六年前Transformer火透了之后,好多线上算法培训班直接把GRU、LSTM的课程砍了,说这是过时技术,学了找不到工作。好多刚毕业的算法工程师,简历上只敢写Transformer相关项目,提都不提GRU,怕被面试官嫌落伍。
现在呢?我身边好多个做互联网行业的猎头,最近半年都在疯狂找会调GRU结构的算法工程师,开的价还比普通Transformer工程师高15%,说白了,会的人太少了,物以稀为贵。原来卷不动大模型Transformer的那帮老算法人,当年做语音识别做时序预测的,手里压箱底的GRU优化经验,现在居然成了抢着要的香饽饽。
我认识一个工作快十年的算法工程师,前几年在一家语音AI创业公司,公司倒闭之后,他本来已经打算转产品经理了,结果今年被某头部新势力车企挖走,就是因为他十年前在诺基亚做语音识别的时候,优化过GRU的低功耗推理,直接给了年薪翻倍的offer。你说找哪说理去?
好多人天天追风口,追GPT,追多模态,追最新SOTA,把所有老技术都当垃圾一样扔了,殊不知产业链落地的需求,从来不是跟着学术风口走的。当整个行业都挤在Transformer这座窄独木桥的时候,没人愿意走的GRU这条小路,现在居然成了更快的捷径。
整个产业链现在都在向下沉,大模型从数据中心往各个终端走,所有原来因为算力不够被打入冷宫的技术,只要能满足低功耗、低内存的要求,都有可能重新翻红。GRU不是第一个,也肯定不是最后一个。
你压箱底那堆被风口淘汰的「过时技术笔记」,会不会就是下一波产业落地的入场券?
作者|大讲堂
排版|大讲堂
审核|乐乐