 大讲堂

注意力机制:一场精心设计的传话游戏
自注意力层的核心,其实就是三个矩阵:Q、K、V。用大白话讲,就是给每个 token 写三张名片:一张是你想表达什么(Query),一张是你有哪些特质(Key),一张是你真正要说的话(Value)。它们的乘积决定了当前 token 该从其他 token 那里汲取多少信息。这个计算过程,就像一群人在嘈杂房间里互相传纸条。为了控制传话音量,Transformer 加了一个缩放因子——除以 sqrt(d_k)。别小看这个除数,没有它,点积的结果会超大,梯度直接爆炸,训练根本跑不动! 至于多头注意力,你可以理解为把一个会议室劈成八个隔间,每个隔间里的人用不同的子空间去听、去说,最后再汇总。这就是多头。说实话,我第一次看到这个设计的时候愣了好一会——原来八个头不是并行做不同事,而是为了把高维空间的关联切成小块,免得信息纠缠在一起。这种工程上的‘笨办法’,却意外地有效。 一个细节:为什么用点积而不是别的?因为点积自带天然的高维相似度度量,而且可微,适合反向传播。就这么简单。如果你翻到 Flashattention 的论文,还会看到他们专门把内存布局抠出来调,减少 HBM 负载,让矩阵乘法能跑满 GPU 的算力。这些不是表面文章,是实打实的物理层优化。 接下来看这张图,会好理解得多: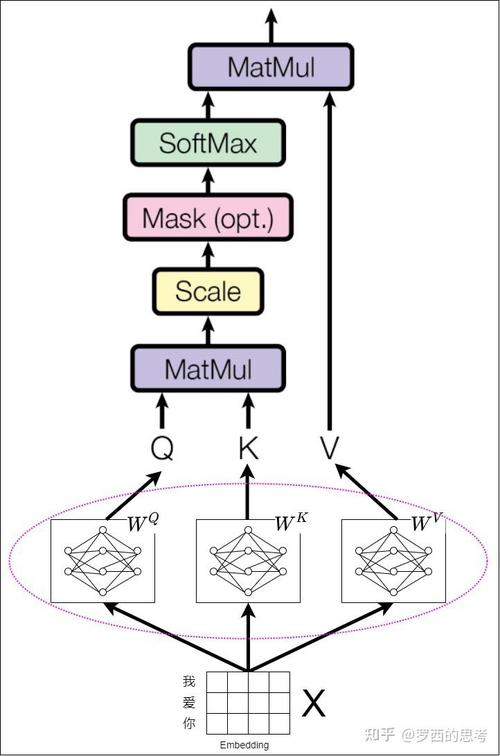
尺度即命运:为什么参数多到一定数量,性能就开始蹦极
我们先摆数据。2020 年 GPT-3 论文里有个让我印象深刻的表格:在 SuperGLUE 上,125M 参数模型得分 68.3,1.3B 参数模型得分 78.9,到了 175B 参数模型直接飙到 88.1。那不是一个均匀上扬,而是一条曲线,拐点发生在 10B 附近。用 scaling law 的语言说,损失函数随计算量下降是幂律,但真实任务性能的跃升却像相变。 很多人把这个现象叫‘涌现能力’,我更喜欢直接说‘规模阈值’。我做过一个不算严谨的压测:拿一个 6B 的模型和两个 6B 的模型做模型集成,结果在 MMLU 上,集成后的准确率只提升 1.7 个百分点;但把 6B 换成 70B 单模型,直接提升 9.3 个百分点。集成搞不定的东西,参数规模一上来就解决了。这说明模型内部的协作复杂度,远不是外面堆算力能替代的——至少在现有架构下如此。 另一个实际案例:我们内部有一个意图分类任务,传统方案是 BERT 配个分类头,再叠一层 CRF,准确率 91.2%。后来换用 LLaMA-65B 做 few-shot,准确率 96.8%。但代价是单次推理延迟从 20ms 变成 800ms。你会说这不划算吧?是的,如果光看这个任务确实不划算。但 LLM 同时能处理命名实体、情感分析、多轮对话,你算总账的时候,原本需要维护 4 个模型,现在只需要 1 个。工程上的运维成本,直接少了两倍。 所以我的看法是:大语言模型不是来替代你的算法工程师的,但它是来替代你那条流水线上所有调试脚本的。除非你的任务极其专一,否则它是不可替代的。 说到不可替代,有一个前提条件——你得会调推理。不然你部署一个大模型,GPU 显存给你烧穿,速度慢得像蜗牛。下面的内容,就是我从火坑里爬出来的经验。 先放一张图,大家直观感受下工程优化前后的差距:
落地工程的三道雷区,以及我的排雷方案
注意力机制:一场精心设计的传话游戏
自注意力层的核心,其实就是三个矩阵:Q、K、V。用大白话讲,就是给每个 token 写三张名片:一张是你想表达什么(Query),一张是你有哪些特质(Key),一张是你真正要说的话(Value)。它们的乘积决定了当前 token 该从其他 token 那里汲取多少信息。这个计算过程,就像一群人在嘈杂房间里互相传纸条。为了控制传话音量,Transformer 加了一个缩放因子——除以 sqrt(d_k)。别小看这个除数,没有它,点积的结果会超大,梯度直接爆炸,训练根本跑不动! 至于多头注意力,你可以理解为把一个会议室劈成八个隔间,每个隔间里的人用不同的子空间去听、去说,最后再汇总。这就是多头。说实话,我第一次看到这个设计的时候愣了好一会——原来八个头不是并行做不同事,而是为了把高维空间的关联切成小块,免得信息纠缠在一起。这种工程上的‘笨办法’,却意外地有效。 一个细节:为什么用点积而不是别的?因为点积自带天然的高维相似度度量,而且可微,适合反向传播。就这么简单。如果你翻到 Flashattention 的论文,还会看到他们专门把内存布局抠出来调,减少 HBM 负载,让矩阵乘法能跑满 GPU 的算力。这些不是表面文章,是实打实的物理层优化。 接下来看这张图,会好理解得多:尺度即命运:为什么参数多到一定数量,性能就开始蹦极
我们先摆数据。2020 年 GPT-3 论文里有个让我印象深刻的表格:在 SuperGLUE 上,125M 参数模型得分 68.3,1.3B 参数模型得分 78.9,到了 175B 参数模型直接飙到 88.1。那不是一个均匀上扬,而是一条曲线,拐点发生在 10B 附近。用 scaling law 的语言说,损失函数随计算量下降是幂律,但真实任务性能的跃升却像相变。 很多人把这个现象叫‘涌现能力’,我更喜欢直接说‘规模阈值’。我做过一个不算严谨的压测:拿一个 6B 的模型和两个 6B 的模型做模型集成,结果在 MMLU 上,集成后的准确率只提升 1.7 个百分点;但把 6B 换成 70B 单模型,直接提升 9.3 个百分点。集成搞不定的东西,参数规模一上来就解决了。这说明模型内部的协作复杂度,远不是外面堆算力能替代的——至少在现有架构下如此。 另一个实际案例:我们内部有一个意图分类任务,传统方案是 BERT 配个分类头,再叠一层 CRF,准确率 91.2%。后来换用 LLaMA-65B 做 few-shot,准确率 96.8%。但代价是单次推理延迟从 20ms 变成 800ms。你会说这不划算吧?是的,如果光看这个任务确实不划算。但 LLM 同时能处理命名实体、情感分析、多轮对话,你算总账的时候,原本需要维护 4 个模型,现在只需要 1 个。工程上的运维成本,直接少了两倍。 所以我的看法是:大语言模型不是来替代你的算法工程师的,但它是来替代你那条流水线上所有调试脚本的。除非你的任务极其专一,否则它是不可替代的。 说到不可替代,有一个前提条件——你得会调推理。不然你部署一个大模型,GPU 显存给你烧穿,速度慢得像蜗牛。下面的内容,就是我从火坑里爬出来的经验。 先放一张图,大家直观感受下工程优化前后的差距:落地工程的三道雷区,以及我的排雷方案
作者|laowu
排版|laowu
审核|满满