 大讲堂


LangChain底层拆解:性能实测与三大避坑指南
好多人跟我吹LangChain,说它是LLM时代的Spring。我用了一个月,心里却只有一个字:累。倒不是说它不好,而是它的抽象层太厚了,厚到你根本看不清里面发生了什么。今天我就从底层拆解这台“积木机器”,再给你看一组压测数据,最后说说我踩...
好多人跟我吹LangChain,说它是LLM时代的Spring。我用了一个月,心里却只有一个字:累。倒不是说它不好,而是它的抽象层太厚了,厚到你根本看不清里面发生了什么。今天我就从底层拆解这台“积木机器”,再给你看一组压测数据,最后说说我踩...
2025年,如果你还在把大模型当成一个巨大的参数黑盒,那你大概率会死在下一波洗牌里。检索增强生成(RAG)不是技术补丁,它是AI从“背诵机器”进化为“决策引擎”的临界点。 为什么是现在?因为算力红利吃完了,数据红利正在爆发。企业发现自己囤积...
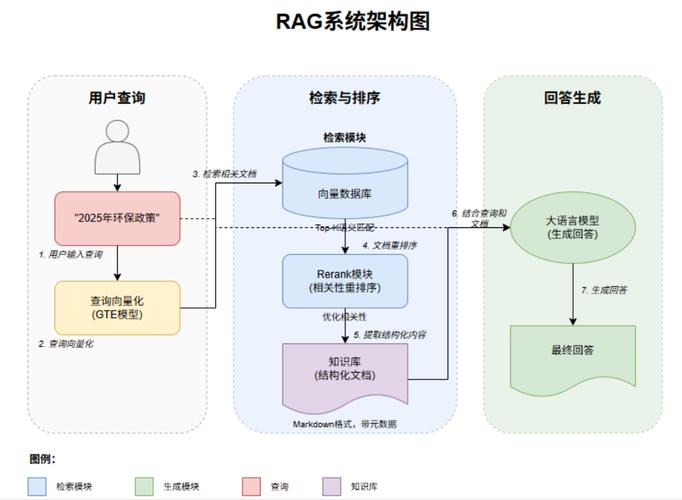
这两年我面试过不少标着“RAG资深”的人。十个里有九个把RAG讲成“向量检索加生成模型”,仿佛把LlamaIndex的代码抄一遍,就掌握了下一代知识管理。我对这种面试者的回答,通常只有一句:那你为什么还要用RAG呢? 好吧,安静一下!这个行...
现在谁还怀疑提示工程是花架子?全球AI算力采购翻了四倍,企业应用落地率却不到三成。卡在哪儿?不是模型笨,是没人会跟它说话。提示词,就是大模型世界里的人话翻译器——你问对了,它就是生产力;你问错了,它就是个昂贵的聊天玩具。 说实话,我以前也看...
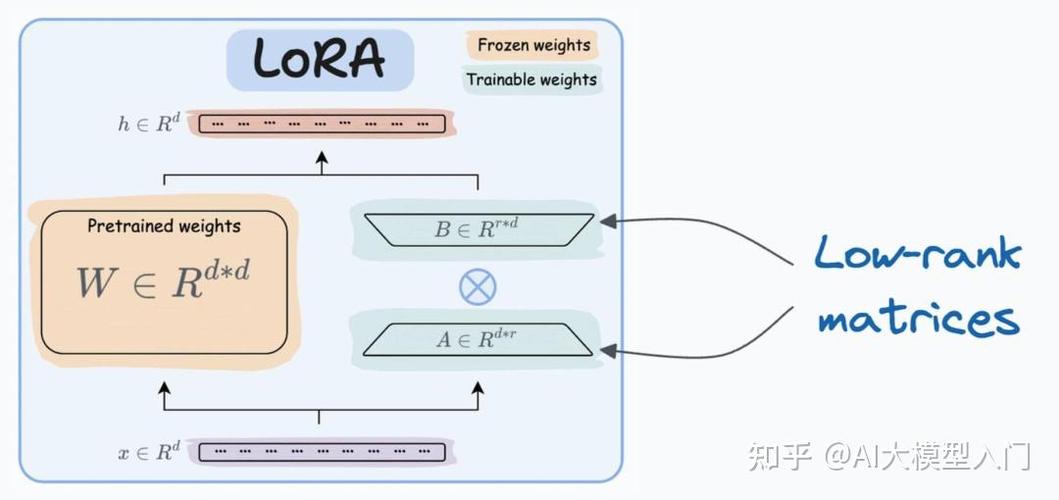
说实话,我第一次接触微调的时候,以为它就是编译一下模型然后多跑几轮。后来被现实狠狠抽了一巴掌。一个在ICLR上刷过分的预训练模型,被我微调到连中文分词都出错。那一刻我意识到,微调不是流水线,它是手术。 核心机制:从参数空间到低秩扰动 预训练...
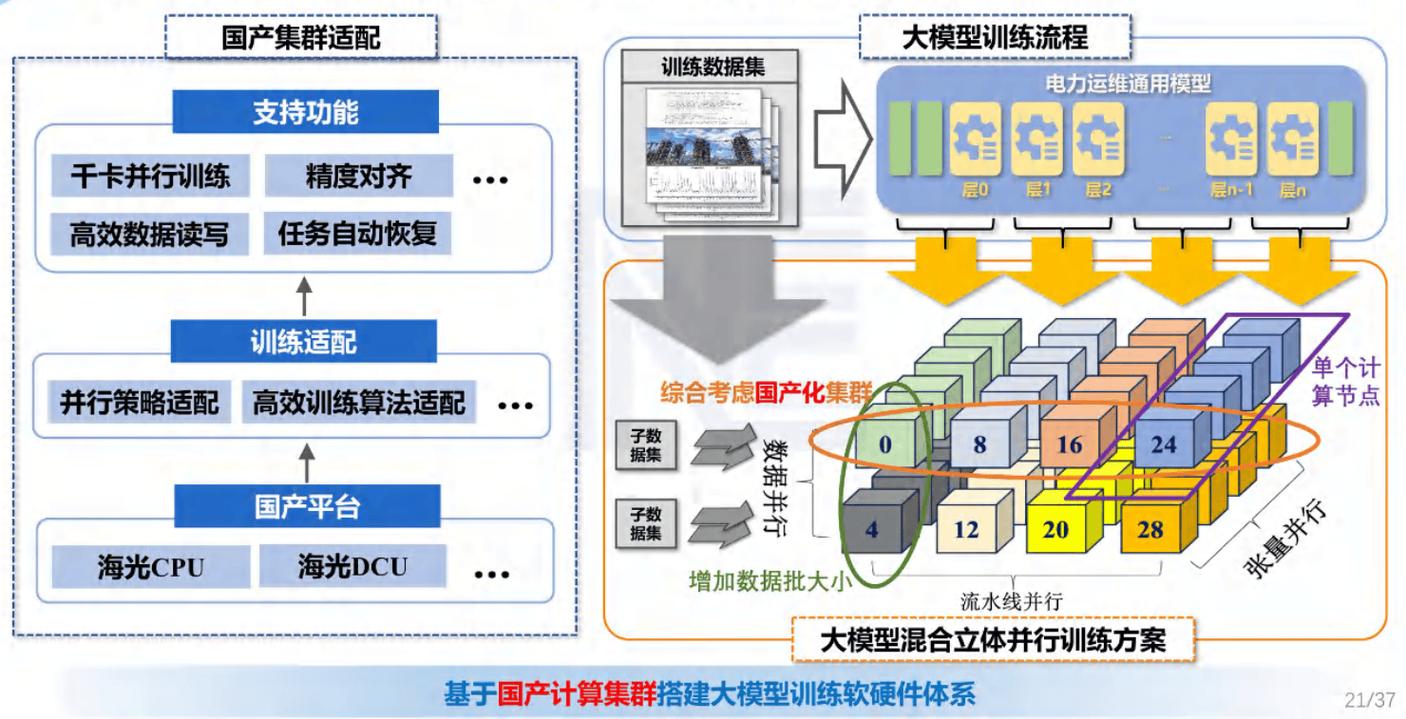
预训练。这个词在圈内已经快被嚼烂了。可真正想明白的人,没几个。你问那些拿着PPT到处融资的创业者,他们要么跟你扯智能涌现,要么跟你谈Scaling Law。说白了吧,他们只是在赌,赌自己手里的算力卡能在烧光之前换成真金白银。 但我不这么看。...
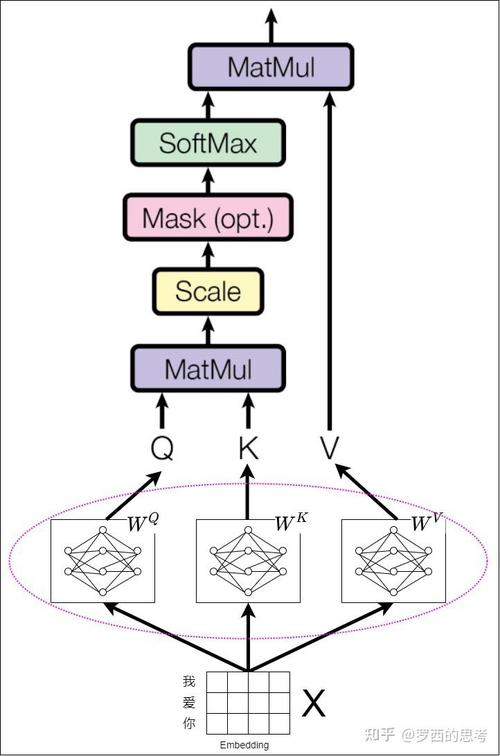
盯着终端里滚过的 token,我时常有种不真实感。这玩意儿真的知道自己在说什么吗?——后来我翻了 Transformer 论文,才明白一个事实:大语言模型根本不知道。它只是在做概率游戏,但玩得足够大,大到让人觉得它‘懂’了。就这?嗯,就这。...
说实话,过去两年,我一直在盯着这个叫LLM的东西。它已经不只是技术了。是地缘政治。是金融杠杆。是供应链的支配权。就在上周,一个客户问我:现在入场还来得及吗?我的回答是:你还没入场?晚了,但也是最早的时机。你可能觉得我疯了,但事实就是如此——...
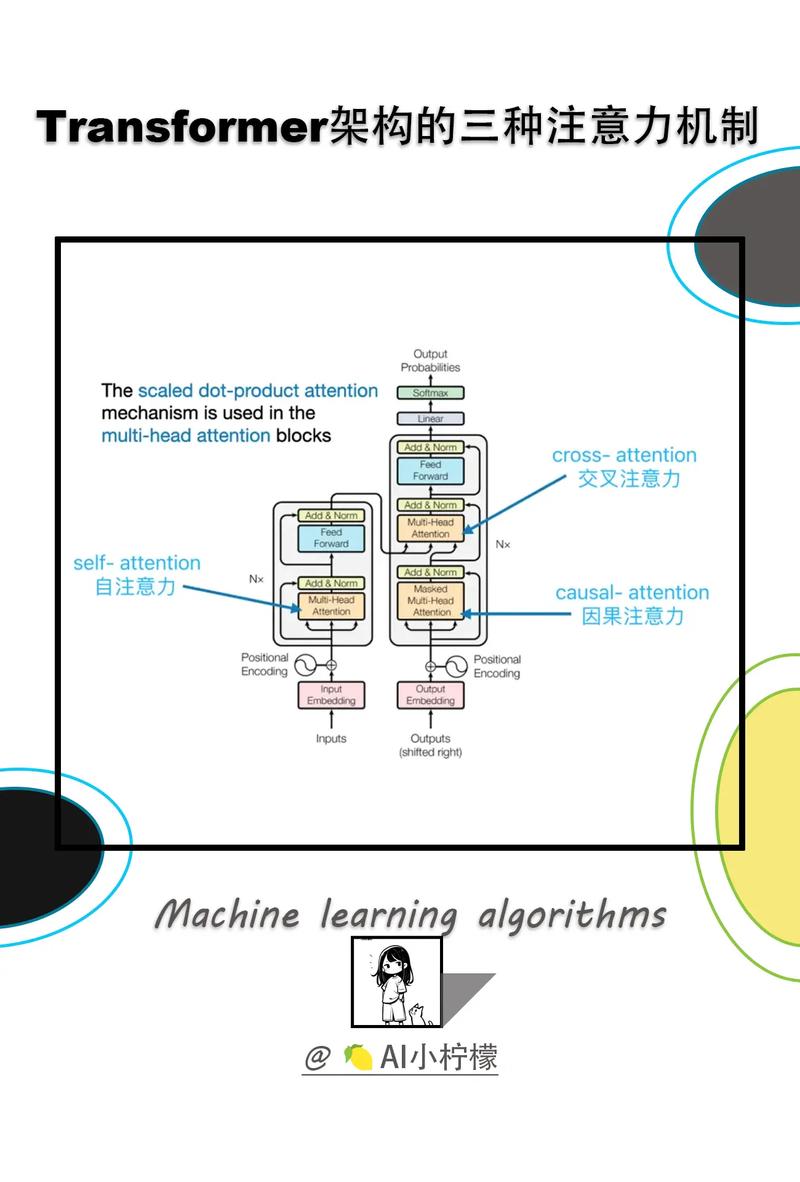
先别急着给GPT下定义。你嘴里那个GPT,跟工程现场跑的GPT,大概率不是同一个物种。我也不打算从图灵测试开始讲,那太无聊了。今天直接拆开它的脑子,看看为什么一堆矩阵乘法,能让你觉得它在“思考”。 一、注意力机制的物理意义:不是找重点,是在...
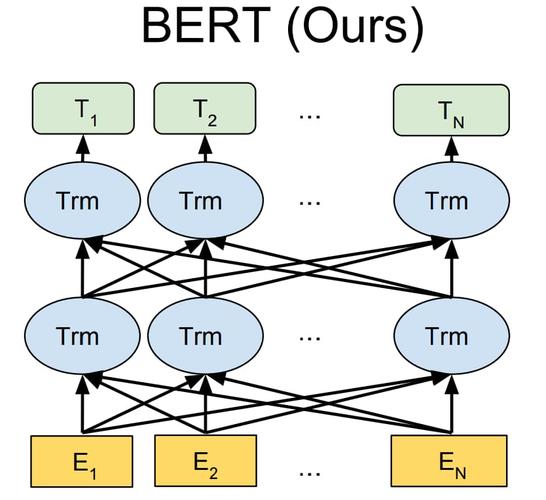
说实话,我这两年已经听腻了“BERT过时了”这类鬼话。喊这话的人,八成没做过生产环境下的NLP成本核算。你拿一个千亿参数的模型跑一遍用户意图识别试试?账单能让你半夜惊醒。 为什么现在突然要聊BERT?因为全球AI的供应链,正在从“训练狂热”...